OpenTelemetry(オープンテレメトリー、略してOTel)は、アプリケーションが残すトレース・メトリック・ログを、一つの共通方式で収集し伝達するための公開標準です。簡単に言えば、異なる機械がそれぞれ使っていた観測日誌を、同じ様式に合わせるための翻訳規則です。
しかし、LLMサービスで本当に見たいのは「モデルAPIが成功したか?」一つだけではありません。応答は遅かったが検索が遅れたのか、モデルの最初のトークンが遅れたのか、ツール呼び出しが再試行されたのか、的外れなドキュメントを検索したのかまで知る必要があります。モデル呼び出しだけを記録すると、長い旅の出発地と到着地だけを見て、途中でどこで道に迷ったのか分からないことになります。
結論から言えば、OTelをLLM可観測性の基盤として選択する方向は、現在の標準の流れに合っています。ただし、OTelの核となるトレース・メトリック体系と、LLM専用のgen_ai.*規約の成熟度は区別する必要があります。前者は幅広く安定化していますが、後者はまだ変更される可能性のある開発段階が混在しています。LGTMは、この標準を代替するものではなく、収集したデータを保存し検索するための代表的なオープンソースバックエンドの組み合わせです。
一度のユーザーリクエストが検索・モデル・ツールを経由する間、テレメトリーが全体の旅程を接続する様子。この記事のために新しく生成した画像です。
LLMサービスはなぜ既存のモニタリングだけでは不十分なのか
一般的なWeb APIは、リクエスト数、エラー率、CPU、メモリ、応答時間だけでも多くの問題を見つけることができます。LLMシステムにもこれらの指標は依然として重要です。しかし、LLMアプリケーションは通常、一度のリクエストの中でより多くの段階を経ます。
ユーザーが「当社の払い戻し規定を教えて」と尋ねたとしましょう。サービスはまず認証と安全ポリシーを確認し、質問を埋め込みに変換し、ベクトルデータベースから関連ドキュメントを検索し、プロンプトを組み合わせ、モデルを呼び出します。必要であれば社内APIや外部ツールも実行した後、応答を後処理します。
このとき、画面には単に「8秒かかった」と表示されるかもしれません。しかし、運用者が必要とする答えははるかに具体的です。
- 検索段階が5秒を費やしたのか?
- モデルが最初の文字を送信するまでに長く待たされたのか?
- ツール呼び出しが失敗し、3回再試行されたのか?
- より高価なモデルにフォールバックされ、トークンコストが増加したのか?
- 応答は速かったが、関連性のないドキュメントを根拠としたのか?
この質問に答えるには、ユーザーリクエスト一つに同じtrace_idを付与し、その中の各作業をspanに分ける必要があります。Spanは、旅全体であるTraceの中に記録された「ある区間の領収書」と考えると簡単です。開始時刻、終了時刻、成功の有無、モデル・ツールなどの属性を一緒に含みます。
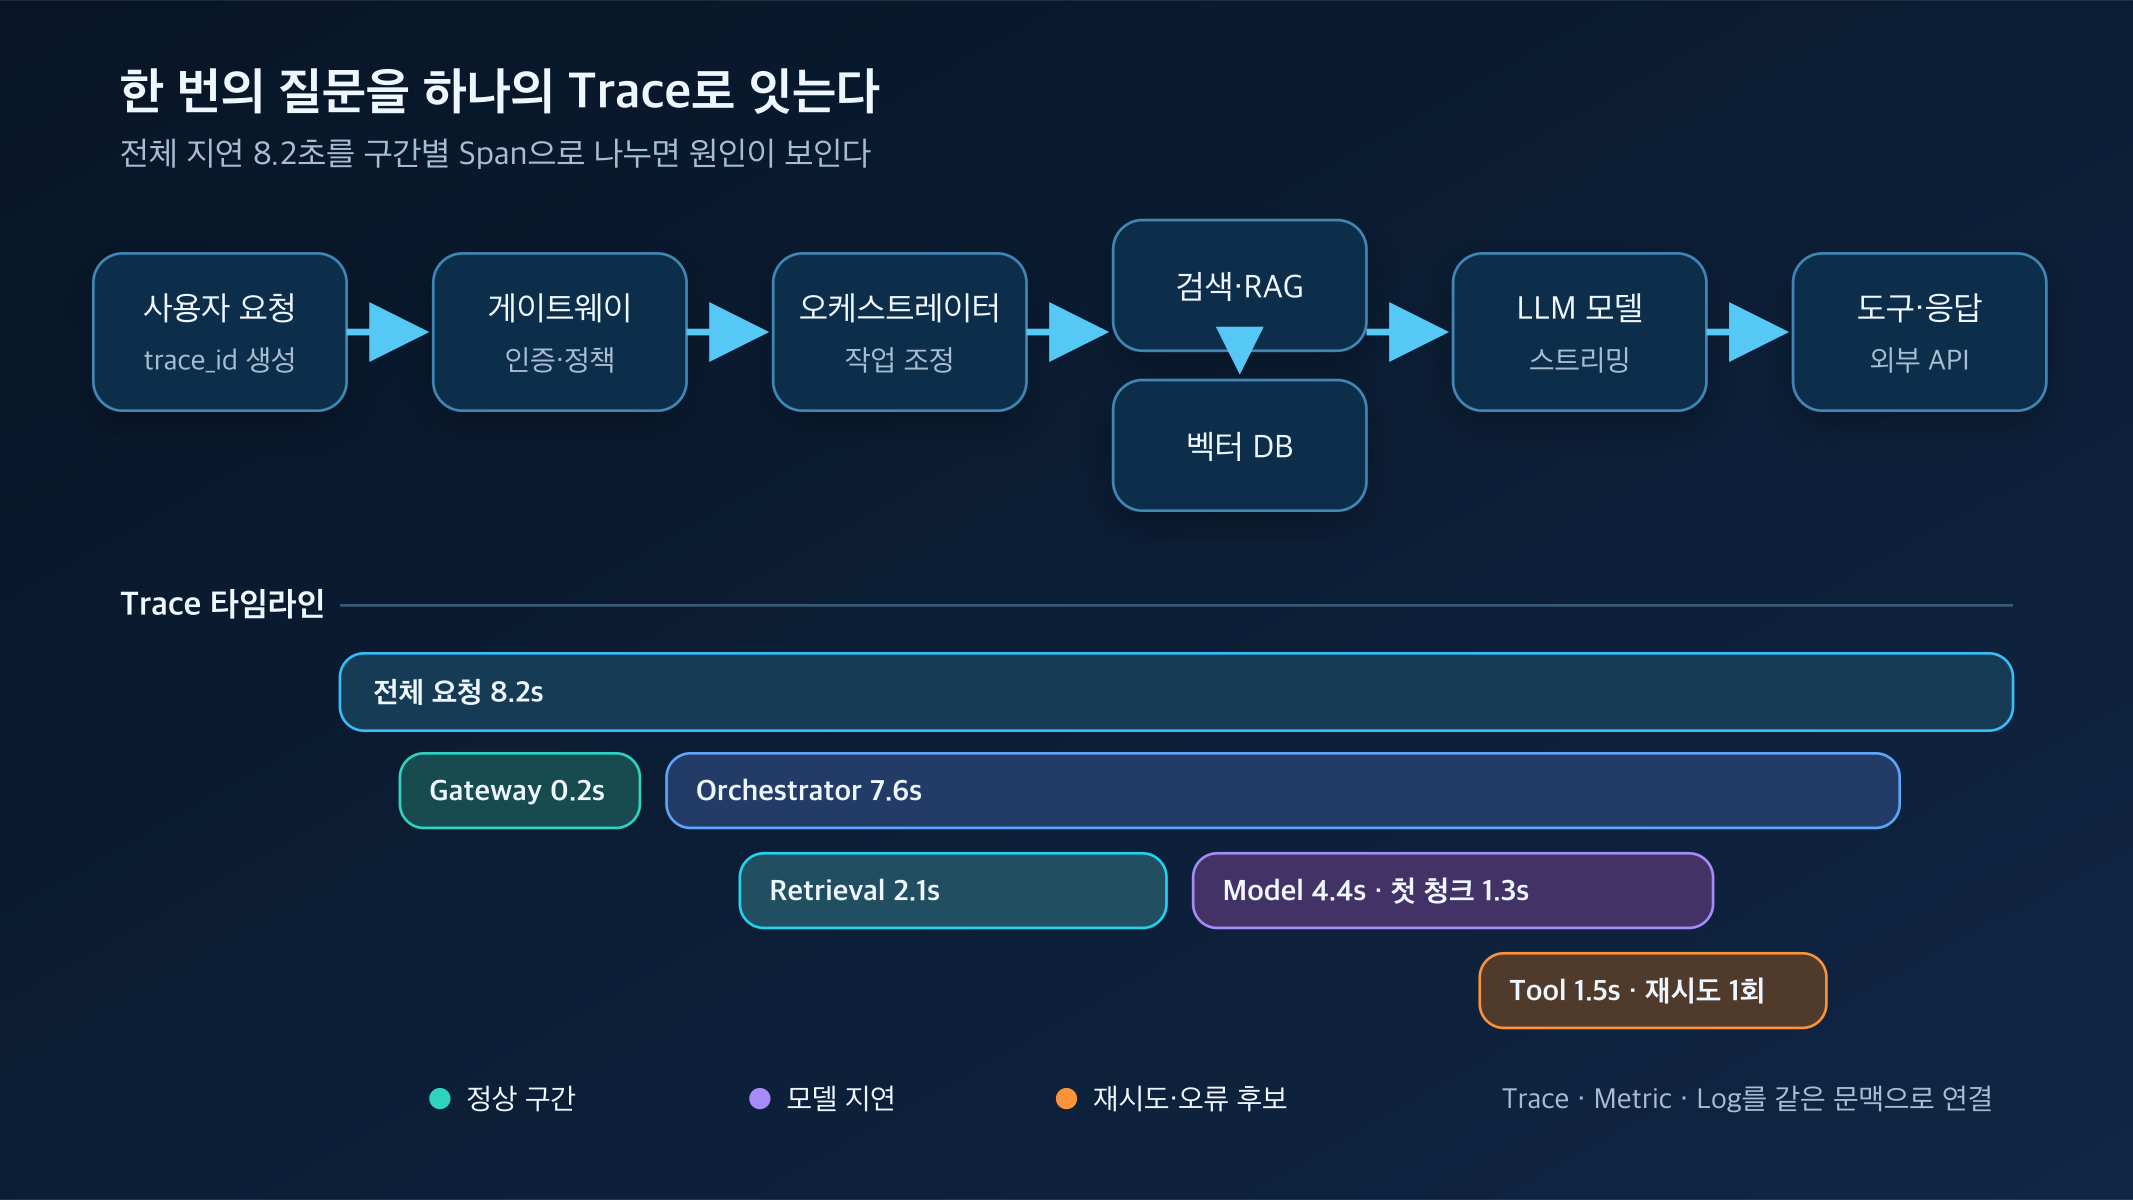
一つのリクエストを複数のSpanで繋いでみると、遅い区間と失敗地点を分離できます。OpenTelemetryのTrace・Span概念とGenAI規約を基に再構成しました。根拠:OpenTelemetry Trace概要、GenAI Span規約
OTelがしてくれることと、してくれないこと
OTelの核となる役割は、データを見る画面を作ることではありません。アプリケーションが観測データを作成し、同じ文脈で接続し、ベンダー中立的な方法で伝達するための共通言語を提供することです。
OTelは主に次の信号と接続文脈を扱います。
| 構成要素 | 簡単な意味 | LLMシステムで答える質問 |
| — | — | — |
| Trace | リクエスト一回の全体移動経路 | 検索・モデル・ツールの中でどこが遅くなったか? |
| Metric | 時間によって集計した数値 | エラー率、P95遅延、トークン使用量がどれだけ変化したか? |
| Log | 特定時点の詳細記録 | どのようなエラーとポリシー決定が発生したか? |
| Baggage·Context | サービス間に一緒に伝達される文脈 | 複数のプロセスの記録を同じリクエストとしてどのようにまとめるか? |
SDKや自動計測はアプリケーション内でデータを作成します。OTLP(OpenTelemetry Protocol)はこのデータを送信する共通の運搬規則です。OpenTelemetry Collectorはデータを受け取り、バッチ処理し、機密属性をフィルタリングし、再試行した後、一つ以上のバックエンドにエクスポートします。
したがって、OTelをインストールするだけではダッシュボードと長期保存ストレージは生成されません。OTelは計測と伝達のレイヤーであり、Tempo・Loki・Mimirのような製品は保存と検索のレイヤーです。この境界を分離することで、バックエンドを変更してもアプリケーションの計測コードを丸ごと作り直す可能性が減ります。
LLMでは何を観測すべきか
LLMモニタリングは「すべてを記録しよう」ではなく、障害とコストと品質を説明するための最小限の信号を定めることです。
1. エンドツーエンド遅延と最初の応答時間
全体の応答時間だけを見ると、ストリーミングサービスの体感速度を見逃します。ユーザーは最後のトークンが到着した時刻よりも、最初のトークンや最初のチャンクがいつ表示されたかにより敏感かもしれません。そのため、全体の作業時間とともにTTFT(Time to First Token)または最初のチャンクまでの時間を分離して見る必要があります。
現在のGenAI規約には、作業時間、リクエストモデル、応答モデル、入力・出力トークン、ストリーミングの最初のチャンク時間などを表現する属性とメトリックが定義されています。ただし、実際のサポート範囲は言語と計測ライブラリによって異なるため、名前だけで収集されると仮定せず、サンプルTraceで確認する必要があります。
2. モデル・プロバイダー・フォールバック経路
リクエストしたモデルと実際に応答したモデルが異なる場合があります。ルーターが障害や制限超過のために、別のプロバイダーやより高価なモデルに切り替えた可能性もあります。Spanに作業名、プロバイダー、リクエストモデル、応答モデル、エラータイプを残すことで、「成功率は同じなのにコストが増えたのはなぜか?」を追跡しやすくなります。
トークン数はコストを推定する重要な材料ですが、トークン数自体が金額ではありません。プロバイダー・モデル・キャッシュポリシー・契約によって価格が異なるため、価格表と計算規則は別途バージョン管理されたコストレイヤーで適用する方が安全です。
3. RAG検索とツール呼び出し
良くない応答が常にモデルのせいとは限りません。検索結果が空だったり、古いドキュメントを取得したり、ツールが誤った引数を受け取ったりした可能性があります。RAGであれば、検索時間、結果数、データソース、再ランキング段階、選択されたドキュメント識別子を接続し、ツール呼び出しであれば、ツール名、遅延、成功の有無、再試行回数を記録します。
ただし、原文ドキュメントとツール引数・結果を無条件に一般的なTraceストレージに入れるべきではありません。個人情報、社内秘密、認証情報が混入する可能性があるためです。運用環境では、内容の代わりにアクセス制御が分離されたストレージの参照値や非識別識別子を残す方式がより適切です。
4. 品質と安全性
OTelは「この作業がいつ、どこで、どれくらいかかって実行されたか?」を接続するのに強いです。一方、「応答が事実か?」「根拠と一致するか?」「ユーザーに有用か?」はアプリケーションごとの評価基準が必要です。
したがって、可観測性と評価(Evaluation)を同じものとして扱わない方が良いです。オンラインフィードバック、オフライン正解セット、根拠性・関連性評価、安全性検査を別途運用しつつ、評価結果をTraceまたは会話識別子と接続することで、「品質が低下したリクエストがどのような実行経路を辿ったか?」まで調査できます。OTelは品質評価エンジンではなく、異なる証拠を接続する背骨に近いものです。
それでOTelは今の標準に合っているのか
短く答えると、観測データの計測・文脈伝播・伝達基盤としては合っています。OpenTelemetryはOpenTracingとOpenCensusの流れを統合して成長し、2026年5月にCNCF Graduatedプロジェクトになりました。主要言語のTraceとMetric API・SDKも概ねStable状態であり、OTLPとCollectorをサポートするオープンソース・商用バックエンドが広く形成されています。
しかし、「OTelのすべての機能とすべての属性名が永久に固定された」という意味ではありません。
- 言語別のログ信号の成熟度はそれぞれ異なります。
- Collectorは構成要素ごとに安定性レベルが異なるMixed状態です。
- LLM・エージェント用のGenAI Semantic Conventionsは別途リポジトリに分離されて発展中であり、Span・Event文書にはDevelopment状態が残っています。
- 実際の計測ライブラリごとにサポートするプロバイダーと属性範囲が異なります。
そのため、実務上の結論は二文です。新しいLLMプラットフォームの共通計測・伝達規約はOTel/OTLPで定めても良いでしょう。ただし、gen_ai.*属性は使用する規約バージョンとライブラリを固定し、内部データモデルとダッシュボードの間に薄い変換レイヤーを置いて変更に備える必要があります。
LGTMはOTelとどのような関係なのか
LGTMはLoki, Grafana, Tempo, Mimirの頭文字を合わせた名前です。
- Lokiはログを保存し検索します。
- Grafanaは複数のデータソースを探索し可視化します。
- Tempoは分散Traceを保存し検索します。
- MimirはPrometheus互換メトリックを長期保存します。
つまり、LGTMはテレメトリーの意味と転送方式を定める産業標準ではありません。OTelで作成したデータを受け取り、運用しやすいGrafanaエコシステムのバックエンドの組み合わせです。OpenSearch、Elastic、Jaeger、Prometheus、クラウド管理型サービスや商用可観測性プラットフォームを選択しても、OTelレイヤーはそのまま維持できます。
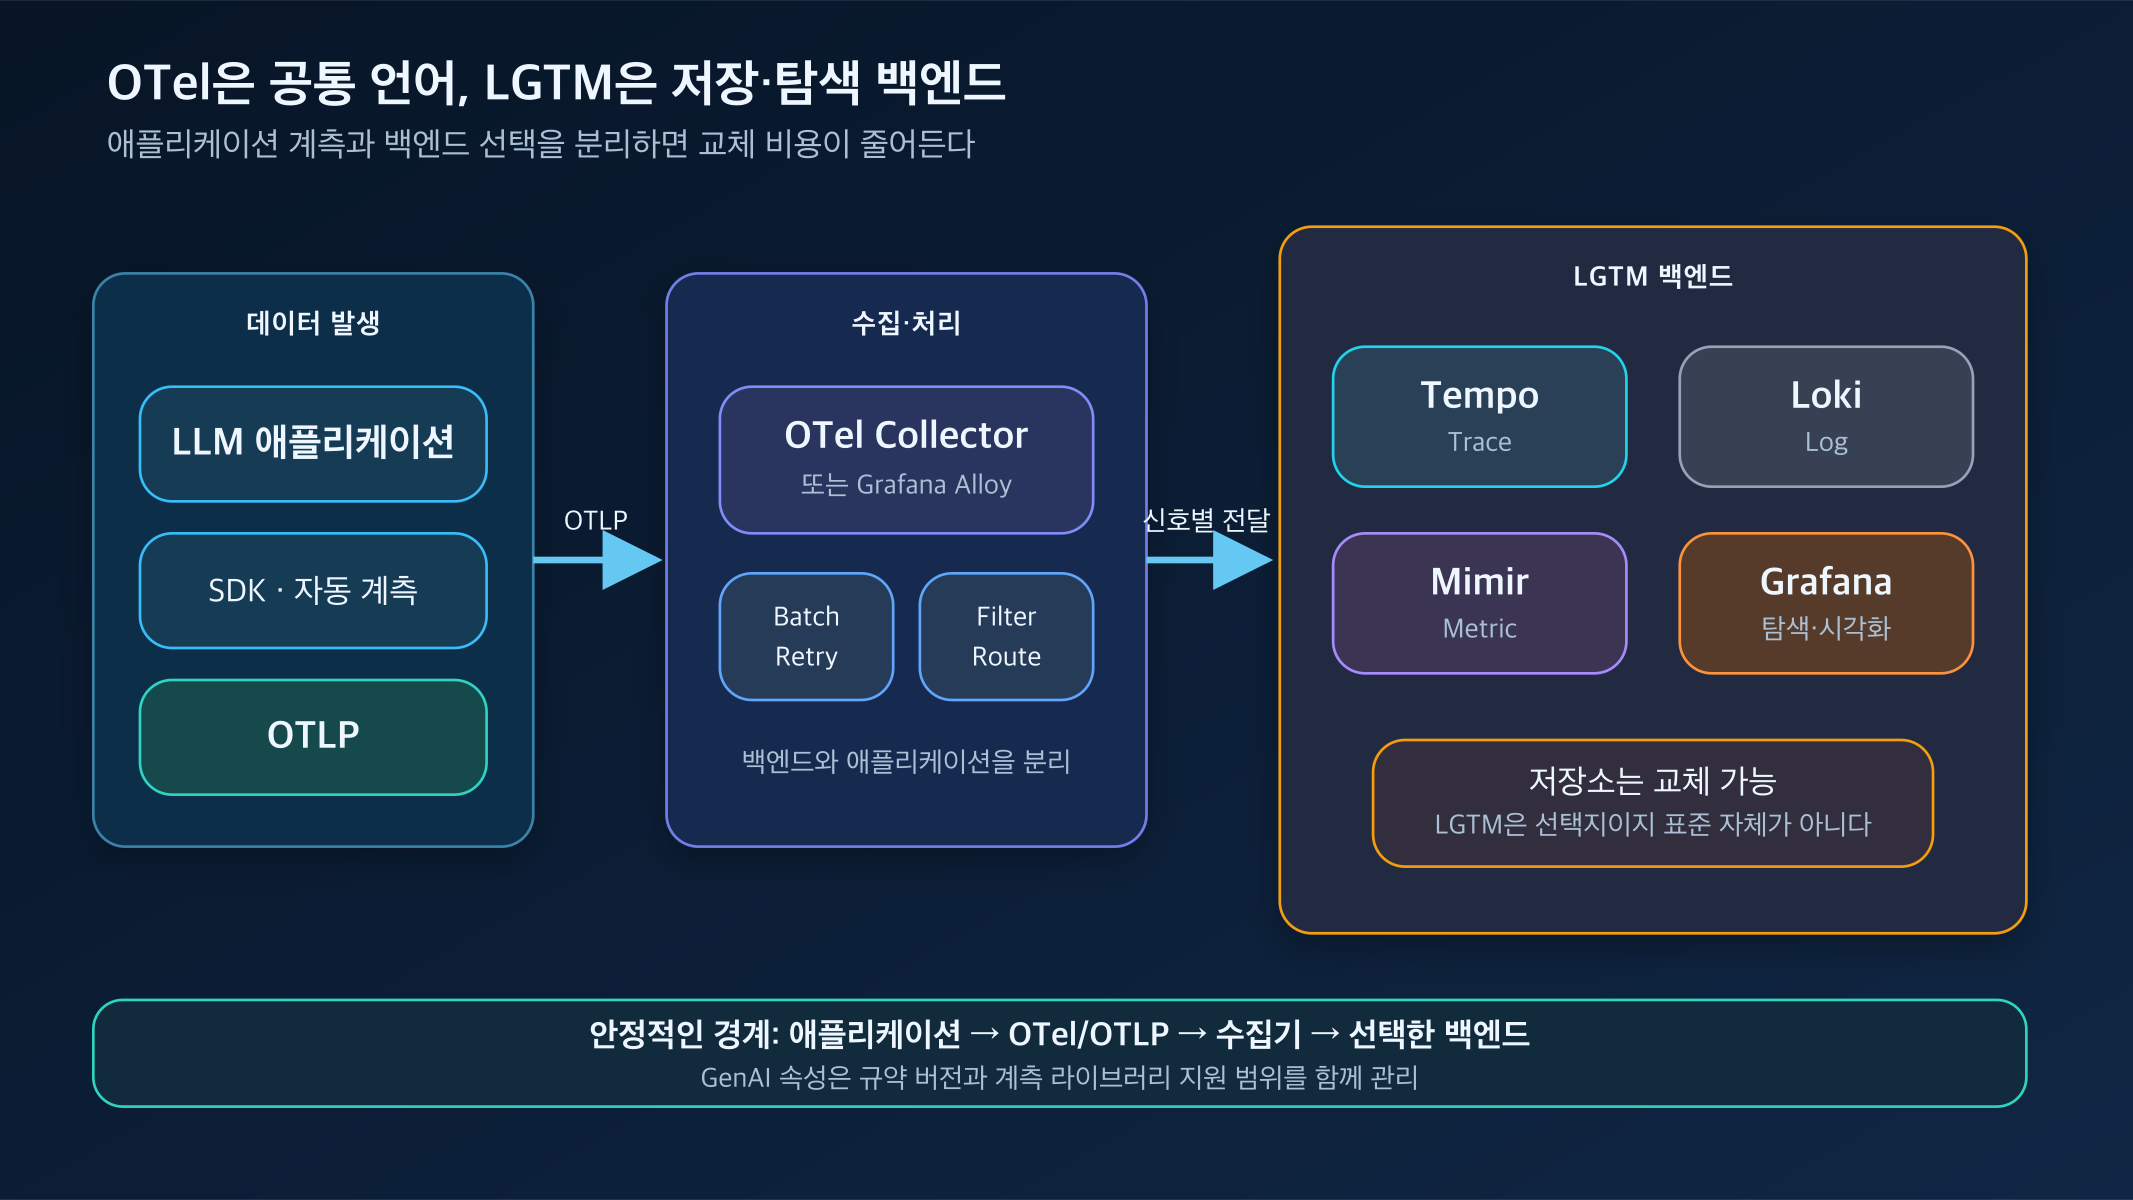
アプリケーションはOTLPでCollectorまたはAlloyに送り、LGTMは信号別の保存・検索役割を担います。Grafana公式ドキュメントを基に再構成しました。根拠:Grafana Alloyの動作方式、Docker OpenTelemetry LGTM
収集レイヤーでは、純粋なOpenTelemetry Collectorを使うこともできますし、Grafana Alloyを使うこともできます。AlloyはOpenTelemetry Collectorと互換性のある収集パイプラインと、Prometheus・Lokiエコシステムの機能を一緒に提供します。Grafanaを中心に運用するなら自然な選択ですが、これもOTelの必須構成要素ではありません。
開発・デモ環境では、Grafanaが提供するdocker-otel-lgtmイメージでCollector、Grafana、Loki、Mimir、Tempoを一度に試すことができます。公式ドキュメントもこのイメージを開発・デモ・テスト用として説明しているため、その構成をそのまま大規模運用環境の正解としてコピーすべきではありません。
実務ではどのような順序で始めるべきか
最初からすべてのプロンプトとすべてのSpanを保存すると、コストとセキュリティの問題に直面します。次のように小さな垂直方向の断片から始める方が良いでしょう。
- サービス境界をまず接続します。API Gateway、LLM Orchestrator、Retriever、Model Client、Tool Runnerに同じTraceコンテキストが伝達されることを確認します。
- 運用上の質問を定めます。P95全体遅延、最初の応答時間、モデル・プロバイダー別のエラー率、入力・出力トークン、フォールバック率、検索・ツール失敗率など、実際に行動を変える指標から選びます。
- OTLP出口を一つにまとめます。アプリケーションがバックエンドアドレスを直接知るのではなく、CollectorやAlloyがバッチ処理・再試行・フィルタリング・ルーティングを担当するようにします。
- LGTMまたは他のバックエンドに接続します。Traceから関連ログとメトリックに移動できるように、trace_id、サービス名、環境属性を一貫して維持します。
- 実際の失敗で検証します。モデルのタイムアウト、検索遅延、ツールエラー、フォールバックを意図的に発生させ、どのSpanで表示されるかを確認します。
- 次に品質評価を接続します。低いユーザー評価や根拠性失敗が発生したリクエストをTraceで遡れるようにします。
ダッシュボードは「存在するデータをすべて描画する場所」ではなく、運用上の意思決定を迅速に行うための画面であるべきです。例えば、最初の画面にはユーザー体感遅延、エラー率、トークン使用量、フォールバック率を置き、異常が発生したときにTraceにドリルダウンして検索・モデル・ツールの中から原因を探す構造が実用的です。
必ず最初に定めるべきセキュリティとコストの境界
LLMテレメトリーは一般的なWebログよりも機密性が高い場合があります。プロンプトには名前、メールアドレス、契約情報、ソースコードが含まれる可能性があり、モデル応答やツール結果には内部データが含まれる可能性があります。
OpenTelemetryのGenAIドキュメントも、システム指示文、入力メッセージ、出力メッセージを機密性の高い大きなデータと見なし、デフォルトでは収集しないことを推奨しています。必要な場合にのみ明示的に有効にし、運用環境では内容を別途ストレージに保存し、Spanには参照を残す方式を提示しています。
次の原則は、導入前にポリシーとして固定することをお勧めします。
- プロンプトと応答本文はデフォルトでは収集しません。
- 個人情報と認証情報はSDKまたはCollectorで削除します。
- モデル・ユーザーIDのようにカーディナリティが大きい値は、Metric Labelとして無分別に使用しません。
- 正常なリクエストはサンプリングし、エラー、高遅延、重要な評価失敗は保存するポリシーを検討します。
- Traceストレージと原文ストレージのアクセス権限・保存期間を分離します。
- テレメトリーの損失とCollector自体の障害も別途メトリックで監視します。
まとめ
LLMシステムの障害は、モデル呼び出しの一行だけで発生するわけではありません。検索、ルーティング、安全ポリシー、ツール、外部APIが協力して一つの応答を作成するため、運用者はこの全体の旅程を一つのリクエストとして見ることができなければなりません。
OTelは、その旅程を共通言語で接続するための現在の最も安全な基盤選択です。LGTMは、そのデータをオープンソースで保存し探索しようとする際に最適な代表的な組み合わせです。ただし、核となるOTelの成熟度をGenAI専用規約の完全な安定化と拡大解釈すべきではありません。
最も現実的な出発点は、OTel/OTLPをプラットフォームの境界として定め、LLM専用属性はバージョン管理し、プロンプト本文はデフォルトで収集しないことです。この3点を守れば、特定のモデルプロバイダーや可観測性バックエンドを変更しても再利用可能なモニタリング基盤を構築できます。
コメントを残す