こんにちは! 👋 IT技術ブログを読んだり、DevOpsやSREに関する会話をしていると、SLI、SLO、SLAのような聞き慣れない用語に首をかしげたことはありませんか?「サービス品質が重要だとはわかるけど、結局これってどういう意味?」と思っている方のために準備しました。
今日は、サービス安定性の核心指標であるサービス品質の三銃士、SLI、SLO、SLAについて学びます。複雑な概念は一旦忘れて、近所のピザ屋さんの話に耳を傾けてみてください。🍕あっという間にすべての概念を完璧に理解できるようになるでしょう!
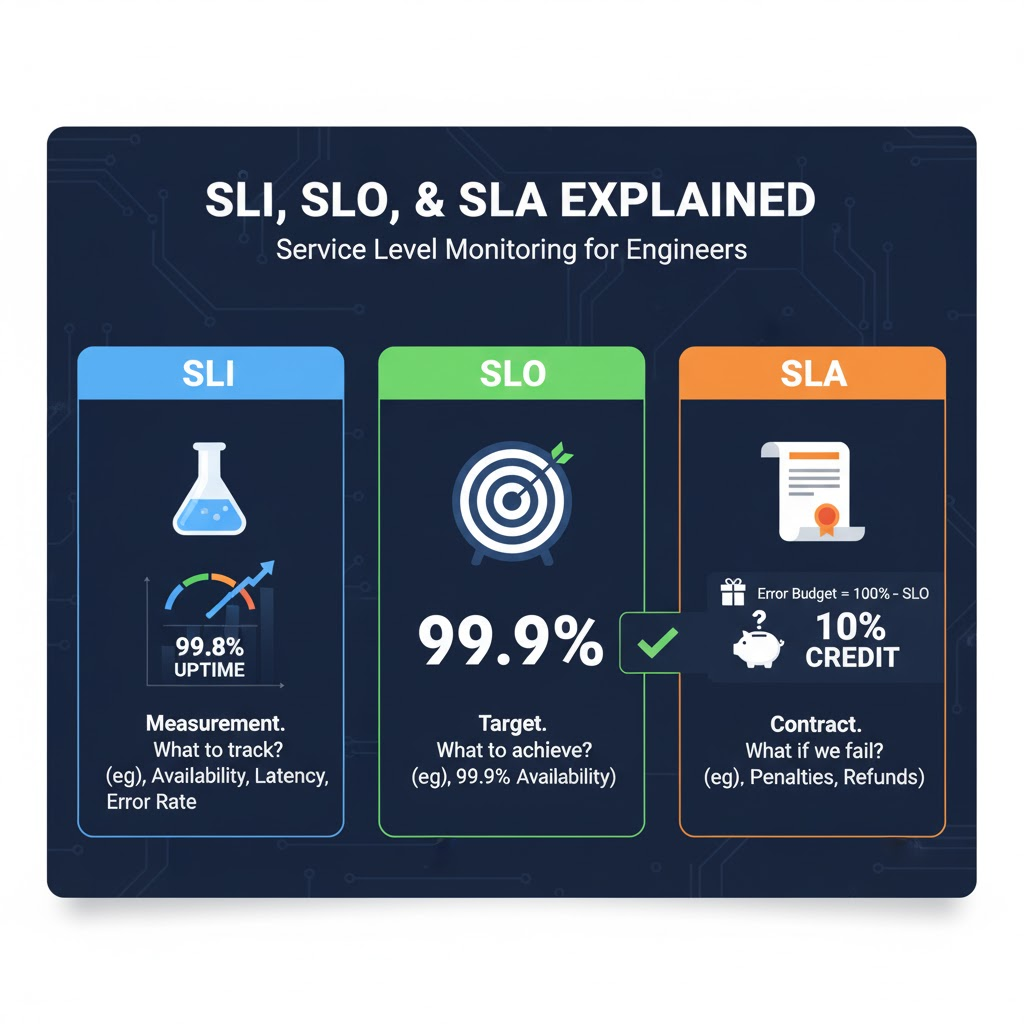
📈 サービス品質の三銃士:SLI、SLO、SLAをご紹介します!
これら三つの用語はそれぞれ独立した概念ではなく、互いに密接に連携しています。サービスの品質を測定し(SLI)、目標を設定し(SLO)、顧客と約束する(SLA)という流れで理解すると非常に簡単です。さあ、一人ずつ見ていきましょう!
1. 🔬 SLI (Service Level Indicator) – サービスレベル指標
最も基本的なSLIは、「サービスの健康状態を示す計器盤」と考えると良いでしょう。私たちのサービスの品質を定量的に測定するための指標そのものです。
- 🤔 核心質問:「私たちは何を測定すべきか?」
- 🏥 比喩:病院の体温計、血圧計
- 役割:具体的な数字で現在の状態を客観的に示します。
主なSLIの例:
- 可用性 (Availability):サービスがどれくらいの期間、正常に動作したか?
- 測定方法:(成功したリクエスト数 / 全体のリクエスト数)* 100
- 遅延時間 (Latency):ユーザーがリクエストを送信してから応答を受け取るまでにどれくらい時間がかかったか?
- 測定方法:APIリクエスト処理時間 (ms)
- エラー率 (Error Rate):リクエストのうち、どれくらいのリクエストが失敗したか?
- 測定方法:(5xxエラー発生数 / 全体のリクエスト数)* 100
SLIは漠然と「私たちのサービスは速い」と言うのではなく、「私たちのサービスの平均応答時間は150msだ」と具体的に言えるようにする基準点です。
2. 🎯 SLO (Service Level Objective) – サービスレベル目標
SLOは、上で測定したSLIに基づいて私たちが達成しようとする具体的な目標値です。これは外部に公開される約束というよりは、開発チームと運用チームが守るべき内部的な品質目標です。
- 🤔 核心質問:「測定された値がどのレベルであればユーザーは満足するだろうか?」
- 🌡️ 比喩:「室温を常に24度に保とう!」という目標温度設定
- 役割:漠然とした「改善」ではなく、明確な目標を提示し、チームの方向性を定めます。
主なSLOの例:
- 「月間可用性(SLI)は99.9%以上でなければならない。」 (Four Nines)
- 「ホームページ接続リクエストの95%は300ms以内に処理されなければならない。」
- 「決済APIのエラー率(SLI)は0.1%未満に維持しなければならない。」
SLOは「ユーザーが不便を感じないギリギリのライン」を設定するものと言えます。
3. ✍️ SLA (Service Level Agreement) – サービスレベル契約
SLAは、私たちが定めた目標(SLO)を守れなかった場合にどのような責任を負うのか、顧客と結ぶ公式的な契約です。万が一の事態に対する補償案が含まれた、法的効力を持つ約束です。
- 🤔 核心質問:「目標を守れなかったら顧客に何をしてあげるべきか?」
- 📜 比喩:「目標温度を達成できなかった場合、冷房料金を10%返金します」という契約書
- 役割:顧客にサービス品質に対する信頼を与え、ビジネスを保護する装置です。
SLAの例:
- 「月間可用性が99.9%(SLO)に満たない場合、翌月のサービス利用料の10%を返金いたします。」
通常、SLAはビジネスを保護するために、内部目標であるSLOよりも少し余裕のある数値で設定されます。
🍕 理解が深まる!近所のピザ屋さんのお話
まだ混乱しているなら、このピザ屋さんの話に集中してみてください!
- 🔬 SLI (指標):注文が入った瞬間から顧客にピザが届けられるまでの「実際の配達時間」を一つ一つ測定します。(例:25分、32分、18分…)
- 🎯 SLO (内部目標):店長は店の品質維持のために「全配達注文の95%は30分以内に完了する!」という内部目標を立てます。この目標のために、厨房の動線や配達システムを継続的に改善します。
- ✍️ SLA (顧客との契約):チラシには「40分以内に配達されなければピザは無料!」と広告します。顧客にはこの約束を通じてサービス品質に対する確信を与えます。(内部目標の30分よりも10分の余裕を持たせていますね!)
どうですか?これで三つの関係が明確に描かれましたか?
👑 SLOの核心、「エラーバジェット(Error Budget)」をご存知ですか?
SLOを設定すると、非常に強力な武器、「エラーバジェット」が生まれます。
- エラーバジェット = 100% – SLO
もし私たちのサービスの可用性SLOが99.9%なら、エラーバジェットは0.1%になります。1ヶ月(30日)を基準にすると、約43分の時間が与えられることになります。
この43分は、私たちのサービスが「失敗しても許される時間」です。開発チームはこの予算内で新しい機能をデプロイしてリスクを冒すこともできますし、システム点検のために一時的にサービスを停止することもできます。
もし障害が発生してこのエラーバジェットをすべて使い果たしてしまったら? 🚨 その時は、すべての新規機能開発を停止し、サービス安定化作業にのみ集中しなければならないという強力なデータに基づいた意思決定を下すことができます。つまり、エラーバジェットは「革新の速度」と「サービスの安定性」の間で賢い綱引きを可能にする最高のツールなのです。
終わりに
これでSLI、SLO、SLAはもう難しい暗号ではないでしょう。
- SLIで私たちのサービスの健康を測定し、
- SLOでユーザーが満足する目標を立て、
- SLAで顧客に信頼を約束すること。
これら三つの概念は、漠然とした感覚に頼っていたサービス管理をデータに基づいた科学的な領域へと導く核心的な鍵です。皆さんのサービスにも今日学んだ概念を適用し、ユーザーと開発チームの両方が幸せなサービスを築いていかれることを願っています!
タグ: SLO, SLI, SLA, SRE, DevOps, サービスレベル目標, エラーバジェット, Observability, モニタリング
コメントを残す