こんにちは!👋 Prometheusを導入して、基本的なノードやデータベースのモニタリングは始められましたか?もしそうなら、次のステップはまさに「私たちのアプリケーションに直接メトリックを埋め込むこと」、つまりインスツルメンテーション(Instrumentation)でしょう。
しかし、いざ始めようとすると、「メトリックの名前はどうしよう?」「どのタイプを使えばいい?」「ラベルは自由に追加してもいいの?」といった悩みに陥りがちです。
今日は、皆さんの悩みを解消し、「Prometheusを使いこなしているね!」と言われるようなアプリケーションインスツルメンテーションの主要なベストプラクティスを分かりやすくまとめてご紹介します!
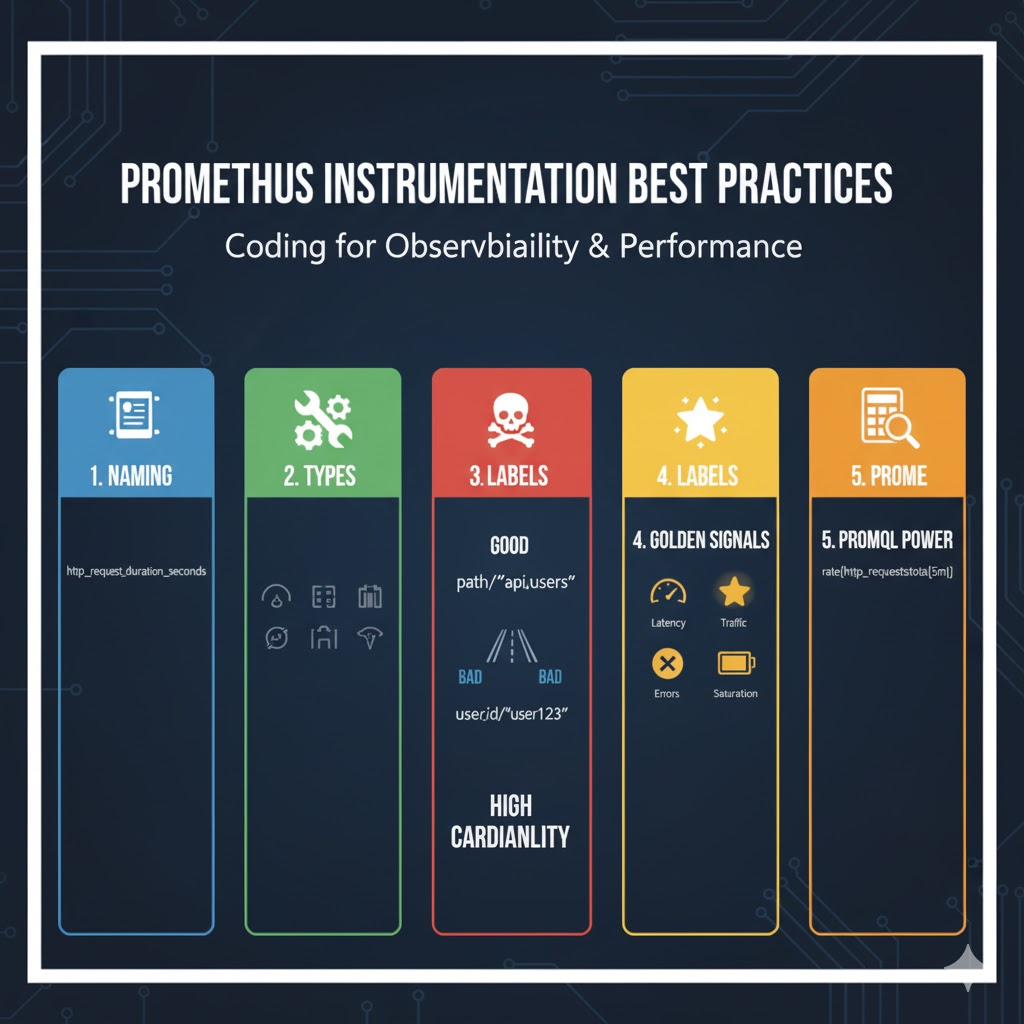
1. 一貫性のある命名:将来のための最高の投資
最も基本的でありながら、最も重要なルールです。メトリック名がバラバラだと、後でPromQLでクエリする際に大きな混乱が生じます。以下の標準的な命名規則に従うことをお勧めします。
[ライブラリ/アプリケーション接頭辞]_[測定対象]_[単位]
- 接頭辞 (Prefix): どのアプリケーションやライブラリのメトリックであるかを明確にします。(例: http_, prometheus_, api_)
- 測定対象 (Metric Name): 何を測定しているかを明確に示します。(例: requests_total, request_duration_seconds)
- 単位 (Unit): メトリックの単位を明示します。特に時間を表す場合はseconds、データサイズはbytesのように基本単位を使用することを強く推奨します。(ms, KBの代わりに)
✅ 良い例:
- api_http_requests_total: APIサーバーへのHTTPリクエスト総数 (カウンターは_total接尾辞)
- process_resident_memory_bytes: プロセスの物理メモリ使用量 (バイト単位)
- http_request_duration_seconds: HTTPリクエスト処理時間 (秒単位)
❌ 悪い例:
- requests: 何のリクエストか不明。
- memory: 単位がなく、MBかKBか不明。
- http_latency_ms: 基本単位ではないミリ秒(ms)を使用。
2. 適切なメトリックタイプの選択:正しいツールの使用 🛠️
Prometheusには4つのメトリックタイプがあります。状況に合ったタイプを選択することで、データの意味が正確になります。
- カウンター (Counter) 📈: 増加する一方の値に使用します。(例: 累積リクエスト数、累積エラー数)
- rate()、increase()関数と組み合わせて「1分あたりのリクエスト数」などを計算します。
- ゲージ (Gauge) 🌡️: 値が上下する現在の状態値に使用します。(例: 現在の接続者数、CPU使用率、キューに積まれた作業数)
- ヒストグラム (Histogram) 📊: 観測値の分布を把握する際に使用します。主に応答時間(Latency)の測定に用いられます。
- histogram_quantile()関数で「リクエストの95%は何秒以内に処理されたか?」といったパーセンタイル計算に最適化されています。ほとんどの応答時間測定にはヒストグラムが正解です。
- サマリー (Summary) 📝: ヒストグラムに似ていますが、クライアント側で直接パーセンタイルを計算します。集計が難しいため、特殊な場合を除きヒストグラムの使用が推奨されます。
3. ⚠️ 最も重要!ラベルとカーディナリティの管理
ラベル(Label)はPrometheusの強力な機能ですが、誤って使用するとサーバーを破壊する可能性もある諸刃の剣です。核心はカーディナリティ(Cardinality)を管理することです。
カーディナリティとは、ラベル値のユニークな組み合わせがいくつあるかを示す尺度です。
- 低いカーディナリティ (Low Cardinality) 👍: ラベル値の種類が限定的です。(例: method=”GET”, “POST”, status=”200″, “404”, “500”)
- 高いカーディナリティ (High Cardinality) 💣: ユーザーID、メールアドレス、セッションID、リクエストIDのように無限に増えうる値をラベルとして使用する場合です。
高いカーディナリティは、Prometheusサーバーのメモリ使用量を爆発的に増加させ、パフォーマンスを著しく低下させる主犯です! 決してユニークな識別子をラベル値として使用してはいけません。
✅ 良いラベル
例: http_requests_total{method=”POST”, path=”/api/v1/login”, status=”200″} (method, path, statusは種類が限定的です。)
❌ 絶対に避けるべきラベル
例: http_requests_total{user_id=”user12345″, session_id=”a1b2c3d4e5f6g7″} (ユーザーが増えるたびに新しい時系列(time series)が無限に生成されます。)
4. 何を測定すべきか?4つのゴールデンシグナル (Four Golden Signals) ✨
「では、一体何を測定すべきですか?」という問いに対する最高の答えは、Google SREが提唱する「4つのゴールデンシグナル」です。ユーザー体験に直接影響を与えるこれら4つの指標を中心に測定すれば、失敗することはありません。
- 遅延時間 (Latency) 🐢: リクエストの処理にかかる時間。成功したリクエストと失敗したリクエストの時間を区別して測定することが重要です。
- トラフィック (Traffic) 🚦: サービスが受けているリクエストの量。(例: 1秒あたりのHTTPリクエスト数)
- エラー (Errors) 💥: 失敗したリクエストの割合。システムで発生するあらゆる種類のエラーを明示的に追跡する必要があります。
- 飽和度 (Saturation) 🈵: サービスがどれだけ「満杯か」を示す指標。CPU、メモリ、ディスク容量など、システムの最も制約の厳しいリソースの負荷を測定します。
5. 計算はPromQLに任せる:アプリケーションはシンプルに 🧠
アプリケーションコードで複雑な計算を行わないでください。「1秒あたりのリクエスト数」のような比率を計算してメトリックとして公開する必要はありません。
- アプリケーションの役割: ひたすら生データ(raw data)を公開することに集中します。リクエストが来るたびにカウンターを1ずつ増やすだけで十分です。(http_requests_total.inc())
- PromQLの役割: rate(http_requests_total[5m])のように、強力なクエリ言語であるPromQLを使用して、必要なすべての計算、集計、分析を実行します。
このように役割を分離することで、アプリケーションコードはシンプルになり、収集されたデータははるかに柔軟に活用できるようになります。
終わりに
優れたモニタリングシステムは、適切に構築された可観測性(Observability)から始まり、その第一歩は正しい方法でメトリックを埋め込むことです。今日ご紹介した5つのベストプラクティスをぜひ覚えて、安定的で分析しやすいモニタリング環境を構築してください!
タグ: Prometheus, モニタリング, Instrumentation, ベストプラクティス, SRE, DevOps, Observability, カーディナリティ
コメントを残す