GPT‑6.1 SolはOpenAIのAIモデル名です。既存のGPT‑6 Solから切り替えるべきか悩んでいるなら、繰り返しのコーディング・文書作業から同じ条件で比較してみる価値があります。ただし、名前の数字が上がったという理由だけで、すべての作業がより正確になったり速くなったりしたと判断するのは難しいです。
この記事は、2026年10月4日に確認した公式文書を基に選択基準を整理します。実際のモデルを呼び出した性能実験や使用後記ではありません。公式説明、公開価格、今後直接確認する項目に分けて説明します。
まずモデルの役割を区別しよう
OpenAIはGPT‑6.1 Solを、複雑な作業においてAstraに近い性能をより低いコストで提供するモデルと説明しています。繰り返しの長いコーディング・アプリ・文書作業に検討し、最も難しい作業にはAstraを残しておくという方向性です。Lunaは範囲が明確な繰り返し作業の選択肢です。これは製品の用途説明であり、特定のプロジェクトで同じ結果が出ることを保証するものではありません。 公式モデル選択案内
モデルを選ぶ際に重要なのは、作業の名前よりも失敗した時の負担です。ブログの文章を整えるのは修正しやすいですが、根拠のない技術説明が混ざると再調査が必要です。コーディングも短い関数作成と、複数のサービスが絡む障害分析では、要求される判断が異なります。一つのモデルで全てを統一するよりも、検証コストまで含めて分ける方が判断しやすいです。
| 作業 | まず比較する選択肢 | 人が確認する部分 |
| — | — | — |
| テストがある小さなコード修正 | 既存の6 Solと6.1 Sol | テスト結果、変更範囲 |
| 複数の資料をまとめる文書の草案 | 6.1 Sol | 漏れ、数値、出典の連結 |
| 制約が多い複雑な設計 | 6.1 SolとAstra | 前提、代替案、失敗条件 |
| 形式が定められた抽出・分類 | Lunaなど小さな選択肢 | 漏れ率、形式遵守 |
上記の表は、この記事の評価計画です。モデルごとの優劣を測定した結果表ではありません。
API単価とアプリ使用量は別途計算する必要がある
APIはプログラムからモデルを呼び出すインターフェースです。トークンは入力・出力を計算する単位であり、文字数と一対一で対応するわけではありません。以下は、リクエストごとの入力が272Kトークン以下の場合のStandardテキスト単価です。
WRIMO-MD-TABLE-1]根拠: [公式API価格表、6 Sol APIドキュメント、6.1 Sol APIドキュメント。長い入力、キャッシュ書き込み、地域処理、Fast、ツール使用などは別途条件があるため、上記の表だけで最終的な請求額を計算しないでください。
違いはキャッシュされた入力単価にあります。キャッシュは繰り返し入力を再度処理する際に再利用する方式ですが、実際のヒットの有無はリクエスト構成とサービス条件に依存します。以下は、各リクエストの入力が272Kトークン以下の複数のStandardリクエストを合算した仮想使用量です。一般入力はキャッシュ書き込みではない一般入力であり、キャッシュ書き込み・ツール・地域処理などの追加料金は除外します。単一リクエストの入力が272Kを超えると、当該リクエスト全体の入力・キャッシュ単価は2倍、出力単価は1.5倍になります。
일반 입력 20만 토큰 + 캐시 적중 입력 80만 토큰 + 출력 10만 토큰
6 Sol:   0.2 × 2 + 0.8 × 0.20 + 0.1 × 10 = $1.56
6.1 Sol: 0.2 × 2 + 0.8 × 0.10 + 0.1 × 10 = $1.48
차이: $0.08
キャッシュ読み取り単価が半分であっても、この例の全体費用は約5.1%削減されます。入力全体をキャッシュ料金で計算したり、全体費用が半分になると読んだりすると、結果が大きく異なります。上記の計算にはキャッシュ書き込みやツールなどの追加料金は含まれていません。
ChatGPT Work・Codexのクレジット計算もAPIドル単価とは別です。GPT-6 SolとGPT-6.1 Solの一般入力・出力Standardクレジット単価はAstraの5分の1ですが、モデルごとの実際のトークン使用量が異なる場合があるため、作業1件が必ず5分の1の費用であるという意味ではありません。サブスクリプションの含まれる使用量も同じ数字で換算して断定することはできません。 公式価格案内
「速い」という言葉の比較対象を確認しよう
6.1 SolはアカウントとクライアントによってStandard・Fastを使用でき、Ultrafastのサポートは今後予定されていると案内されています。モデル選択画面が表示されるかどうかは、料金プラン・ワークスペース設定・デプロイ状況によって異なります。 モデルサポート案内
Fastの使用量倍率は速度倍率とは異なります。また、Astra Ultrafastの最大8倍という数値は、Astra Standardと比較したトークン生成速度です。これを6.1 Solが既存のSolより8倍速いとか、調査やツール実行まで含めた作業が8倍早く終わると解釈することはできません。 公式速度案内
実務では、最初の回答が出る時間と検証を終える時間が異なる場合があります。回答は速かったが、間違った出典を修正するのに時間がかかった場合、体感生産性は低くなります。モデル比較では、最終的に使用できる結果が出るまで測定する方が有用です。
APIに切り替えるなら呼び出し方式も確認しよう
APIに切り替える際は、モデル名以外に呼び出し方式も確認します。GPT-6.1 Solはreasoning.effortのnone・minimalをサポートしておらず、ツール呼び出しにはResponses APIを使用します。Chat Completionsはツール呼び出しなしでサポートされます。既存のGPT-6 Solのnone設定やChat Completions関数呼び出しをそのまま移行すると互換性がありません。アプリでモデルを選択する場合と、プログラムのAPI設定を交換する場合を区別して確認します。 6 Sol APIドキュメント、6.1 Sol APIドキュメント
切り替える前に小さな比較表を作ろう
公開しても問題ない仮想資料で、普段の作業を3つ準備します。例えば、簡単な入力検証関数の修正、公式文書2つの条件比較、短いブログ草案作成です。顧客文書や実際の口座・ログを評価用プロンプトに移さなくても、基本的な作業適合性を確認できます。
各作業に同じ資料と要求事項を与え、モデル・推論設定・速度モードを記録します。比較中に要求事項を変更すると、どの違いがモデルから来たのか判断が難しくなります。実行順序を変えて繰り返し、偶然一度出た良い回答よりも繰り返しの結果を見ます。
| 評価項目 | 記録する値 |
| — | — |
| 完了品質 | 必須条件充足数、重大なエラー数 |
| 根拠 | 出典の存在、主張と出典の一致 |
| 修正負担 | 人の修正回数・レビュー時間 |
| 所要時間 | 開始から検証完了まで |
| 費用 | 実際の使用量と適用料金条件 |
コーディングはテストが通過したか、不要な変更がないかを一緒に見ます。文書は抜けた条件や間違った数値がないか確認します。ブログは読みやすい文章だけでなく、検証されていない経験談や製品性能をでっち上げていないかも評価します。
両モデルが基準を満たせば、費用と修正負担が小さい方を選ぶことができます。複雑な作業で差が大きい場合は、Astraに任せる範囲を定め、単純作業はより小さなモデルに移すように運用します。この方式は、新しいモデルがリリースされるたびに、全ての作業を一斉に切り替える負担も軽減してくれます。
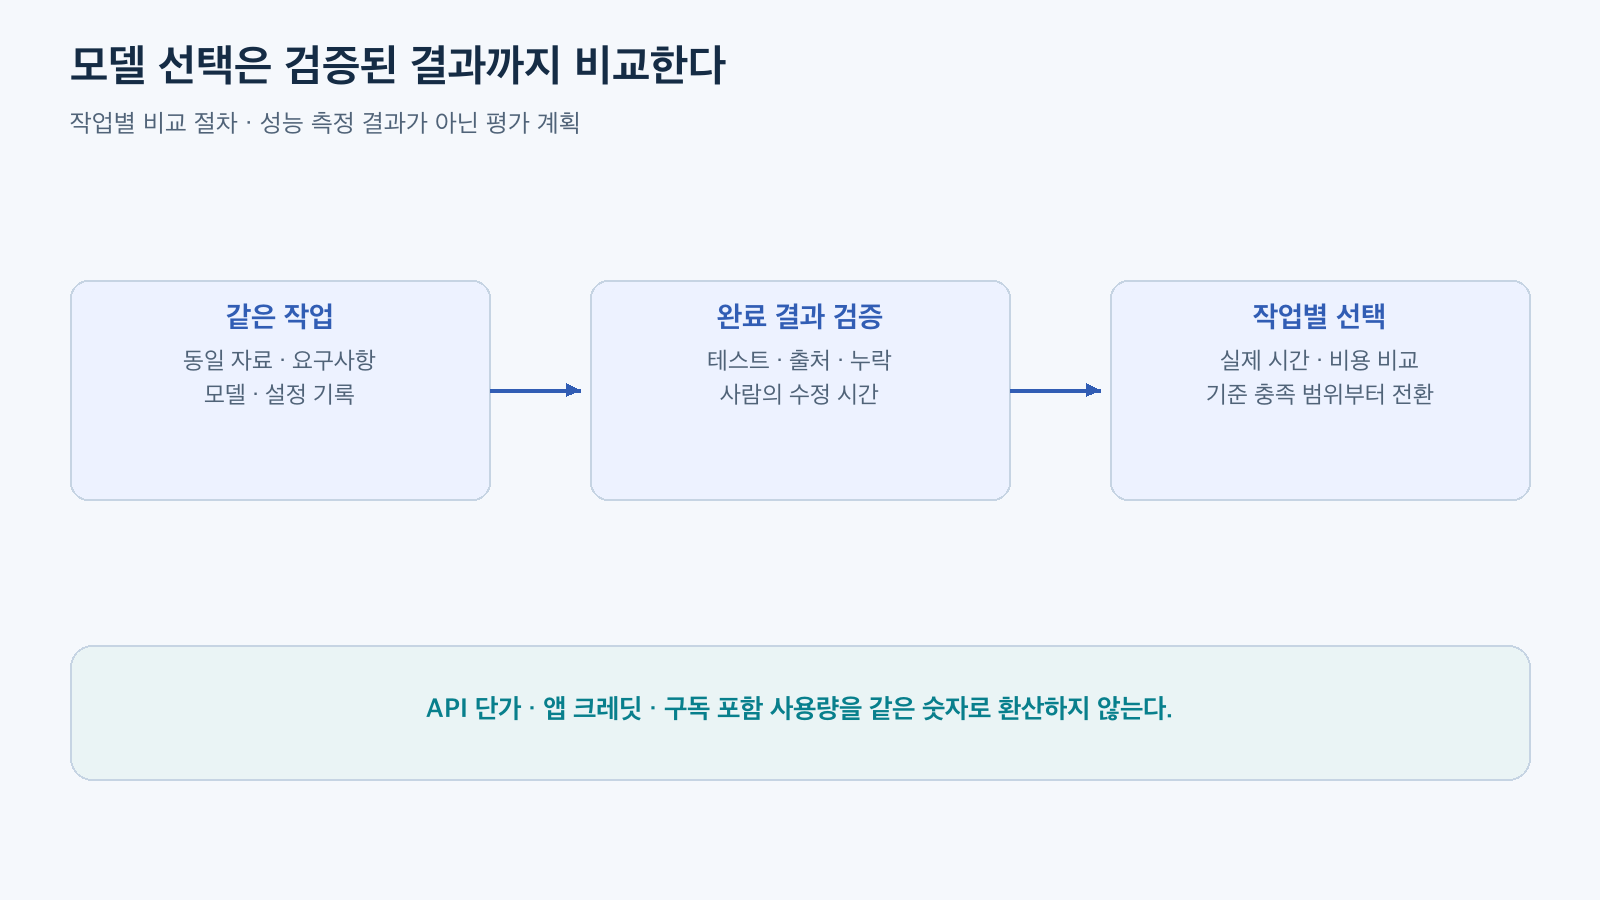
図:作業別比較手順・性能測定結果ではない評価計画・ 公式文書を基に再構成
リリース間隔だけで開発理由を推測しない
短期間に似た名前のモデルがリリースされても、リリース間隔は開発期間を意味しません。公開資料が説明していない緊急修正、競合対応、内部障害のような理由を事実のように付加する根拠はありません。選択に必要な情報は、現在のサポート条件と自身の作業で得られた結果です。
6.1 Solは、反復的なコーディング・文書作業の比較候補として適しています。既存の6 Solがすでに基準を満たしているなら、まず小規模で評価し、結果と検証コストが改善された作業から移行すれば良いでしょう。モデル名よりも重要なのは、同じ要求事項をどれだけ安定的に満たすかです。
コメントを残す