こんにちは!データエンジニアリングの世界では、「何を」するかと同じくらい「どのような順序で」行うかが非常に重要です。特にオブザーバビリティ(Observability)パイプラインを構築する際、プロセッサーの順序をどのように決定するかによって、システムの効率性とセキュリティが大きく変わる可能性があります。
本日は、データ収集からエクスポートまで、最も効率的で論理的なパイプラインの順序について見ていきましょう。🚀
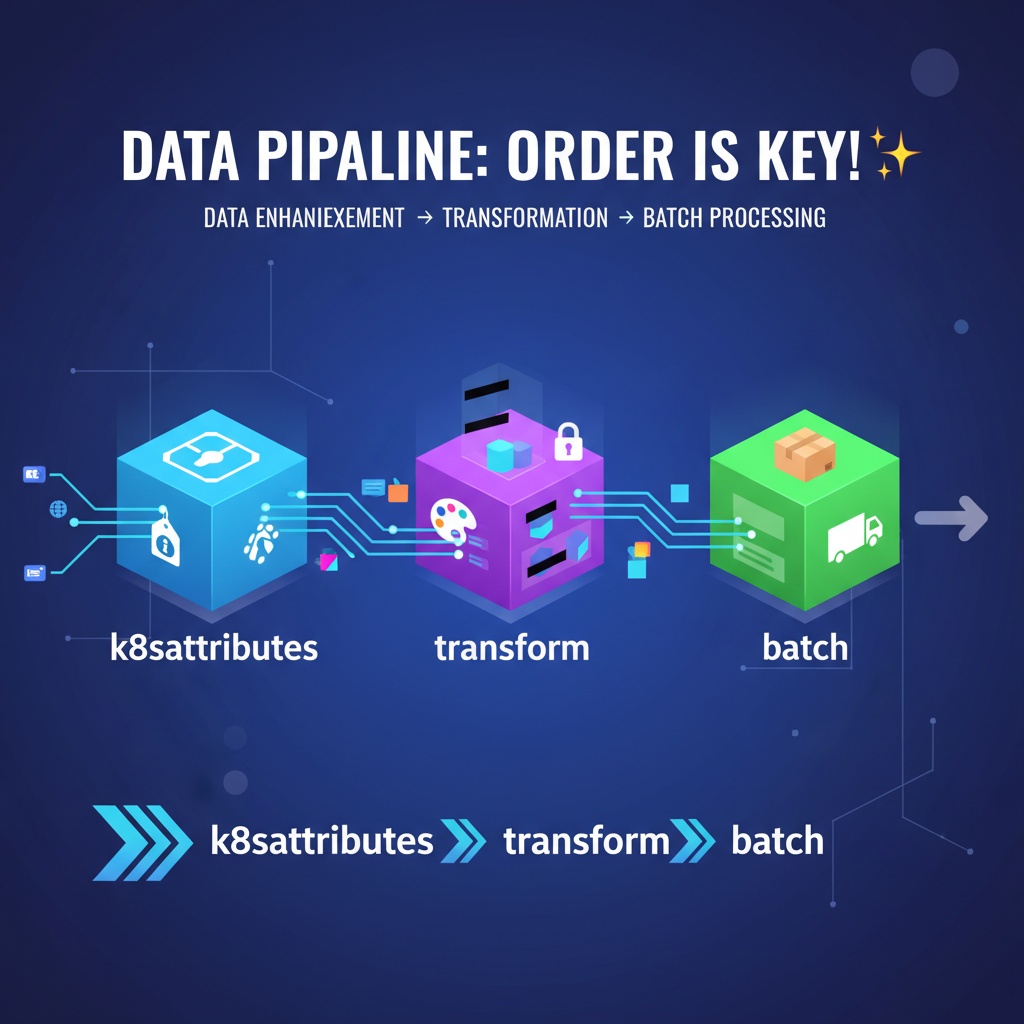
1️⃣ 最初のステップ:コンテキストの追加 (k8sattributes) 🏷️
最初に行うべきことは、収集したデータに「タグ」を付けることです。これは、データがどこから来たのか、どのような環境で生成されたのかという情報、つまりメタデータを追加するプロセスです。
例えば、Kubernetes環境でデータを収集する場合、そのデータがどのPodで発生したのか、どのNamespaceに属しているのかといった情報は非常に重要です。k8sattributesプロセッサーは、まさにこの役割を果たします。
- なぜ最初なのでしょうか? 🤔
- データに豊富なコンテキスト(文脈)があることで、次の段階で意味のある作業を実行できます。例えば、「Aネームスペースからのデータのみをフィルタリング」や「B Podで発生したデータは特別処理」といったルールを適用するには、データにその情報がすでに含まれている必要があります。
- 基本的な身元確認手続きだと考えると簡単です! 🏗️
2️⃣ 2番目のステップ:データの加工と変換 (transform) 🎨
データに豊富なコンテキストが追加されました。次は、このデータを私たちが望む形に「加工」する段階です。transformプロセッサーは、データを修正、フィルタリング、または再構築する役割を担います。
最も重要な作業の一つは、機密情報のマスキングです。例えば、ログデータにユーザーのメールアドレスや個人識別情報が含まれている場合、外部にエクスポートする前に必ず隠す必要があります。🤫
- なぜ2番目なのでしょうか? 🤔
- 最初のステップで追加されたメタデータを活用することで、より洗練された変換ルールを適用できます。(k8sattributesで補強されたPod名が「prod-db」の場合にのみuser.emailフィールドをマスキングするなど)
- セキュリティと規制遵守のため、不要なデータや機密データをこの段階で確実に除去する必要があります。🔒
3️⃣ 3番目のステップ:効率的な転送準備 (batch) 📦
データの補強と変換がすべて完了しました!これで、これらの貴重なデータを最終的な目的地に送る必要があります。しかし、一つずつ送るのは非常に非効率的です。まるで手紙を一枚ずつ郵便局に持っていくようなものです。
batchプロセッサーは、処理されたデータを一定サイズのまとまり(バッチ)にして、一度に転送できるように準備する役割を果たします。
- なぜ最後なのでしょうか? 🤔
- すべての処理(補強、変換、フィルタリングなど)が完了した最終結果をまとめるのが最も効率的です。もしデータを変換する前にバッチでまとめてしまうと、変換作業のために再度まとめを解除して再作業する手間が発生する可能性があります。
- ネットワークコストを削減し、転送効率を最大化するための最後の最適化段階です。🚚💨
🏁 結論:正しい順序の重要性
データ処理パイプラインにおけるプロセッサーの順序は、次のように整理できます。
k8sattributes (補強) ➡️ transform (変換) ➡️ batch (一括処理)
- まず、データにコンテキストを付与し、
- 次に、付与されたコンテキストを活用してデータを安全かつ有用に加工し、
- 最後に、完全に処理されたデータを効率的にエクスポートします。
この論理的な流れを覚えておけば、より安定した効率的なデータパイプラインを構築できるでしょう! ✨
コメントを残す