“我的代码明明运行良好,为什么整个服务却很慢?”“当服务A调用服务B时,传递了哪些参数?”
随着微服务架构(MSA)变得越来越复杂,查找故障原因或分析性能瓶颈变得越来越困难。这感觉就像在一个巨大的迷宫中迷失了方向。😭
在这种“可观测性(Observability)”危机中,OpenTelemetry(简称Otel)成为了我们的救命稻草。今天,我们将为那些在MSA地狱中迷失的开发者们,从A到Z深入探讨OpenTelemetry的一切!
🤔 那么,OpenTelemetry到底是什么?
OpenTelemetry是一个开源框架,它标准化了可观测性数据的生成和收集方式。过去,每个供应商(Datadog、New Relic等)或技术(Jaeger、Prometheus)都有各自不同的数据收集方式。Otel将所有这些统一起来,可以简单地将其视为一个“标准规范”,无论使用何种系统,都能以相同的方式收集和传输数据。
整体流程如下:
应用程序(数据生成)➡️ OpenTelemetry Collector(中间处理)➡️ 可观测性后端(Jaeger、Prometheus等)
由于这种结构,我们几乎无需修改应用程序代码,就能获得自由更改数据发送目的地的灵活性。✨
1️⃣ OpenTelemetry的三大核心数据:信号 (Signals)
Otel收集三种核心数据,即“信号”,用于观察系统。
🗺️ 追踪 (Traces):追踪请求的完整旅程
它将用户请求从进入系统到离开系统,经过所有服务和组件的过程,捆绑成一个完整的旅程。这就像查询快递的配送状态一样。
- Trace:一个请求的完整旅程。(例如:整个商品订单请求)
- Span:旅程中的一个工作单元。(例如:登录验证、库存检查、调用支付API)
Span的结构(示例)
>
`
{
“name”: “HTTP GET /api/products”,
“trace_id”: “0af7651916cd43dd8448eb211c80319c”,
“span_id”: “b7ad6b7169203331”,
“parent_span_id”: “f3a4a75a9d201b5a”,
“start_time”: “2025-11-09T11:41:00.123Z”,
“end_time”: “2025-11-09T11:41:00.345Z”,
“attributes”: {
“http.method”: “GET”,
“http.status_code”: 200,
“user.id”: “user123”
},
“events”: [
{
“name”: “Cache miss”,
“timestamp”: “2025-11-09T11:41:00.200Z”
}
]
}
`
仅凭这个trace_id,就可以将分散在多个微服务中的操作(Span)关联起来,一目了然地掌握请求的整个流程。
📊 指标 (Metrics):测量系统的健康状态
以数字形式表示系统在特定时间点的状态数据。可以将其想象成汽车的仪表盘。
- Counter:只增不减的值(例如:总请求处理数、网站总访问量)
- UpDownCounter:可增可减的值(例如:当前活跃用户会话数)
- Histogram:测量值的分布(例如:95%的API请求在100ms内处理完成)
- Gauge:特定时间点的值(例如:当前CPU使用率、内存使用量)
📝 日志 (Logs):特定事件的详细记录
这是我们最熟悉的数据。它是特定时间发生的事件的文本记录。Otel日志的真正强大之处在于其与追踪的联动。
Otel日志的核心!日志中包含trace_id和span_id。因此,可以立即确定“这个错误日志是哪个请求(Trace)的哪个操作(Span)中发生的?”不再需要翻阅日志文件来猜测原因了!
2️⃣ 在代码中嵌入Otel:API & SDK
那么,这些数据是如何生成的呢?通过API和SDK,向应用程序添加“检测(Instrumentation)”代码。
- API:“要收集哪些数据”的规范(设计图)。
- SDK:实际实现API规范的各语言工具(实现体)。
由于这两者是分离的,我们只需按照API标准编写代码,即使以后更换SDK实现,也无需修改代码。
检测方法主要有两种:
- 自动检测 (Automatic Instrumentation) 🪄:无需修改代码,只需添加代理或库,即可自动收集流行框架(Spring、Django等)或库(HTTP客户端、DB驱动程序)的数据。这是最简单、最强大的首选方法!
- 手动检测 (Manual Instrumentation) ✍️:对于“我们公司特有的重要业务逻辑”等自动检测无法捕获的部分,开发者直接调用API来生成数据。
3️⃣ 万能数据中心:OpenTelemetry Collector
将应用程序生成的数据直接发送到后端效率低下且存在风险。这可能会增加应用程序的负担,并且如果更改后端,则需要修改所有应用程序代码。
此时,Otel Collector应运而生。Collector充当应用程序和后端之间的独立代理,负责接收、处理和导出数据。
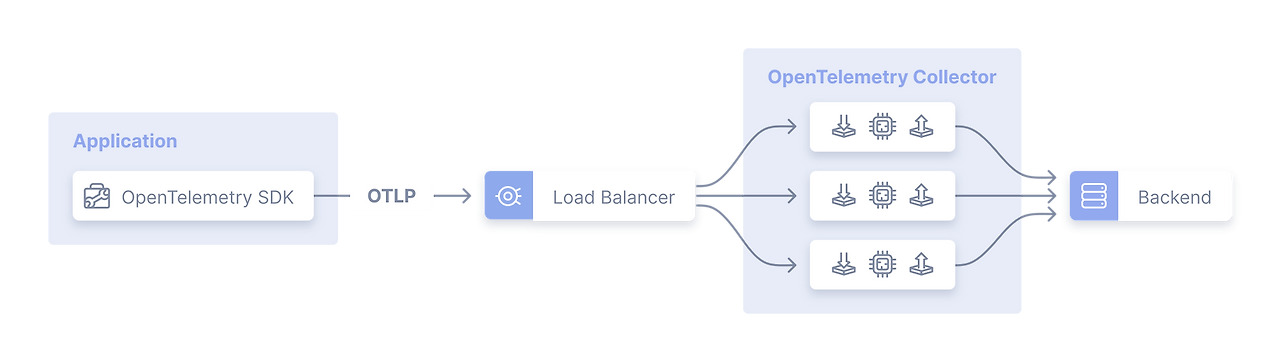
(Image Source: opentelemetry.io)
Collector像乐高积木一样由三部分组成:
- 接收器 (Receivers) 📥:接收各种格式(OTLP、Jaeger、Prometheus等)的数据。
- 处理器 (Processors) 🛠️:处理数据。包括过滤不必要的数据、屏蔽敏感信息、批量处理数据以提高效率等操作。
- 导出器 (Exporters) 📤:将处理后的数据导出到最终目的地(Jaeger、Prometheus、Datadog等)。
💡 为什么要使用Collector?
>
– 关注点分离:应用程序只专注于数据“生成”,Collector负责“处理和传输”,从而减轻应用程序的负担。
– 灵活性:想同时将数据发送到Jaeger和Prometheus?只需更改Collector配置文件中的一行即可!无需触动应用程序代码。
– 性能:使用批量处理器可以一次性发送收集到的数据,从而最大限度地提高网络效率。这就是在生产环境中强烈建议使用BatchSpanProcessor(批量发送Span)而不是SimpleSpanProcessor(立即发送每个Span)的原因。
Collector配置文件示例 (config.yaml)
Collector如何运行,通过这个配置文件即可完全说明。
# OpenTelemetry Collector的config.yaml

receivers: # 数据通过OTLP协议接收
  otlp:
    protocols:
      grpc:
      http:

processors: # 接收到的数据进行批量处理,并限制内存使用量
  batch:
  memory_limiter:
    check_interval: 1s
    limit_percentage: 75

exporters: # 处理后的数据发送到Jaeger,并为了调试目的也输出到控制台
  otlp/jaeger:
    endpoint: "jaeger-all-in-one:4317" # Jaeger地址
    tls:
      insecure: true
  logging:
    loglevel: debug

service:
  pipelines: # 将上述组件连接成一个管道
    traces: # 追踪数据将这样处理
      receivers: [otlp]
      processors: [batch, memory_limiter]
      exporters: [otlp/jaeger, logging]
4️⃣ 分布式系统的血管:OTLP & Context Propagation
最后,让我们了解所有这些组件是如何相互通信的。
- OTLP (OpenTelemetry Protocol) 📡:Otel的官方数据传输协议。它充当所有Otel组件都能理解的“通用语言”。
- Context Propagation 🤝:这是分布式追踪的核心技术。当服务A向服务B发送HTTP请求时,幕后会发生一些神奇的事情。即在名为`traceparent`的HTTP头部中携带trace_id等追踪信息。
HTTP头部示例
>
`
traceparent: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01
`
>
多亏了这个头部,服务B才能识别“啊,这个请求是0af…追踪的一部分!”,并将其自身的操作(Span)连接到同一个追踪中。如果没有这种“上下文传播”,分布式追踪将是不可能的。
总结
OpenTelemetry不仅仅是另一个库或工具。它是一种标准和哲学,使我们能够透明地审视复杂现代分布式系统的内部。
通过Otel,我们可以将分散的服务数据整合起来,看到全局图景,并在问题发生时迅速查明原因并解决。不要再在迷宫中徘徊了。何不与OpenTelemetry一起,为您的系统点亮一座明亮的灯塔呢?🚀
发表回复