ChatGPTやClaudeのような外部AIサービスを呼び出す代わりに、自分のPCやサーバーで直接大規模言語モデルを実行したいときに、最初に触れるツールの一つがOllamaです。これは、複雑な推論エンジン設定とモデルファイル管理を隠蔽し、`ollama run`という単純なコマンドとHTTP APIを提供するからです。
Ollamaをオペレーティングシステムに直接インストールすることもできますが、Dockerコンテナとして実行すると、インストールファイルと実行環境を分離し、バージョン変更や削除・復元を一貫した方法で管理できます。一方、GPU接続、モデルデータの永続化、ネットワーク露出はコンテナ環境で別途理解する必要があります。
この記事では、まずOllamaの役割と内部構造を調べ、次にCPU、NVIDIA GPU、AMD GPU環境でコンテナとしてインストールする方法を段階的に説明します。モデルのダウンロード、REST API、OpenAI互換API、Docker Composeの構成と運用セキュリティまで、一度にまとめます。
Ollamaとは何か
Ollamaは、ローカルまたは自身のサーバーで生成AIモデルをダウンロードして実行できるようにするモデル実行・管理ツールです。ユーザーは、推論エンジンの詳細オプションを毎回組み合わせる代わりに、モデル名を指定して実行し、CLIやHTTP APIで対話できます。
Ollamaが担当する主要な機能は次のとおりです。
- モデルRegistryからモデルManifestとLayerをダウンロード
- ローカルモデルファイルとバージョン管理
- ハードウェアに合ったCPU・GPU推論Backendを選択
- モデルのLoad・Unloadとメモリ維持時間管理
- Text Generation, Chat, Embedding, VisionとTool Calling APIを提供
- Modelfileを利用したSystem PromptとParameterベースのユーザーモデル構成
- OpenAI APIの一部と互換性のあるEndpointを提供
Ollama自体はChatGPTのような完成されたウェブチャットサービスではありません。モデルを実行しAPIを提供するModel RuntimeとModel Serverに近いものです。ブラウザUIが必要な場合は別途Web UIを接続し、RAGやAgentが必要な場合はアプリケーション層を追加する必要があります。
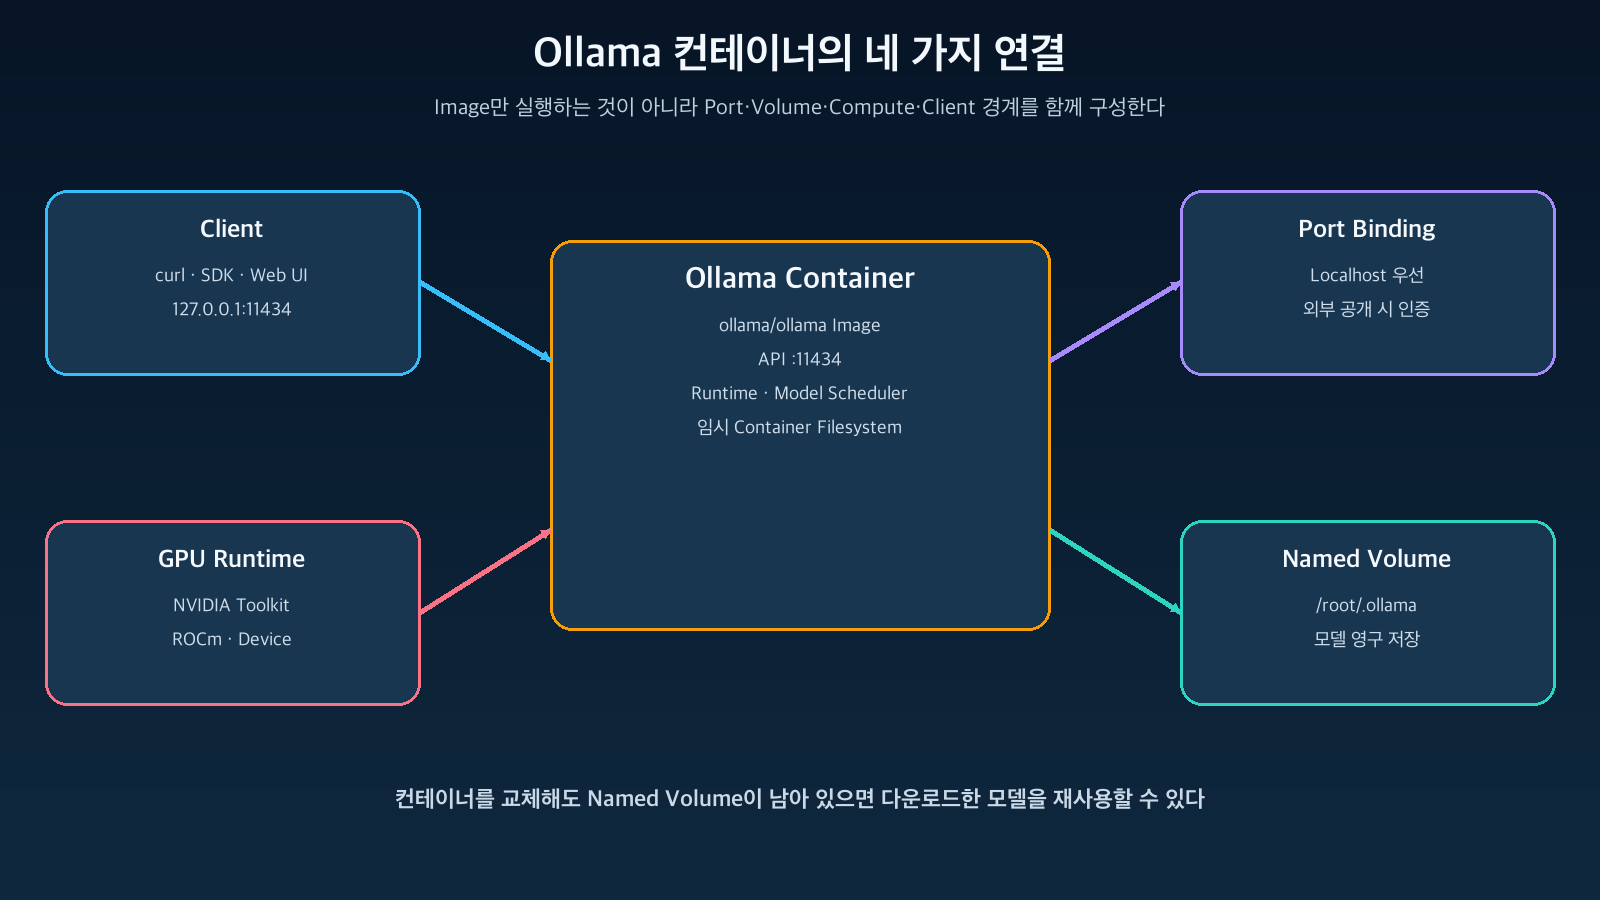
図: Ollamaの基本構成とリクエスト処理フロー · Ollama API、Dockerインストール文書に基づいて再構成
OllamaとvLLMは同じツールか
どちらもモデルを実行しますが、目指す方向が異なります。Ollamaは、個人開発環境や小規模な自己ホスティングでモデルを簡単に取得して実行する体験に強みがあります。vLLMは、多数のユーザーのリクエストを高いスループットで提供するModel ServingとGPU活用最適化に重点を置いています。
| 区分 | Ollama | vLLM |
| — | — | — |
| 主な使用目的 | ローカル開発、個人・チーム単位のモデル実行 | 高スループットGPUモデルサービング |
| 開始難易度 | モデル名だけで簡単に実行 | モデル・GPU・サービングオプションの設計が必要 |
| モデル管理 | Pull・List・Run統合 | Hugging Faceなど外部モデルパス中心 |
| API | Ollama Native API + OpenAI一部互換 | OpenAI互換サービング中心 |
| 拡張観点 | 単一ホストと簡単なサービスに適している | 並列処理とサーバー級の運用に適している |
したがって、「開発者がローカルモデルを素早く使用する」場合はOllamaが便利であり、「多くのユーザーが同時に使用するGPU推論APIを運用する」場合はvLLMや専用のServing Platformを比較検討する必要があります。
コンテナでインストールすると何が変わるか
コンテナはOllamaの実行ファイルとライブラリをImage内に格納し、Hostと分離して実行します。しかし、モデルファイルまでコンテナの一時Filesystemに保存すると、コンテナを交換する際に数GBから数十GBのモデルを失う可能性があります。
そのため、Ollamaコンテナでは3つの接続が重要です。
Host의 11434 Port
→ Ollama Container의 11434 Port

Named Volume ollama_data
→ Container의 /root/.ollama

Host GPU Device 또는 GPU Runtime
→ Container의 추론 Backend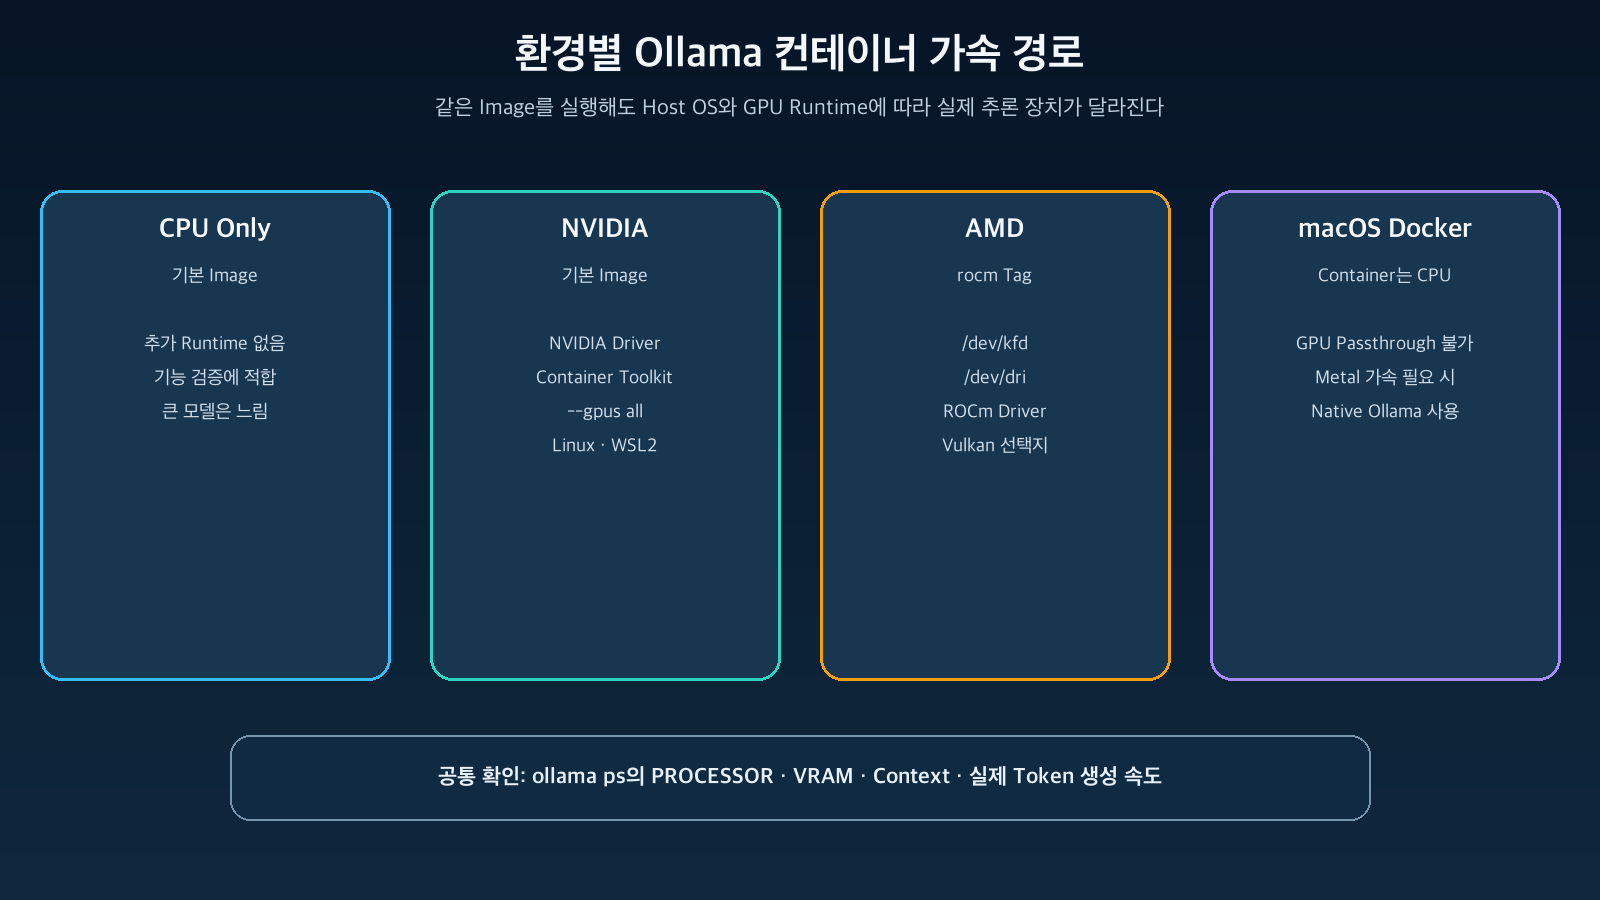
図: Ollamaコンテナインストールで必ず接続すべき構成要素 · Ollama Docker公式文書に基づいて再構成
コンテナを削除してもNamed Volumeが残っていれば、新しいコンテナが既存のモデルをそのまま使用できます。逆に`-v ollama:/root/.ollama`を省略すると、モデルはコンテナの寿命に依存します。
インストール前の準備事項
まず、Docker EngineまたはDocker Desktopがインストールされている必要があります。
docker versionGPUを使用する予定がある場合は、まずオペレーティングシステムとGPUの種類を確認します。
# NVIDIA GPU
nvidia-smi

# AMD ROCm環境
rocminfo
モデルのパラメータ数と量子化によって、メモリ要件は大きく異なります。モデルファイルが4GBだからといって、VRAMも正確に4GBだけが必要なわけではありません。モデルの重み以外にもKVキャッシュとランタイムバッファが必要であり、コンテキスト長を長くするほど追加のメモリが使用されます。
最初は、自分のRAMまたはVRAMよりも十分に小さいモデルでインストールフローを検証することをお勧めします。具体的なモデルサイズとタグはOllama Model Libraryで確認できます。
1段階: CPU専用コンテナの実行
GPUなしで機能を確認するには、次のコマンドで開始できます。
docker run -d
  --name ollama
  --restart unless-stopped
  -p 127.0.0.1:11434:11434
  -v ollama_data:/root/.ollama
  ollama/ollama:latest
公式文書では`-p 11434:11434`を使用していますが、この形式はDockerの設定によってはHostのすべてのネットワークインターフェースにポートを公開する可能性があります。この記事ではローカル使用を基本とするため、127.0.0.1にのみバインドしました。
各オプションの意味は次のとおりです。
| オプション | 意味 |
| — | — |
| -d | バックグラウンドでコンテナを実行 |
| –name ollama | コンテナ名をollamaに指定 |
| –restart unless-stopped | ユーザーが停止しない限り、Docker再起動後に自動実行 |
| -p 127.0.0.1:11434:11434 | HostのLocalhostポートをコンテナAPIポートに接続 |
| -v ollama_data:/root/.ollama | モデルと設定をNamed Volumeに永続保存 |
| ollama/ollama:latest | 公式Ollamaイメージを使用 |
運用環境では、`latest`の代わりに検証済みのVersion TagやImage Digestを固定する方が安全です。`latest`は再デプロイ時に異なるバージョンを取得する可能性があるためです。
コンテナの状態とログを確認します。
docker ps --filter name=ollama
docker logs --tail 100 ollama
APIが応答するか確認します。
curl http://localhost:11434/api/version2段階: モデルのダウンロードと初回実行
公式Docker文書では、次のようにコンテナ内でCLIを実行する方法を案内しています。
docker exec -it ollama ollama run llama3.2モデルがない場合はまずダウンロードされ、ダウンロードが完了するとすぐに会話プロンプトが開きます。会話を終了した後、モデルリストを確認できます。
docker exec ollama ollama listモデルのダウンロードと実行を分離したい場合は、次のように使用します。
docker exec ollama ollama pull llama3.2
docker exec -it ollama ollama run llama3.2
APIでもモデルを取得できます。
curl http://localhost:11434/api/pull
  -H 'Content-Type: application/json'
  -d '{"model":"llama3.2","stream":false}'
モデルのプルは、大きなネットワークトラフィックとディスク使用量を発生させます。複数のコンテナが同じモデルボリュームを同時に変更するように構成するよりも、1つのOllamaインスタンスがボリュームを管理するようにする方が単純です。
3段階: Ollama Native APIの呼び出し
Ollamaの基本API Base URLは`http://localhost:11434/api`です。Chat Endpointに`stream:false`を指定すると、一度のJSONレスポンスを受け取ることができます。
curl http://localhost:11434/api/chat
  -H 'Content-Type: application/json'
  -d '{
    "model": "llama3.2",
    "messages": [
      {"role": "user", "content": "컨테이너의 장점을 세 문장으로 설명해줘"}
    ],
    "stream": false
  }'
`stream`のデフォルト値は`true`です。この場合、完成したJSON一つではなく、生成過程が複数のJSONオブジェクトとして順次転送されます。CLIでは自然ですが、一般的なJSONパーサーに直接入れるとエラーと見なされる可能性があるため、アプリケーションの方式に合わせて設定する必要があります。
レスポンスには、回答だけでなく、モデルのロード時間、プロンプトトークン数、生成トークン数、推論時間も含まれます。これを利用すると、次のようなおおよその生成速度を計算できます。
초당 생성 Token
= eval_count / (eval_duration / 1,000,000,000)
4段階: OpenAI SDKとの接続
OllamaはOpenAI APIの一部と互換性のある`/v1`エンドポイントも提供します。既存のOpenAIクライアントの`base_url`を変更すると、Ollamaモデルを呼び出すことができます。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1/",
    api_key="ollama",
)

response = client.chat.completions.create(
    model="llama3.2",
    messages=[
        {"role": "user", "content": "Ollama를 한 문장으로 설명해줘"}
    ],
)

print(response.choices[0].message.content)
公式文書の例にある`api_key=”ollama”`は、OpenAI SDKが値を要求するために入れるプレースホルダーであり、ローカルOllama APIがこの値を認証するわけではありません。Ollama公式文書によると、`localhost:11434`のローカルAPIには認証は不要です。
「OpenAI互換」もすべての機能が完全に同じという意味ではありません。使用するEndpoint、Tool Calling、Vision、Structured Output、Streamingが対象モデルで実際に動作するか確認する必要があります。
NVIDIA GPUで実行する
LinuxまたはWindows WSL2でNVIDIA GPUをコンテナに接続するには、HostにNVIDIA DriverとNVIDIA Container Toolkitが必要です。インストール方法はオペレーティングシステムごとに異なるため、NVIDIA Container Toolkit公式インストール文書に従う必要があります。
Toolkitインストール後、Docker Runtimeを構成し、Dockerを再起動します。
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
GPUがコンテナから見えるかまず確認します。
docker run --rm --gpus all nvidia/cuda:12.4.1-base-ubuntu22.04 nvidia-smi次に、OllamaをGPUオプションとともに実行します。
docker run -d
  --name ollama
  --restart unless-stopped
  --gpus all
  -p 127.0.0.1:11434:11434
  -v ollama_data:/root/.ollama
  ollama/ollama:latest
複数のGPUのうち一部のみを使用する場合は、HostのGPU UUIDを確認し、`CUDA_VISIBLE_DEVICES`を制限できます。Ollama公式ハードウェア文書では、数値インデックスよりもUUIDの方が安定していると案内しています。
GPUオフロードの有無は、モデルを一度実行した後に確認します。
nvidia-smi -LPROCESSORが100% GPUであるか、一部CPUオフロードが発生したかを確認します。モデルとコンテキストがVRAMよりも大きい場合、一部の演算がCPUにオフロードされ、速度が大幅に低下する可能性があります。
AMD GPUで実行する
AMD ROCmを使用する場合は、公式の`rocm`タグとGPUデバイスを渡します。
docker exec ollama ollama psサポートされているGPUと必要なROCm Driverバージョンは、OllamaのHardware Support文書で確認する必要があります。一部のLinuxディストリビューションではSELinuxがコンテナのGPUデバイスアクセスをブロックする可能性があるため、パーミッションエラーが発生した場合はAudit Logとコンテナデバイスポリシーも確認します。
最近の公式Imageには、アクセス可能なデバイスがある場合に使用できるVulkan Backendも含まれています。VulkanとROCmのどちらがより安定しているかはGPUとドライバーの組み合わせによって異なるため、同じモデルとプロンプトで実際の性能とエラーを比較する必要があります。
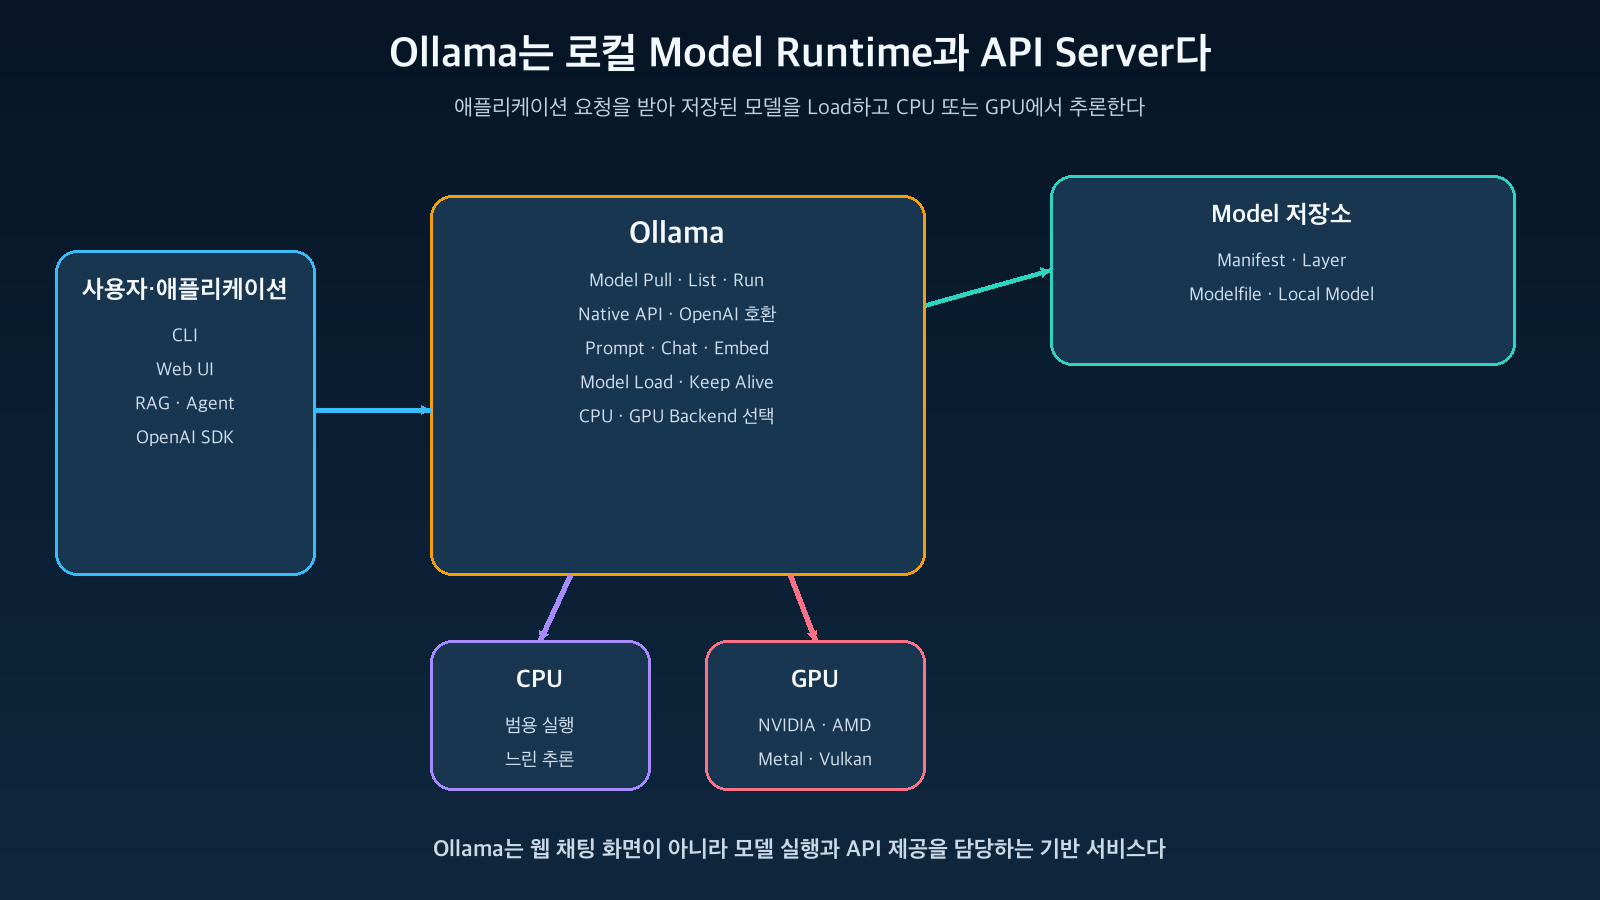
図: コンテナ環境別Ollamaアクセラレーションパス · Ollama Docker、Hardware Support文書に基づいて再構成
macOS DockerではGPUを使用できるか
重要な制限があります。Ollama公式FAQは、macOSのDocker DesktopではGPUパススルーとエミュレーションの制約のため、Ollama GPUアクセラレーションを使用できないと案内しています。
Apple SiliconのMetal GPUを活用するには、Ollama macOS Appまたはネイティブインストールを使用する方が適しています。コンテナ隔離がどうしても必要な場合は、DockerではCPUで実行され、HostでネイティブOllama Serverを実行し、他のコンテナが`host.docker.internal:11434`でアクセスするように構成する方法を検討できます。
このとき、ネイティブサーバーを外部にバインドすると、認証のないAPIがネットワークに露出する可能性があります。Host FirewallとReverse Proxy認証を合わせて設計する必要があります。
Docker Composeで管理する
繰り返し実行と設定管理のために、次のような`compose.yaml`を使用できます。
docker run -d
  --name ollama
  --restart unless-stopped
  --device /dev/kfd
  --device /dev/dri
  -p 127.0.0.1:11434:11434
  -v ollama_data:/root/.ollama
  ollama/ollama:rocm
実行と状態確認は次のとおりです。
services:
  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    restart: unless-stopped
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ollama_data:/root/.ollama
    environment:
      OLLAMA_KEEP_ALIVE: "5m"
    healthcheck:
      test: ["CMD", "ollama", "list"]
      interval: 30s
      timeout: 10s
      retries: 3

volumes:
  ollama_data:
NVIDIA GPUをComposeで予約するには、`ollama`サービスに次の設定を追加できます。Docker ComposeのバージョンがGPUデバイス予約をサポートしているか、まず確認する必要があります。
docker compose up -d
docker compose ps
docker compose logs -f ollama
同じComposeネットワークの他のサービスがOllamaを呼び出す場合、Hostにポートを公開する必要はありません。
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
この場合、`ports`を削除し、内部ネットワークでサービス名`ollama`を使用すると、攻撃対象領域を減らすことができます。
モデルとメモリの運用を理解する
Ollamaは基本的に、使用が終わったモデルを一定時間メモリに保持し、次のリクエストのロード時間を短縮します。公式FAQのデフォルト値は5分で、`OLLAMA_KEEP_ALIVE`またはAPIの`keep_alive`で調整できます。
Web UI Container
→ http://ollama:11434
→ Ollama Container
常にメモリに保持すると、最初のトークンの遅延は減少しますが、他のモデルが入るVRAMが不足する可能性があります。複数のモデルを交互に使用する小さなGPUでは短く保持し、1つのモデルにリクエストが集中する場合は長く保持するように調整します。
コンテキスト長もメモリに大きな影響を与えます。OllamaはVRAMに応じてデフォルトのコンテキストを異ならせ、長いコンテキストを設定するほどKVキャッシュが大きくなります。Agentやコーディング作業のためにコンテキストを増やす際は、単にモデルがロードされるかだけでなく、実際の長いプロンプトでVRAMとトークン速度を測定する必要があります。
environment:
  OLLAMA_KEEP_ALIVE: "10m"
更新とバックアップ
Named Volumeを使用した場合、コンテナイメージを交換してもモデルデータは保持されます。Composeでは次の順序で更新できます。
docker exec ollama ollama ps
docker stats ollama
運用環境では、まず新しいバージョンを別の環境で検証し、Version TagまたはDigestを変更する必要があります。APIが概ね下位互換性を目指しているとしても、Ollama公式文書はAPIが厳密にバージョン管理されているわけではないと説明しています。
ボリューム自体はバックアップポリシーに含める必要があります。ただし、公開Registryからいつでも再取得できるモデルレイヤーと、自分で作成したModelfile・プライベートモデルの重要度は異なります。復旧時間を短縮する必要がある場合はボリューム全体をバックアップし、保存コストを削減する必要がある場合はユーザー定義資産と構成情報を優先的に保存します。
外部公開前に必ず知っておくべきセキュリティ事項
ローカルOllama APIには基本認証がありません。したがって、次のような構成は避けるべきです。
docker compose pull
docker compose up -d
攻撃者がAPIにアクセスすると、モデルを繰り返し呼び出してCPU・GPUとメモリを消費し、モデルプルでディスクとネットワークを使用したり、運用者が意図しないモデルにアクセスしたりする可能性があります。
外部または社内ネットワークに提供する必要がある場合は、Ollamaの前にReverse ProxyまたはAPI Gatewayを配置し、次の制御を適用します。
- TLSとユーザー・サービス認証
- IP・ネットワーク許可リスト
- ユーザーごとのレート制限と同時リクエスト数制限
- 許可モデルリストとエンドポイント制限
- リクエストボディサイズとタイムアウト制限
- プロンプト・レスポンスログの個人情報マスキング
- モデルプル・作成・削除などの管理APIの分離
- コンテナCPU・メモリとGPU使用量の監視
単に`OLLAMA_HOST=0.0.0.0:11434`を設定するだけでは、アクセス許可範囲を広げるだけで認証は追加されません。
よくある問題
APIは開いているのに応答が遅すぎる
CPUで実行中であるか、一部のレイヤーがCPUにオフロードされている可能性があります。
Internet
→ 0.0.0.0:11434
→ 인증 없는 Ollama API
モデルを減らすかコンテキスト長を短くし、GPUランタイムとドライバーがコンテナに正常に渡されているか確認します。
コンテナを再作成したらモデルが消えた
`/root/.ollama`にボリュームをマウントしなかったか、別のボリューム名を使用した可能性が高いです。
docker exec ollama ollama ps
docker stats ollama
削除前に現在のマウントとボリューム名を確認する必要があります。
他のコンテナから`localhost:11434`に接続できない
コンテナ内の`localhost`はそのコンテナ自身を指します。同じDockerネットワークではOllamaサービス名を使用します。
docker volume ls
docker inspect ollama
Hostで実行中のOllamaにDocker Desktopコンテナがアクセスする場合は、`host.docker.internal`を使用できます。
ブラウザでCORSエラーが発生する
Ollamaは許可Originを`OLLAMA_ORIGINS`で追加できます。すべてのOriginを無条件に許可するのではなく、実際のWeb UIのOriginのみを指定する必要があります。CORSはブラウザポリシーであり、API認証を代替するものではありません。
Ollamaコンテナが適している場合とそうでない場合
Ollamaコンテナは次の状況によく合います。
- 開発者のPCやチームサーバーで複数のモデルを素早く試すとき
- 外部APIに送信しにくい文書をローカルモデルで処理するとき
- RAG・Agent・AI Gateway開発のための内部モデルエンドポイントが必要なとき
- 同じ設定を複数のLinuxサーバーで再現するとき
逆に、次の要件が重要である場合は、他のServing Stackも比較検討する必要があります。
- 多数の同時ユーザーに対する高いスループット
- 複数のGPUと複数のノードを利用した分散サービング
- 自動スケーリング、ローリングアップデート、精巧なリクエストスケジューリング
- 厳格なマルチテナンシーとモデルごとのSLA
- Kubernetesベースの大規模GPUプール運用
Ollamaの前にAPI Gatewayを配置すると、認証とレート制限は補完できますが、ランタイム自体が大規模な分散Serving Platformに変わるわけではありません。
まとめ
Ollamaは、モデルのダウンロード、実行、メモリ管理、API提供を一つのユーザー体験にまとめ、ローカルLLMの参入障壁を低くしたツールです。Dockerで実行する際の核心は複雑ではありません。
http://ollama:11434最も簡単なCPUインストールは一行で完了しますが、実際の運用では3つのことを見落としてはなりません。モデルボリュームを永続化すること、GPUが実際に使用されているか確認すること、そして認証のない11434ポートを外部に直接公開しないことです。
macOSでDockerを使用する場合、GPUアクセラレーションが利用できない点も重要です。Apple GPUを活用するにはネイティブOllamaアプリまたはネイティブインストールを使用し、Linux・WSL2のNVIDIA環境ではNVIDIA Container Toolkitを構成する必要があります。
最初は小さなモデルとLocalhostバインディングで機能を検証し、その後、モデルサイズ・コンテキスト・同時リクエスト・セキュリティ要件を測定しながら、自分の環境に合った構成に拡張するのが最も安全です。
コメントを残す