ローカルPCや社内GPUサーバーでLLMを実行しようと検索すると、Ollama、vLLM、llama.cppがほぼ常に一緒に登場します。3つともモデルをダウンロードして推論し、HTTP APIとして提供できますが、その志向点はかなり異なります。
Ollamaは複雑なモデル実行プロセスを製品のように包み込み、簡単に使えるようにし、vLLMは複数のユーザーからのリクエストをGPUで高いスループットでサービスすることに注力します。llama.cppはC/C++ベースの軽量ランタイムで、多様なCPUとGPUでGGUFモデルを細かく実行するのに強みがあります。
この記事では、単純な速度順位ではなく、個人用実験、アプリケーション開発、社内サービス、エッジデプロイという実際の目的に合わせて3つのツールを比較します。
一目でわかる結論
| ツール | 最適な状況 | モデル形式とエコシステム | 主要な強み | まず確認すべき弱点 |
| — | — | — | — | — |
| Ollama | ノートPC・ワークステーションでモデルを素早く実行し、アプリと連携 | 独自のモデルライブラリ、Modelfile、GGUFインポート | インストールとモデル管理が容易、macOS・Windows・Linux対応 | 大規模な多人数ユーザーサービングのきめ細かなチューニングは限定的 |
| vLLM | NVIDIA・AMD GPUサーバーで高い同時処理量でAPIを提供 | Hugging Faceモデル中心、多様な量子化方式 | PagedAttention、連続バッチ処理、分散推論、OpenAI互換API | インストール・GPU互換性・運用設計が比較的複雑 |
| llama.cpp | CPU・Apple Silicon・小型GPU・エッジで軽量かつ細かく実行 | GGUF中心 | 低い依存性、幅広いハードウェア、量子化とオフロードの制御 | モデル変換とオプション選択についてユーザーがより深く理解する必要がある |
最も短くまとめると以下の通りです。
個人開発者はOllamaから、GPUベースの多人数ユーザーサービスはvLLMから、リソース制約環境と細かなローカルチューニングはllama.cppから検討すると良いでしょう。
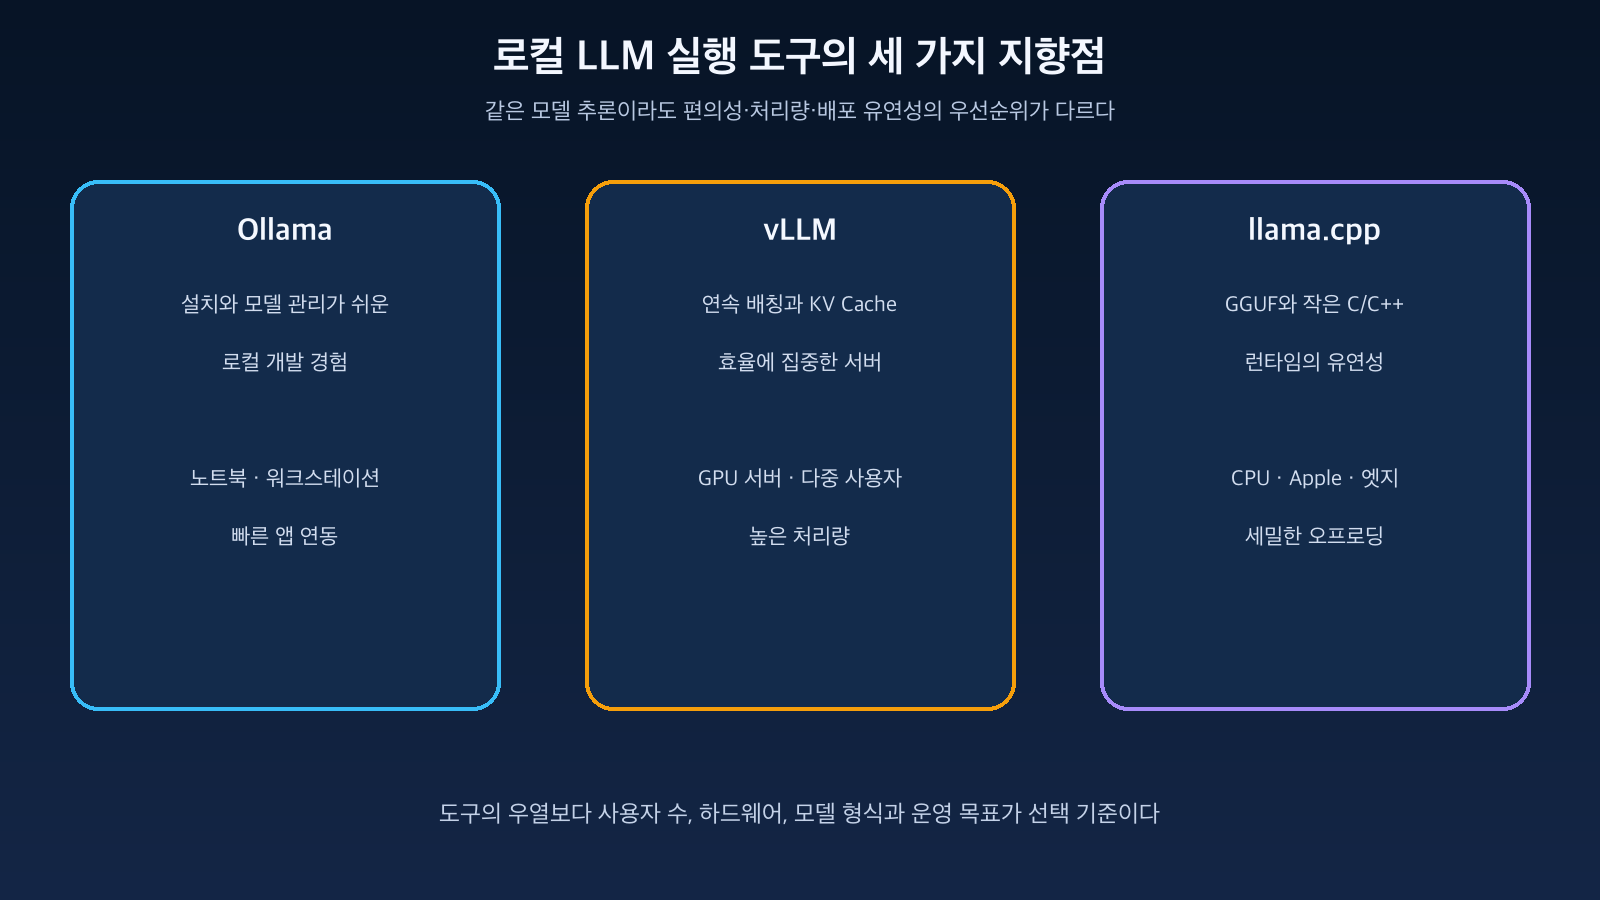
図:3つのツールの主な使用目的と実行レイヤー · Ollama、vLLM、llama.cpp公式ドキュメントを基に再構成
Ollama — ローカルLLMをアプリケーションのように扱う
Ollamaの利点は、モデルファイル、チャットテンプレート、実行オプション、APIサーバーを一つのユーザー体験としてまとめている点です。macOS、Windows、Linuxにインストール後、モデル名を指定するだけでダウンロードと実行を続けて処理できます。
ollama run gemma3ローカルサーバーは基本的にhttp://localhost:11434で動作し、独自のAPIを提供します。
curl http://localhost:11434/api/chat -d '{
  "model": "gemma3",
  "messages": [{"role": "user", "content": "KV Cache를 설명해줘"}]
}'
公式Modelfileは、基本モデルとシステムプロンプト、パラメータ、テンプレート、アダプターをまとめて定義する設計図です。チームで繰り返し使用するローカルモデル設定をファイルで管理するのに適しています。
FROM gemma3
PARAMETER temperature 0.2
SYSTEM 당신은 인프라 기술 문서를 설명하는 조력자다.
OllamaはApple GPUのMetalアクセラレーションをサポートし、NVIDIA、AMD ROCm、実験的なVulkanサポートも公式ドキュメントにまとめられています。モデルを直接ビルドしたりサーバーオプションを組み合わせたりするよりも、「とりあえずローカルで会話してアプリに接続したい」という要求に最も早く応えます。
ただし、ローカルAPIは基本的に認証を必要としません。公式認証ドキュメントもlocalhost:11434へのローカルアクセスには認証がないと明記しています。したがって、0.0.0.0にバインドして社内ネットワークやインターネットにそのまま公開する方式は避け、リバースプロキシ・認証・ファイアウォールを別途構成する必要があります。
vLLM — GPUを複数のリクエストが効率的に共有できるようにする
vLLMは個人用チャットアプリというよりも、推論サーバーエンジンに近いです。複数のユーザーが同時に長いプロンプトを送信する環境では、KVキャッシュがGPUメモリを大きく占有し、リクエストごとに長さが異なるためメモリの断片化とアイドル時間が発生します。
vLLMはPagedAttentionでKVキャッシュをページのように管理し、到着したリクエストを連続バッチ処理することでGPUのアイドル時間を削減します。最新の公式ドキュメントでは、チャンクプリフィル、プレフィックスキャッシング、投機的デコーディング、多様な量子化と分散並列化を主要機能として提示しています。
vllm serve Qwen/Qwen2.5-7B-Instruct
  --dtype auto
  --api-key local-token
デフォルトサーバーはhttp://localhost:8000で実行され、OpenAI互換APIを提供します。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local-token",
)

response = client.chat.completions.create(
    model="Qwen/Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "안녕하세요"}],
)
既存のアプリケーションがOpenAI SDKを使用している場合、base_urlを変更するだけでローカルサーバーに接続しやすくなります。Chat Completionsだけでなく、Responses、Embeddings、音声関連APIなどサポート範囲も拡大していますが、すべてのOpenAIオプションが同様に動作すると仮定すべきではありません。公式互換性ドキュメントでエンドポイントごとの制約を確認する必要があります。
vLLMの利点は、同時ユーザーが増えるときに明らかになります。逆に、一人がノートPCで一度に一つのリクエストしか実行しない場合、インストールと運用の複雑さに見合うほどのメリットは大きくないかもしれません。
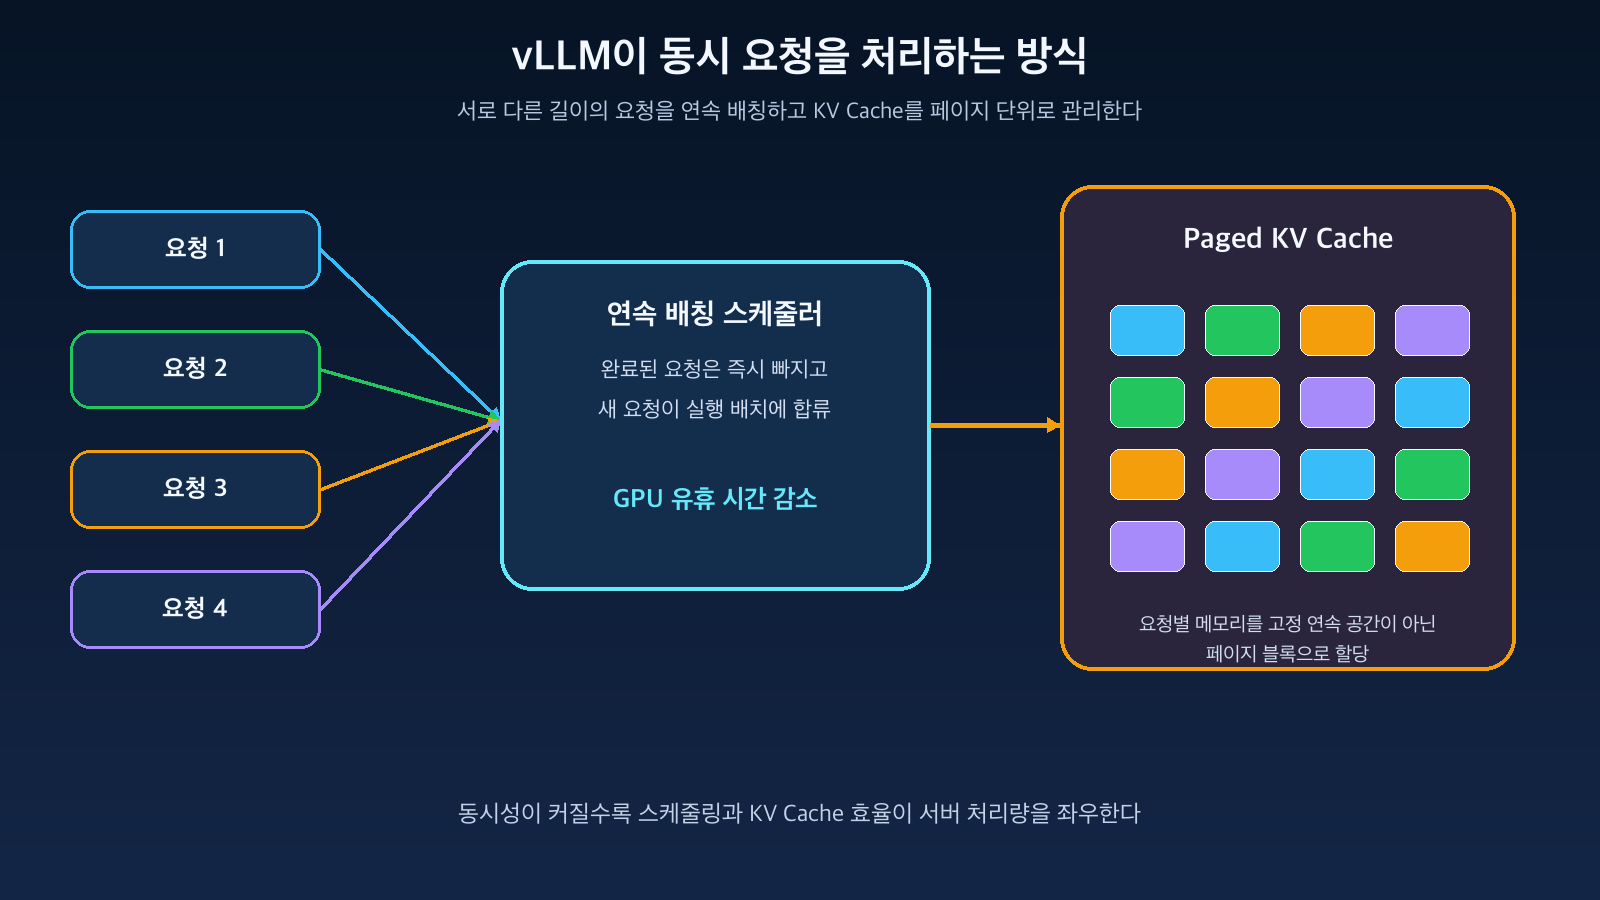
図:vLLMの連続バッチ処理とページ単位KVキャッシュ管理の概念 · vLLM公式ドキュメントを基に再構成
llama.cpp — 小さなランタイムとGGUFでハードウェアの境界を広げる
llama.cppはC/C++ベースの推論プロジェクトです。CPUのみのシステム、Apple Silicon、コンシューマー向けGPU、混合CPU・GPUオフロードといった幅広い環境でモデルを実行できます。
主要なモデル形式はGGUFです。GGUFファイルにはモデルの重みだけでなく、実行に必要なメタデータも一緒に含めることができ、Q4・Q5・Q8のような複数の量子化レベルで配布されます。量子化はメモリ使用量と速度を削減する代わりに、精度損失の可能性を受け入れるトレードオフです。
llama-cli -m model.Q4_K_M.gguf -p "Self-Attention을 설명해줘"llama-serverを使用すると、軽量なHTTPサーバーと基本的なWeb UI、OpenAI互換のChat Completionsエンドポイントを実行できます。
llama-server -m model.Q4_K_M.gguf --port 8080公式READMEでは、並列デコーディング、埋め込み、再ランキング、文法ベースの構造化出力、投機的デコーディングも提供しています。GPUレイヤー数、コンテキストサイズ、バッチ、スレッドなどのオプションを細かく調整できるため、組み込み・エッジ・デスクトップ製品にランタイムを含めたい開発者にとって有利です。
一方、ユーザーはモデルのGGUF互換性、量子化の種類、メモリ予算を理解する必要があります。「同じ7Bモデル」であっても、量子化レベル、コンテキスト長、KVキャッシュの精度によって必要なメモリと結果の品質が異なります。
同じモデルなのにメモリと速度が異なるのはなぜか
ツールよりもまずモデルサイズと実行条件を見るべきです。おおよその重みメモリは次のように考えることができます。
가중치 메모리 ≈ 파라미터 수 × 파라미터당 바이트例えば、8BモデルをFP16で単純計算すると約16GBの重み空間が必要です。4ビット量子化は理論的に約4GBレベルまで削減できますが、実際の実行にはメタデータ、演算バッファ、KVキャッシュ、ランタイムの余裕空間が追加されます。
特にコンテキストが長くなり、同時リクエストが増えるとKVキャッシュが大きくなります。個人用の単一対話ではモデルの重みが主な負担ですが、サーバーでは同時ユーザー数と最大コンテキストが容量計画を大きく変えます。
| 比較基準 | 個人用単一リクエスト | 多人数ユーザーサーバー |
| — | — | — |
| 最大の関心事 | インストール容易性、モデルがメモリに収まるか | スループット、遅延時間、KVキャッシュとバッチ処理 |
| 量子化効果 | 低スペックデバイスでの実行可能性拡大 | GPUあたりの収容モデル・リクエスト数増加の可能性 |
| コンテキスト増加の影響 | 一つの対話のKVキャッシュ増加 | すべてのアクティブなリクエストのKVキャッシュが合計される |
| 代表的な選択 | Ollamaまたはllama.cpp | vLLM中心の検討 |
3つのツールは互いに完全に独立しているわけではない
Ollamaとllama.cppはGGUFとローカル推論という領域で接点があり、vLLMも最新バージョンでGGUFを含む複数の量子化方式をサポートしています。したがって、「GGUFは必ずllama.cpp」、「Hugging Faceモデルは必ずvLLM」のように断定すると、最新の機能を見逃す可能性があります。
しかし、サポートの有無と運用上の適合性は異なります。ある形式を読み込めるという事実と、その形式が当該エンジンの主力パスであるという事実は区別する必要があります。モデルアーキテクチャ、量子化カーネル、ハードウェアバックエンドによって性能と安定性が異なるため、実際の候補モデルでベンチマークを行うべきです。
目的別選択ガイド
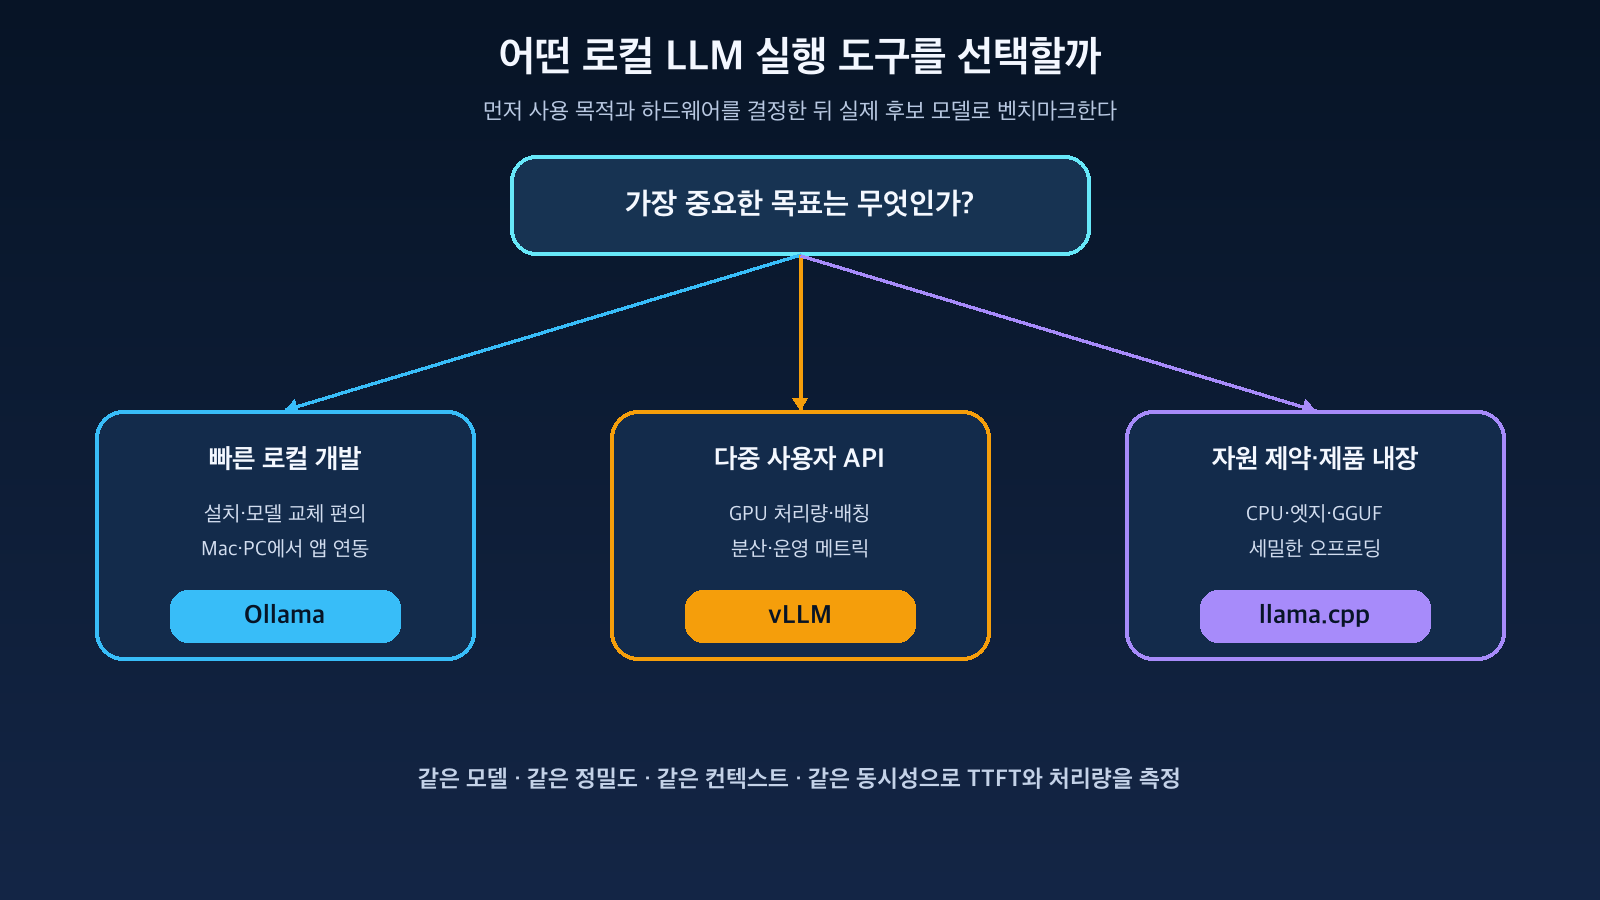
図:使用目的とハードウェアに応じたOllama・vLLM・llama.cppの選択フロー · 3つのプロジェクトの公式ドキュメントを基に再構成
開発者がノートPCでRAGを試す場合
Ollamaが最も便利です。モデルのインストールと交換が簡単で、ローカルAPIがすぐに利用できるため、LangChain、LlamaIndex、Open WebUIなどのツールと連携しやすいです。MacBookのApple SiliconでもMetalアクセラレーションを活用できます。
社内チャットボットを複数人が同時に使用する場合
GPUサーバーでvLLMをまず検討する方が良いでしょう。連続バッチ処理とKVキャッシュ管理、OpenAI互換API、メトリクスと分散実行機能がサービス運用目的に合致します。ただし、認証・TLS・リクエスト制限・テナント分離は別途ゲートウェイで設計する必要があります。
CPUサーバーやエッジデバイスに組み込む場合
llama.cppが強力です。実行ファイルやライブラリの形で組み込むことができ、GGUF量子化とCPU・GPUオフロードを細かく調整できます。
単一GPUで少数のユーザーのみが使用する場合
OllamaとvLLMを同じモデル・同じコンテキスト・同じ同時実行性で測定する必要があります。設定の容易さがより重要であればOllama、リクエスト処理量と運用指標がより重要であればvLLMが有利です。
ベンチマーク時に見落としがちな基準
1秒あたりのトークン数だけで結論を出すべきではありません。
- TTFT (Time To First Token):最初のトークンが出力されるまでの遅延
- TPOT (Time Per Output Token):その後のトークン生成間隔
- 同時リクエスト数が増加した際の総スループット
- 長いプロンプトのプリフィル時間
- 最大コンテキストでのメモリ使用量
- モデルのロード時間とコールドスタート
- 量子化による回答品質の変化
- 障害発生時の再起動、メトリクス、ログ、デプロイ自動化
同じモデル名であっても、精度や量子化ファイルが異なると比較は公平ではありません。入力長、出力長、同時実行性、サンプリングパラメータを固定し、実際の業務プロンプトで測定する必要があります。
運用セキュリティは推論エンジンが代行しない
ローカルで実行されるという理由だけで安全であるとは限りません。APIを他のホストに公開する場合、一般的なサービスセキュリティがそのまま必要になります。
- TLSと認証を適用したAPIゲートウェイ
- ユーザー・アプリケーションごとのレート制限と使用量上限
- モデルファイルとキャッシュディレクトリのアクセス制御
- 信頼できるモデルの出所とハッシュ検証
- プロンプト・応答ログの個人情報マスキング
- コンテナとGPUノードの最小権限
- ツール呼び出しモデルの実行権限の分離と承認
特に、OllamaのローカルAPIをネットワークに直接公開したり、vLLMのAPIキー一つを複数のシステムで共有したり、llama-serverを認証なしでインターネットに接続する構成は避けるべきです。
結論
Ollama、vLLM、llama.cppは優劣ではなく、役割が異なるツールです。
Ollamaはモデルを簡単にダウンロードして実行し、開発ツールと連携するローカル体験に強みがあります。vLLMはGPUサーバーで複数のリクエストを効率的に処理する推論サービスエンジンです。llama.cppはGGUFと軽量なC/C++ランタイムを基盤として、多様なハードウェアと製品組み込み環境に対応します。
ツールを先に選ぶのではなく、ユーザー数、ハードウェア、モデル形式、コンテキスト長、運用方法を定めてから、実際の候補モデルで測定すべきです。
個人実験から始めるならOllama、サービスのスループットが問題ならvLLM、リソース制約とデプロイの柔軟性が重要ならllama.cppが良い出発点となるでしょう。
コメントを残す