最近,当我让Claude Code执行长时间任务时,有时会想:“明明运行得好好的,怎么又挂掉了?”响应停止,上下文压缩时间过长,突然需要重新打开终端,或者原本正常的模型会抛出529 Overloaded和429错误。
另一方面,Codex在同类任务中,有时会给人一种进程更持久、能够管理中间状态并坚持到最后的感觉。因此,一段时间内可能会觉得:“如果只看稳定性,Codex不是更好吗?”
然而,最近的结论却有所不同。即使Claude在中间看起来更频繁地停止,但如果将恢复会话并继续上下文后产生的结果也考虑在内,最终Claude可能会感觉是更稳定、更好的工具。
本文将Claude“挂掉”的现象分为服务故障、本地进程问题、上下文压缩、使用限制和外部工具失败,并探讨通过公开统计数据,Claude Code和Codex的稳定性可以比较到何种程度。
图:进程停止与整个任务消失是不同的问题。
首先,需要将“挂掉”一词分为四种情况
用户看到的现象可能都相似,但原因却可能完全不同。
| 用户看到的症状 | 实际可能的原因 | 检查位置 |
| — | — | — |
| 响应突然中断 | 模型API故障、流式连接终止、网络·代理问题 | 状态页面、错误代码 |
| Claude Code卡顿或停止 | 本地CPU·内存使用量、大型存储库、过多的工具输出 | 活动监视器、/doctor、/context |
| 长时间压缩中 | 上下文过大,执行自动压缩 | /context、/compact |
| 模型选择或调用被拒绝 | 使用限制、错误的授权、429·529 | 错误消息、套餐·状态页面 |
| 命令存活但无法推进工作 | MCP服务器、hook、shell命令、权限请求等待·失败 | MCP·hook日志、终端 |
因此,“Claude模型不稳定”和“Claude Code进程不稳定”不是同一个说法。即使模型服务正常,本地CLI在处理大量日志时也可能停止;即使CLI正常,Anthropic API也可能发生错误。
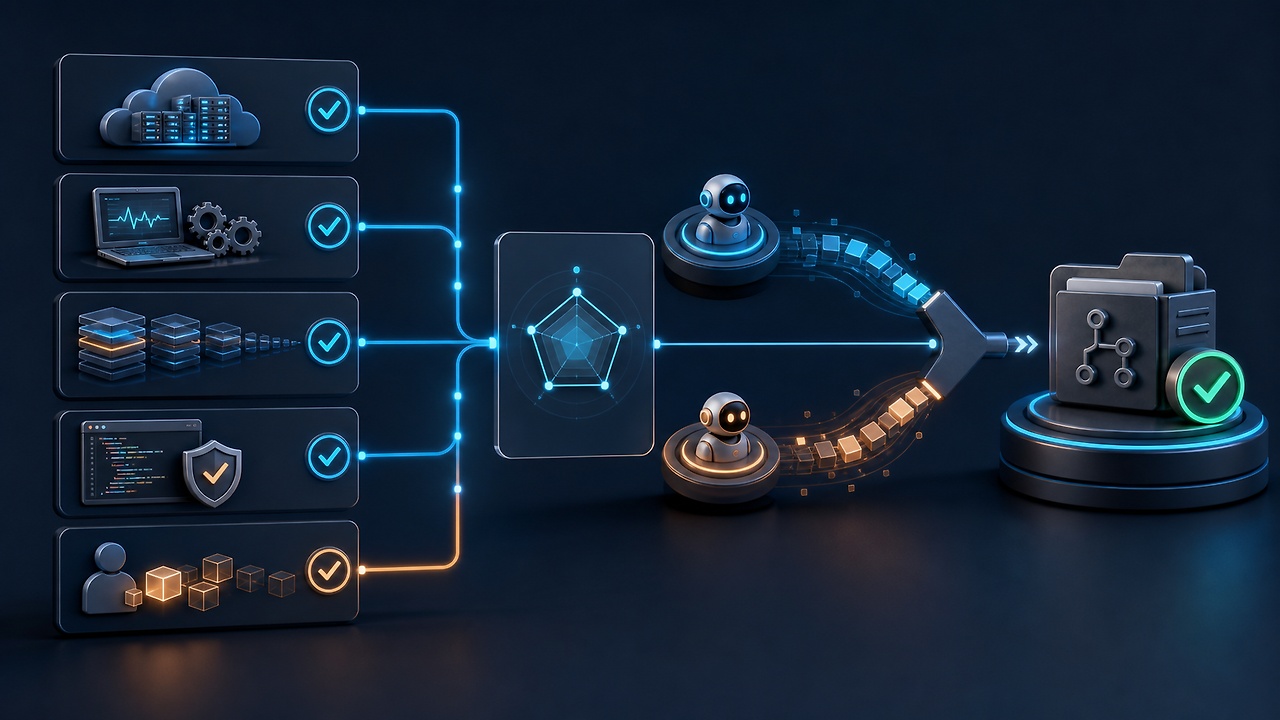
图:即使看起来都是“停止”,原因也分为服务、API、本地资源、外部工具层。
第一个原因:实际的Claude服务故障
Claude“挂掉”的一些原因显然在于服务侧。Anthropic在Claude Status中将claude.ai、Claude API和Claude Code作为独立组件公开。
截至2026年7月30日,Claude Code的公开正常运行时间如下:
| 期间 | Claude Code 公开正常运行时间 |
| — | — |
| 2026年5月 | 99.49% |
| 2026年6月 | 99.45% |
| 2026年7月 | 99.43% |
| 最近90天 | 99.44% |
99.44%看起来是一个很高的数字,但换算成90天,大约相当于12小时的异常状态。当然,这只是状态页面上的组件级别汇总,并不完全等同于特定用户、地区或套餐的实际体验。
7月的事件历史记录中,不仅有按模型划分的错误升高,还有多次影响Claude Code以及Web·远程功能的整体服务中断。特别是7月14日、21日、22日,公开了可能直接影响Claude Code或容器创建等代理任务的故障。
也就是说,当你感觉“是不是只有我的Claude有问题?”时,很可能确实混杂了整体服务问题。如果在同一时间段内,多个存储库和会话都出现类似错误,那么在修改本地设置之前,先查看Claude Status会更快。
第二个原因:429、529和使用限制
Claude Code会调用Claude API来获取模型响应。官方错误文档解释说,CLI中显示的大多数运行时错误都与API错误代码相关联。
典型的例子如下:
429 Too Many Requests
→ 짧은 시간의 요청량 또는 계정 사용 한도와 관련

529 Overloaded
→ Anthropic 서비스가 과부하 상태

500·502·503
→ 서버 또는 중간 네트워크 계층 오류 가능성
从用户角度看,都表现为“Claude停止了”,但应对方式应有所不同。如果是429,盲目重启反而可能加剧情况;如果是529,最好稍等片刻再重试。
还曾出现过套餐内模型突然要求使用积分的问题。Anthropic在2026年7月公布了一起事件,Fable 5错误地向部分Max用户显示了积分要求,并在恢复后建议重新启动Claude Code。
因此,“重新启动进程就解决了”的经验并不总是意味着本地bug得到了修复。在重启期间,服务器的授权或模型路由状态可能已经恢复正常。
第三个原因:大型存储库和过多的工具输出
Anthropic的Claude Code官方故障排除文档将高CPU·内存使用量、挂起和自动压缩抖动作为独立的稳定性问题进行处理。
Claude Code不仅仅是一个简单的聊天窗口。它在一个代理循环中处理存储库搜索、文件读取、差异生成、shell执行、MCP调用和hook执行结果。
사용자 요청
  ↓
저장소 검색
  ↓
여러 파일 읽기
  ↓
명령 실행과 대량 로그
  ↓
도구 결과를 대화 컨텍스트에 추가
  ↓
다음 판단
如果在大型monorepo中执行未指定范围的搜索,或者直接传递数万行的构建日志,本地内存和模型上下文会同时增大。如果再连接多个MCP服务器和hook,从一开始工具定义和持久指令就会占据上下文。
官方文档建议在这种情况下采取以下措施:
- 使用/compact总结大型输出和旧对话。
- 每次完成大型任务后重启Claude Code。
- 指定要保留的内容,例如/compact keep only the plan and the diff。
- 将大型文件操作分离到单独的子代理上下文中。
- 如果不需要之前的对话,请使用/clear。
- 使用/doctor检查安装、设置、MCP和上下文使用情况。
这里重要的是,“给Claude更多的上下文总是更好”的说法并不正确。不相关的日志、旧的失败和重复的指令堆积起来,不仅会降低速度,还会影响判断质量。
第四个原因:自动压缩看起来像“挂掉”了
当上下文窗口变大时,Claude Code会通过总结之前的对话来释放空间。用户此时可能会感觉到长时间的等待或响应停止。
긴 대화와 도구 출력 누적
  ↓
컨텍스트 한계에 접근
  ↓
이전 기록 요약
  ↓
중요 지침과 현재 상태 재구성
  ↓
작업 계속
问题不仅仅是压缩本身。如果Claude在压缩后立即遗漏了刚才的详细条件,或者重新读取文件,然后再次压缩,这种状态反复出现,用户就会觉得代理“挂掉”了。
建议使用/context检查哪些内容占用了空间,并在自然的任务边界直接执行/compact。处理完大型构建日志后,在进入下一个功能开发之前进行总结,这样比突然的自动压缩更具可预测性。
项目根目录下的CLAUDE.md在压缩后会被重新读取,但仅在对话中传递的指令或尚未再次访问的子目录中的指令可能会在体感上消失。必须保留的规则不应只在一次对话中提及,最好放在适当的CLAUDE.md中,这样更稳定。
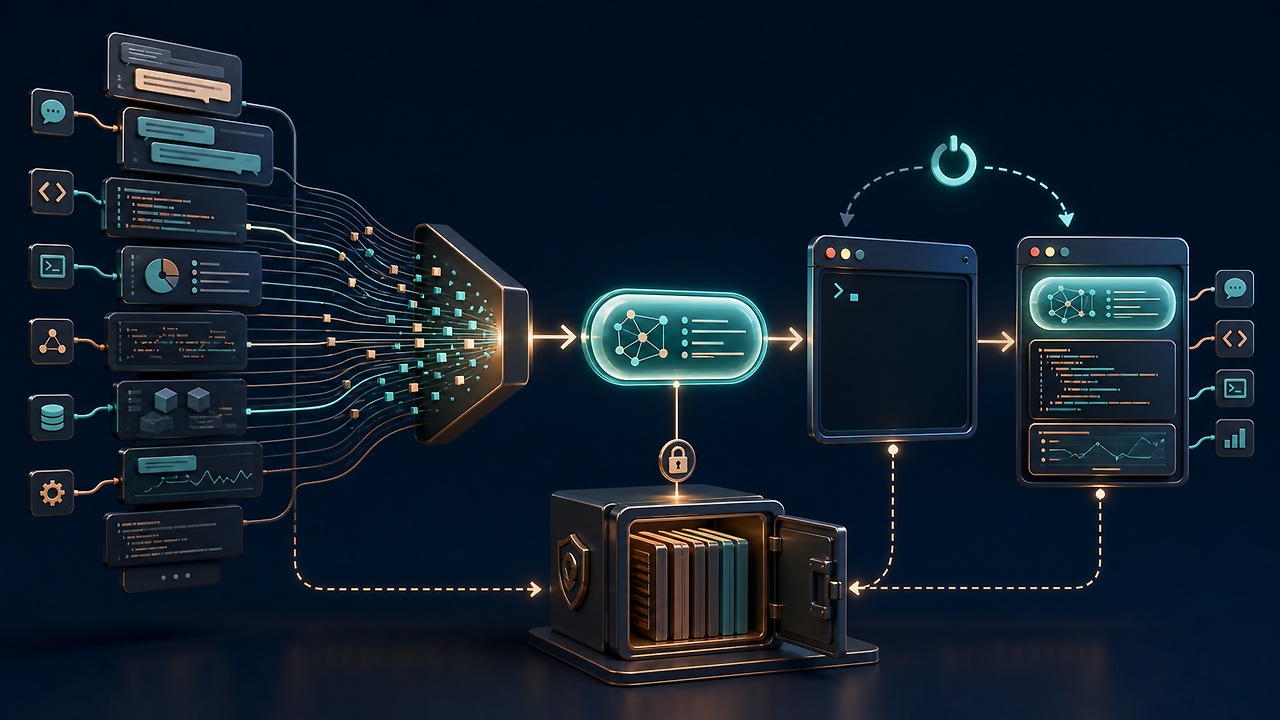
图:上下文会被压缩,但可以通过会话记录和检查点继续工作。
第五个原因:不是Claude,而是MCP·hook·shell“挂掉”了
代理的稳定性取决于其连接组件中最薄弱的环节。
Claude Code
  ├─ shell
  ├─ Git
  ├─ ripgrep
  ├─ MCP server A
  ├─ MCP server B
  ├─ pre-tool hook
  └─ post-tool hook
如果MCP服务器没有响应或hook没有终止,Claude Code界面可能会显示模型停止。如果权限确认窗口隐藏在其他窗口后面,也会出现类似情况。
在这种情况下,多次更换模型帮助不大。以下顺序更有效:
- 检查是否可以通过Ctrl+C取消当前任务。
- 使用/doctor检查MCP和设置状态。
- 暂时禁用最近添加的MCP服务器和hook,查看问题是否重现。
- 长时间运行的shell命令在单独的终端中执行,检查是否终止。
- 如果处于代理、VPN、TLS检查环境中,请检查API和包下载路径。
Claude Code的官方文档也说明,如果命令挂起无法解决,可以关闭终端并重新启动。
重要事实:即使进程“挂掉”,会话通常也还活着
Claude Code在对话过程中会将会话持续保存到本地记录中。根据官方文档,CLI会话以项目特定的JSONL文件形式记录。
因此,关闭终端并不意味着工作记录一定会消失。
# 继续当前项目的最新会话
claude --continue

# 打开会话选择器
claude --resume

# 按名称或会话ID继续
claude --resume auth-refactor
当Claude Code停止时,官方故障排除也提示:“即使关闭并重新启动终端,您也不会丢失对话,可以在同一目录下使用claude –resume进行恢复。”
这正是让Claude再次感觉稳定的核心。进程存活率和任务可恢复性是不同的指标。
Codex真的更稳定吗?
从体感上讲,Codex看起来更稳定是有原因的。它将长时间任务分阶段和状态管理,在工具执行过程中持续与用户沟通,并将任务分离到不同的环境或线程中,这种产品结构减少了“一个进程停止了”的印象。
然而,Codex的公开事件也不少。从2026年5月到7月,OpenAI状态页面记录了以下案例:
| 时期 | 公开的Codex相关案例 |
| — | — |
| 5月 | Codex Cloud·Code Review高失败率,Codex 5.5高错误率,上下文压缩延迟,速率限制问题 |
| 6月 | Codex容量错误,Cloud任务错误,访问令牌问题,使用限制消耗快于预期的问题 |
| 7月 | 5.6-sol过载,Desktop·CLI访问被拒绝,GitHub依赖工作流错误,Codex Review错误 |
2026年6月2日的故障中,由于速率限制依赖项异常,Codex请求被错误地以HTTP 429拒绝。7月19日,由于区域数据库容量问题,部分Codex请求失败。
也就是说,没有证据可以得出Codex在结构上绝不会“挂掉”的结论。然而,当错误发生时,其UI显示状态的方式、分离任务的方式以及保留重试和中间结果的方式,可能会让它感觉更稳定。
能否通过统计数据直接比较Claude和Codex?
结论是:仅凭目前公开的资料,难以进行公平的直接比较。
Anthropic公开了Claude Code这一独立组件的月度·90天正常运行时间。而OpenAI状态页面虽然公开了Codex组件和事件历史,但并未在同一页面提供可比较的Codex月度正常运行时间百分比。
此外,事件记录标准也因公司而异。
| 比较项目 | Anthropic | OpenAI |
| — | — | — |
| 产品状态 | Claude Code组件单独提供 | Codex组件单独提供 |
| 月度正常运行时间百分比 | Claude Code公开 | 公开页面无法查看相同格式的Codex数据 |
| 事件历史 | 按模型·产品细分非常多 | 捆绑多个产品的事件与Codex专用事件混杂 |
| 用户差异 | 可能因套餐·地区·模型而异 | 明确说明可能因层级·模型·功能而异 |
因此,仅仅计算事件数量就说“Claude更不稳定”,可能会对公开政策更细致的公司造成不利评价。反之,仅凭Claude Code的99.44%就断定单个会话稳定也是不正确的。状态页面无法捕捉所有本地进程崩溃、MCP挂起或因大量日志引起的内存问题。
要进行公平比较,同一团队需要直接测量以下指标:
- 在无人干预下完成的已启动任务的比例
- 每个会话强制重启的次数
- 429·5xx·流断开的次数
- 上下文压缩时间和失败率
- 重启后恢复原始任务的比例
- 通过测试并完成评审的比例
- 人工修改的代码量和回滚的更改量
有了这些数据,才能比较“工作成功率”而非“服务正常运行时间”。
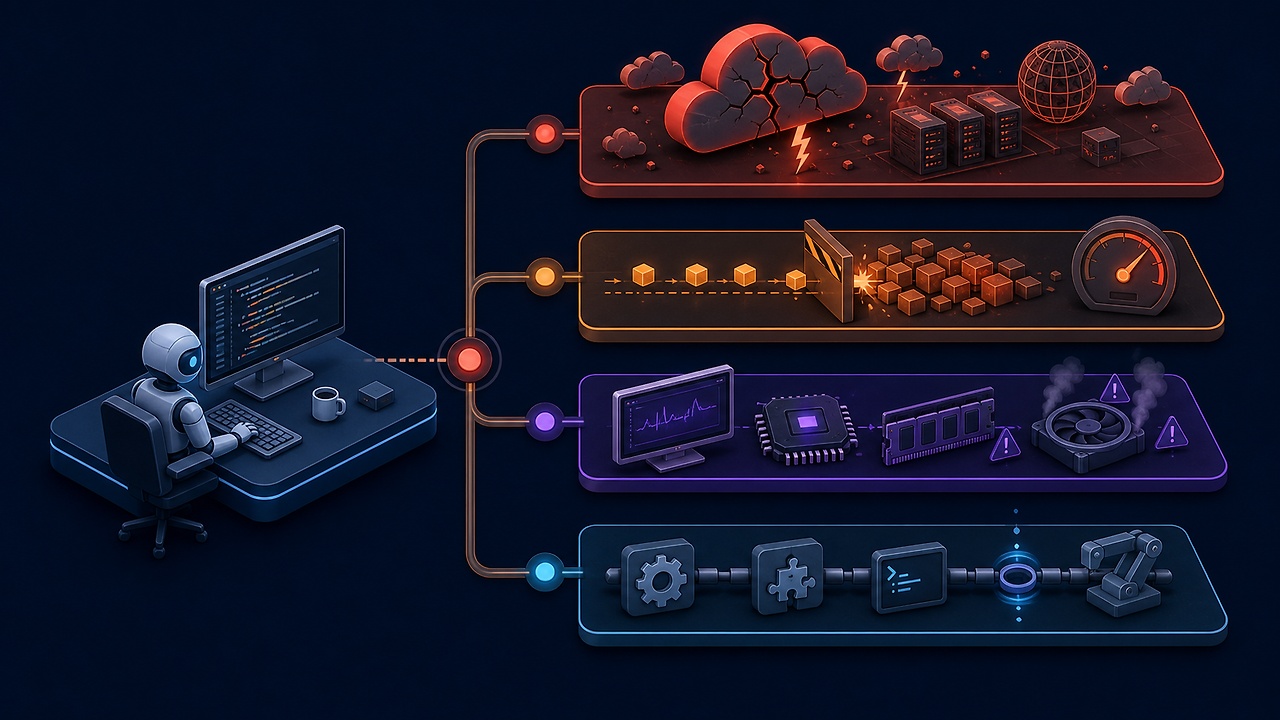
图:实际稳定性不仅要衡量正常运行时间,还要衡量可恢复性、结果质量和人工返工。
为什么最终Claude会感觉更稳定、更好?
如果将稳定性简单定义为进程从未停止,那么有些时候Codex看起来会更好。然而,在实际开发工作中,以下问题更为重要:
한 번도 멈추지 않았는가?
보다
멈춰도 작업을 잃지 않았는가?

오래 실행됐는가?
보다
원하는 수준의 결과를 만들었는가?
Claude Code持续保存会话,可以通过–resume恢复,并使用/compact、/clear、subagent管理上下文。如果Claude的代码理解和产出更符合自己的工作方式,那么即使承担中间重启的成本,整体生产力也可能更高。
最终,最近的结论是:
Codex有时看起来能坚持更久,但Claude在停止后更容易恢复工作,并且对结果的信任度更高,最终感觉是更稳定、更好的工具。
这个结论并非适用于所有用户的客观排名。也不能仅凭公开统计数据就断定哪一个更稳定。但是,如果将稳定性定义为“不丢失工作并达到预期结果的能力”,而非“进程正常运行时间”,那么选择Claude的原因就解释得通了。
Claude频繁“挂掉”时的实际操作方法
最后,实际操作方法总结如下:
将任务分解成小块
不要在一个会话中处理调查、实现、大规模测试和文档编写等所有任务。在每个功能边界创建提交或检查点,然后进入下一个会话。
将大输出保存到文件中
不要将数万行的日志直接放入对话中,而是将其保存到文件中,然后只搜索错误部分。
pytest -vv > /tmp/test-output.log 2>&1
rg -n "FAILED|ERROR|Traceback" /tmp/test-output.log
在自然时机手动压缩
任务完成后,在下一个请求之前,像这样进行压缩:
/compact 구현된 파일, 남은 실패 테스트, 다음 단계만 유지给会话命名
/rename auth-refactor即使停止后,也可以通过以下命令轻松找到:
claude --resume auth-refactor分离状态页面和本地诊断
如果多个会话同时失败,请首先查看状态页面。如果只在一个存储库中重现,请检查/doctor、/context以及MCP和hook设置。
直接记录结果稳定性
将Claude和Codex用于同类任务,并简单记录完成率、重启次数、测试通过率和修改量。体感很重要,但有记录可以帮助您更快地判断哪个工具更适合您的工作流程。
总结
Claude总是“挂掉”的感觉并非错误。确实发生过服务故障,官方文档也承认高CPU·内存、挂起和自动压缩问题,并建议重启和恢复作为应对方法。
但仅凭这一点,很难得出Claude是更不稳定工具的结论。Codex也曾出现过过载、访问被拒绝、压缩延迟、速率限制和Cloud任务失败,而且两家公司并未公开相同标准的正常运行时间统计数据。
因此,实际工作中的稳定性更接近以下公式:
실무 안정성
= 서비스 가용성
+ 로컬 프로세스 안정성
+ 세션 복구 가능성
+ 결과 품질
+ 사람이 다시 해야 하는 작업의 양
按照这个标准来看,即使Claude偶尔停止,但如果能够恢复会话并持续产生良好的结果,那么对于用户而言,Claude最终可能是一个更稳定、更好的工具。
参考资料
- Claude Status
- Claude Code Uptime History
- Claude Incident History
- Claude Code Troubleshooting
- Claude Code Error Reference
- Claude Code Session Management
- Claude Code Memory
- OpenAI Status
- OpenAI Status History
- OpenAI incident: Codex·ChatGPT·Responses API elevated errors
- OpenAI incident: Some Codex requests failed
发表回复