最近、Claude Codeに長い作業をさせると、「順調だったのに、なぜまた停止したのだろう?」と思うことがあります。応答が止まったり、コンテキストの圧縮が長引いたり、突然ターミナルを再起動しなければならなくなったり、問題なかったモデルが529 Overloadedや429エラーを出すこともあります。
一方、Codexは同じ種類の作業でプロセスがより長く持ちこたえ、中間状態を管理しながら最後まで作業を続けるような印象を与えることがあります。そのため、しばらくの間は「安定性だけを見ればCodexの方が優れているのではないか?」と考えるかもしれません。
しかし、最近ではむしろ結論が少し変わってきました。Claudeが途中でより頻繁に停止するように見えても、セッションを復活させて再びコンテキストを継続した結果まで含めると、結局Claudeの方がより安定していて良いツールだと感じられることがあります。
この記事では、Claudeが「停止する」現象をサービス障害、ローカルプロセス問題、コンテキスト圧縮、使用制限、外部ツール失敗に分け、公開されている統計でClaude CodeとCodexの安定性をどこまで比較できるかを見ていきます。
図:プロセスが停止することと、作業全体が失われることは異なる問題である。
まず「停止する」という言葉を4つに分ける必要がある
ユーザーが見る現象はすべて似ていますが、原因は全く異なる場合があります。
| ユーザーが見る症状 | 実際に考えられる原因 | 確認する場所 |
| — | — | — |
| 応答が突然途切れる | モデルAPI障害、ストリーミング接続終了、ネットワーク・プロキシ問題 | ステータスページ、エラーコード |
| Claude Codeがもたつく、または停止する | ローカルCPU・メモリ使用量、大きなリポジトリ、過度なツール出力 | アクティビティモニタ、/doctor、/context |
| 長時間圧縮中である | コンテキストが大きくなり、自動圧縮が実行される | /context、/compact |
| モデル選択や呼び出しが拒否される | 使用制限、誤ったエンタイトルメント、429・529 | エラーメッセージ、料金プラン・ステータスページ |
| コマンドは生きているが、作業が進まない | MCPサーバー、hook、shellコマンド、権限要求が待機・失敗 | MCP・hookログ、ターミナル |
したがって、「Claudeモデルが不安定である」と「Claude Codeプロセスが不安定である」は同じ文ではありません。モデルサービスが正常であっても、ローカルCLIが大きなログを処理中に停止することがありますし、CLIが正常であってもAnthropic APIでエラーが発生することがあります。
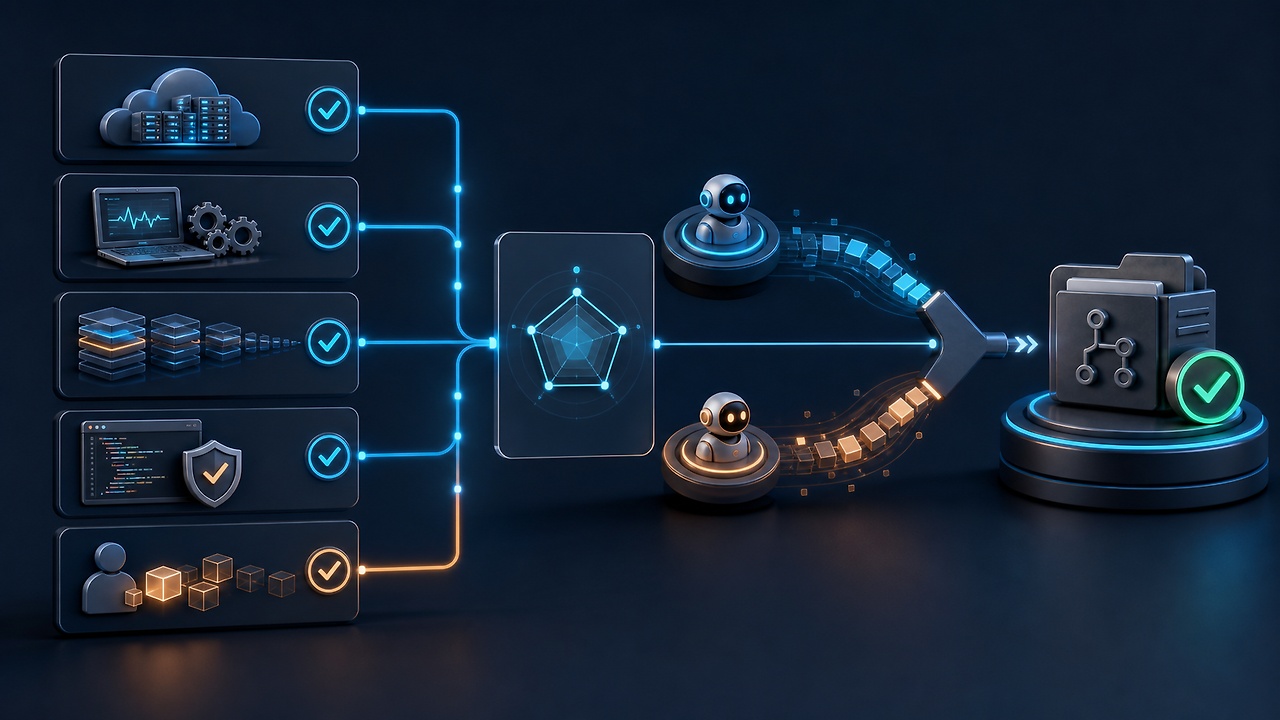
図:同じ「停止」に見えても、原因はサービス、API、ローカルリソース、外部ツール層に分かれる。
最初の原因:実際のClaudeサービス障害
Claudeが停止する理由の一部は、明らかにサービス側にあります。AnthropicはClaude Statusでclaude.ai、Claude API、Claude Codeを個別のコンポーネントとして公開しています。
2026年7月30日に確認したClaude Codeの公開稼働時間は以下の通りです。
| 期間 | Claude Code 公開稼働時間 |
| — | — |
| 2026年5月 | 99.49% |
| 2026年6月 | 99.45% |
| 2026年7月 | 99.43% |
| 最近90日 | 99.44% |
99.44%は高い数字に見えますが、90日に換算すると約12時間の異常状態に相当します。もちろん、この計算はステータスページのコンポーネントレベルの集計に過ぎず、特定のユーザー・地域・料金プランの実際の経験と正確に一致するわけではありません。
7月のインシデント履歴には、モデルごとのエラー増加だけでなく、Claude Codeとウェブ・リモート機能に共に影響を与えたサービス中断も複数回記録されています。特に7月14日、21日、22日には、Claude Codeやコンテナ作成など、エージェント作業に直接影響を与える可能性のある障害が公開されました。
つまり、「私のClaudeだけがおかしいのか?」と感じる時、実際に全体的なサービス問題が混ざっている可能性は十分にあります。同じ時間帯に複数のリポジトリとセッションで同様のエラーが発生した場合は、ローカル設定を修正する前にClaude Statusを確認する方が早いです。
2番目の原因:429、529と使用制限
Claude Codeはモデル応答のためにClaude APIを呼び出します。公式のエラー文書では、CLIに表示されるランタイムエラーのほとんどがAPIエラーコードと関連していると説明されています。
代表的な事例は以下の通りです。
429 Too Many Requests
→ 짧은 시간의 요청량 또는 계정 사용 한도와 관련

529 Overloaded
→ Anthropic 서비스가 과부하 상태

500·502·503
→ 서버 또는 중간 네트워크 계층 오류 가능성
ユーザーの観点からはすべて「Claudeが停止した」ように見えますが、対応は異なります。429であれば、むやみに再実行すると状況を悪化させる可能性があり、529であれば、しばらく待ってから再試行する方が良いでしょう。
料金プランに含まれるモデルが突然使用クレジットを要求する問題もありました。Anthropicは2026年7月にFable 5が一部のMaxユーザーに誤ったクレジット要求を表示したインシデントを公開し、復旧後にClaude Codeを再起動するよう案内しました。
したがって、「プロセスを再起動したら解決した」という経験が常にローカルバグが修正されたことを意味するわけではありません。再起動中にサーバーのエンタイトルメントやモデルルーティングの状態が正常化された可能性もあります。
3番目の原因:大きなリポジトリと過度なツール出力
AnthropicのClaude Code公式トラブルシューティング文書では、高CPU・メモリ使用量、ハング、自動圧縮のスラッシングを個別の安定性問題として扱っています。
Claude Codeは単なるチャットウィンドウではありません。リポジトリ検索、ファイル読み込み、差分生成、シェル実行、MCP呼び出し、フック実行結果を1つのエージェントループで処理します。
사용자 요청
  ↓
저장소 검색
  ↓
여러 파일 읽기
  ↓
명령 실행과 대량 로그
  ↓
도구 결과를 대화 컨텍스트에 추가
  ↓
다음 판단
大規模なモノレポで範囲を指定せずに検索させたり、数万行のビルドログをそのまま渡したりすると、ローカルメモリとモデルコンテキストが同時に大きくなります。これに複数のMCPサーバーとフックが接続されると、開始時からツール定義と永続的な指示がコンテキストを占有します。
公式文書では、このような場合、以下の対応を推奨しています。
- /compactで大きな出力と古い会話を要約します。
- 大きな作業が終わるたびにClaude Codeを再起動します。
- /compact keep only the plan and the diffのように残す内容を指定します。
- 大きなファイル作業は別のサブエージェントのコンテキストに分離します。
- 以前の会話が不要な場合は/clearを使用します。
- /doctorでインストール、設定、MCP、コンテキスト使用量を点検します。
ここで重要なのは、「Claudeにより多くのコンテキストを与えれば常に良くなる」わけではないということです。関係のないログ、古い失敗、重複した指示が積み重なると、速度だけでなく判断品質も低下する可能性があります。
4番目の原因:自動圧縮が停止したように見える
コンテキストウィンドウが大きくなると、Claude Codeは以前の会話を要約してスペースを確保します。ユーザーはこの時、長い待機時間や応答停止のように感じることがあります。
긴 대화와 도구 출력 누적
  ↓
컨텍스트 한계에 접근
  ↓
이전 기록 요약
  ↓
중요 지침과 현재 상태 재구성
  ↓
작업 계속
問題は圧縮自体だけではありません。圧縮直後にClaudeが直前の詳細条件を見落としたり、再びファイルを読み込んだり、再度圧縮したりする状態が繰り返されると、ユーザーはエージェントが停止したと感じます。
/contextで何がスペースを占めているかを確認し、自然な作業境界で直接/compactを実行することをお勧めします。大規模なビルドログを処理した後、次の機能開発に進む前に要約するようにすれば、突然の自動圧縮よりも予測可能になります。
プロジェクトルートのCLAUDE.mdは圧縮後に再度読み込まれますが、会話でのみ伝達された指示やまだアクセスしていないサブディレクトリの指示は、体感上消えてしまうことがあります。必ず維持されるべきルールは、一度の会話だけでなく、適切なCLAUDE.mdに置いておく方が安定しています。
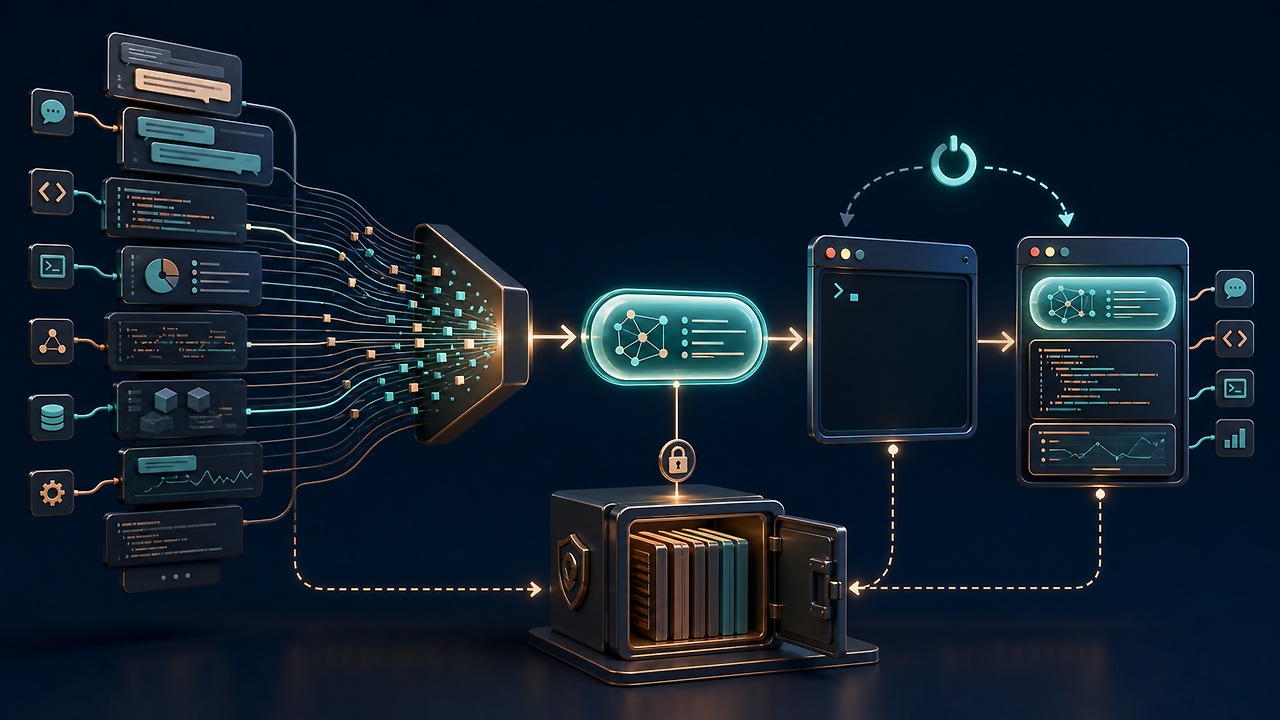
図:コンテキストは圧縮されるが、セッション記録とチェックポイントを利用して作業を再開できる。
5番目の原因:ClaudeではなくMCP・hook・shellが停止する
エージェントは、接続されたコンポーネントの中で最も弱いリンクと同じくらい安定しています。
Claude Code
  ├─ shell
  ├─ Git
  ├─ ripgrep
  ├─ MCP server A
  ├─ MCP server B
  ├─ pre-tool hook
  └─ post-tool hook
MCPサーバーが応答しない、またはhookが終了しない場合、Claude Codeの画面はモデルが停止したように見えることがあります。権限確認ウィンドウが他のウィンドウの裏に隠れている場合も同様です。
この場合、モデルを何度も変更しても大きな助けにはなりません。次の手順の方が効率的です。
- Ctrl+Cで現在の作業をキャンセルできるか確認します。
- /doctorでMCPと設定の状態を点検します。
- 最近追加したMCPサーバーとhookを一時的に無効にして、再現するかどうかを確認します。
- 時間がかかるshellコマンドは別のターミナルで実行し、終了したかどうかを確認します。
- プロキシ、VPN、TLSインスペクション環境の場合は、APIとパッケージのダウンロードパスを点検します。
Claude Codeの公式文書も、コマンドのハングが解消されない場合はターミナルを閉じて再起動できると説明しています。
重要な事実:プロセスが停止してもセッションは通常生きている
Claude Codeは会話を進めながらセッションをローカルトランスクリプトに継続的に保存します。公式文書によると、CLIセッションはプロジェクトごとのJSONLファイルとして記録されます。
したがって、ターミナルを閉じたからといって作業履歴まで必ず消えるわけではありません。
# 現在のプロジェクトの最新セッションを再開する
claude --continue

# セッションセレクターを開く
claude --resume

# 名前またはセッションIDで再開する
claude --resume auth-refactor
Claude Codeが停止した際、公式トラブルシューティングも「ターミナルを閉じて再起動しても会話は失われず、同じディレクトリでclaude –resumeで復旧できる」と案内しています。
この部分がClaudeを再び安定的に感じさせる核心です。プロセス生存率と作業復旧可能性は異なる指標です。
Codexは本当に安定しているのか
体感上、Codexの方が安定しているように見える理由はあります。長い作業を段階と状態で管理し、ツール実行中にユーザーと継続的にコミュニケーションを取り、作業を別の環境やスレッドに分離する製品構造が、「一つのプロセスが停止した」という印象を軽減します。
しかし、Codexも公開されているインシデントは少なくありません。2026年5月から7月まで、OpenAIのステータスページには以下の事例が記録されています。
| 時期 | 公開されたCodex関連事例 |
| — | — |
| 5月 | Codex Cloud・Code Reviewの障害発生率が高い、Codex 5.5のエラー率が高い、コンテキスト圧縮の遅延、レート制限の問題 |
| 6月 | Codex容量エラー、Cloudタスクエラー、アクセストークン問題、使用制限が予想より早く消費される問題 |
| 7月 | 5.6-sol過負荷、Desktop・CLIアクセス拒否、GitHub依存ワークフローエラー、Codex Reviewエラー |
2026年6月2日の障害では、レート制限の依存関係が異常状態になり、Codexリクエストが誤ったHTTP 429で拒否されました。7月19日には、地域データベースの容量問題により一部のCodexリクエストが失敗しました。
つまり、Codexが構造的に絶対に停止しないという結論を出す根拠はありません。ただし、エラーが発生した際にUIが状態を表示する方法、作業を分離する方法、再試行と中間結果を保存する方法によって、より安定していると感じられることがあります。
統計でClaudeとCodexを直接比較できるか
結論から言うと、現在公開されている資料だけでは公平な直接比較は困難です。
AnthropicはClaude Codeという個別のコンポーネントの月別・90日間の稼働時間を公開しています。一方、OpenAIのステータスページはCodexコンポーネントとインシデント履歴を公開していますが、同じ画面で比較可能なCodexの月別稼働時間パーセンテージは提供していません。
また、インシデント登録基準も会社によって異なります。
| 比較項目 | Anthropic | OpenAI |
| — | — | — |
| 製品別ステータス | Claude Codeコンポーネントを別途提供 | Codexコンポーネントを別途提供 |
| 月別稼働時間パーセンテージ | Claude Codeで公開 | 公開ページで同じ形式のCodex数値は確認不可 |
| インシデント履歴 | モデル別・製品別に非常に細分化されている | 複数の製品をまとめたインシデントとCodex専用インシデントが混在 |
| ユーザー別の違い | 料金プラン・地域・モデルによって異なる場合がある | ティア・モデル・機能によって異なる場合があると明記 |
したがって、インシデントの数だけを数えて「Claudeの方が不安定だ」と言うと、公開ポリシーがより細分化されている会社を不利に評価することになります。逆に、Claude Codeの99.44%だけを見て個別のセッションが安定していると断定するのも間違いです。ステータスページは、ローカルプロセスのクラッシュ、MCPのハング、大きなログによるメモリ問題をすべて捕捉するわけではありません。
公平な比較を行うには、同じチームで以下を直接測定する必要があります。
- 開始した作業のうち、人間の介入なしに完了した割合
- セッションあたりの強制再起動回数
- 429・5xx・ストリーム切断回数
- コンテキスト圧縮時間と失敗率
- 再起動後に元の作業を復旧した割合
- テスト合格とレビューまで完了した割合
- 人間が修正したコード量と元に戻した変更量
このようなデータがあって初めて、「サービス稼働時間」ではなく「業務成功率」を比較できます。
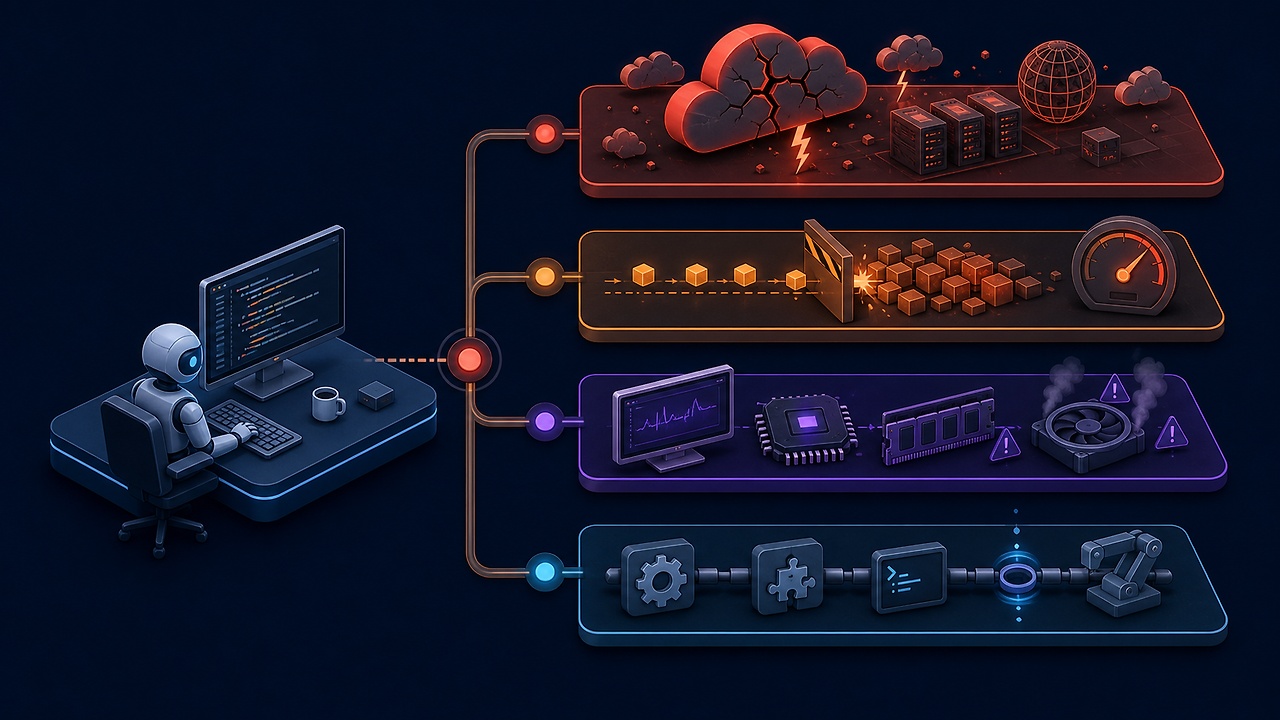
図:実務の安定性は、稼働時間だけでなく、復旧可能性、結果の品質、人間の再作業まで含めて測定する必要がある。
なぜ結局Claudeの方が安定していて良いと感じられるのか
安定性を単にプロセスが一度も停止しないことと定義すれば、Codexの方が優れているように見える日もあります。しかし、実際の開発業務では次の質問の方が重要です。
한 번도 멈추지 않았는가?
보다
멈춰도 작업을 잃지 않았는가?

오래 실행됐는가?
보다
원하는 수준의 결과를 만들었는가?
Claude Codeはセッションを継続的に保存し、–resumeで復旧でき、/compact、/clear、サブエージェントでコンテキストを管理できます。Claudeのコード理解と成果物が自身の業務方式により合致するなら、中間での再起動コストを許容しても、全体の生産性はより高くなる可能性があります。
結局、最近の結論はこうです。
Codexはより長く持ちこたえるように見えることがあるが、Claudeは停止した後でも作業を復旧しやすく、結果に対する信頼が高いため、結局より安定していて良いツールだと感じられる。
この結論は、すべてのユーザーに適用される客観的な順位ではありません。公開統計だけでどちらがより安定していると断定することもできません。ただし、安定性を「プロセス稼働時間」ではなく「作業を失わずに望む結果まで到達する能力」と定義すれば、Claudeを選択し続ける理由が説明されます。
Claudeが頻繁に停止する際に使用する現実的な運用方法
最後に、実際の運用方法をまとめると以下の通りです。
作業を細かく分ける
1つのセッションで調査、実装、大規模テスト、ドキュメント作成まですべて処理しません。機能の境界ごとにコミットやチェックポイントを作成し、次のセッションに進みます。
大きな出力はファイルに保存する
数万行のログを会話に直接入れず、ファイルに保存した後、エラー部分だけを検索させます。
pytest -vv > /tmp/test-output.log 2>&1
rg -n "FAILED|ERROR|Traceback" /tmp/test-output.log
自然なタイミングで直接圧縮する
作業が終了した後、次のリクエストの前に次のように圧縮します。
/compact 구현된 파일, 남은 실패 테스트, 다음 단계만 유지セッションに名前を付ける
/rename auth-refactor停止した後でも、次のコマンドで簡単に見つけられるようになります。
claude --resume auth-refactorステータスページとローカル診断を分離する
複数のセッションが同時に失敗した場合は、まずステータスページを確認します。1つのリポジトリでのみ再現する場合は、/doctor、/context、MCPとhookの設定を確認します。
結果の安定性を直接記録する
ClaudeとCodexを同じ種類の作業に使用し、完了率、再起動、テスト合格、修正量を簡単に記録します。体感は重要ですが、記録があれば、どのツールが自身のワークフローに合っているかをより早く判断できます。
まとめ
Claudeが頻繁に停止するという感覚は間違いではありません。実際にサービス障害があり、公式文書も高いCPU・メモリ使用量、ハング、自動圧縮の問題を認め、再起動と再開を対応方法として案内しています。
しかし、それだけでClaudeが不安定なツールだと結論付けるのは困難です。Codexにも過負荷、アクセス拒否、圧縮遅延、レート制限、Cloudタスク失敗があり、両社が同じ基準の稼働時間統計を公開しているわけでもありません。
したがって、実務における安定性は次の式に近いです。
실무 안정성
= 서비스 가용성
+ 로컬 프로세스 안정성
+ 세션 복구 가능성
+ 결과 품질
+ 사람이 다시 해야 하는 작업의 양
この基準で見ると、Claudeが時々停止しても、セッションを復旧して良い結果を出し続けられるのであれば、ユーザーにとっては結局Claudeの方がより安定していて良いツールであると言えるでしょう。
参考文献
- Claude Status
- Claude Code Uptime History
- Claude Incident History
- Claude Code Troubleshooting
- Claude Code Error Reference
- Claude Code Session Management
- Claude Code Memory
- OpenAI Status
- OpenAI Status History
- OpenAI incident: Codex·ChatGPT·Responses API elevated errors
- OpenAI incident: Some Codex requests failed
コメントを残す