Unicode标准化是将视为相同字符的字符串表示形式统一为特定形式的处理。韩语字符가也可以表示为单个完成字符或初声·中声的组合。尽管在屏幕上看起来相似,但在Python字符串中占用的位置数可能不同。
这种差异在个人信息处理中连接检测和替换时会成为问题。如果在标准化字符串中找到的起始·结束位置直接应用于标准化前的原文,可能会残留部分准确检测到的标记。首先要确认的是,两个阶段是否使用相同的字符串,而不仅仅是检测阈值。
Presidio韩语回归测试解释了实体类型和正确区间,个人信息处理的4阶段结构描述了检测后的策略和处理。本文通过合成示例验证了其间的字符串和位置一同传递的契约。未实际使用个人信息或业务日志。
这是AI生成的概念图。不代表实际屏幕或测量结果。
1. 字符가不保证只占用一个位置
码点是Unicode中用于识别字符的编号。下面两个字符串的开头部分,经过标准化后会变成相同的가。
composed = "uac00"          # Ga: U+AC00
decomposed = "u1100u1161" # G + A: U+1100, U+1161第一个有一个码点,第二个有两个。这里的分解子母音不是随意附加的ㄱ·ㅏ(兼容用子母音)示例,而是Unicode中用于韩语组合的ᄀ·ᅡ。Unicode标准化标准的韩语示例
NFC是规范分解后将可能组合合并的形式,NFD是规范分解的形式。在此示例中,NFC会得到가,NFD会得到가。Python的unicodedata.normalize()可以执行这两种转换。Python unicodedata
import unicodedata

original = "u1100u1161 DEMO-AB12!"
normalized = unicodedata.normalize("NFC", original)
print(len(original), len(normalized))实际输出是13 12。DEMO-AB12是本文中创建的练习标记,并非实际账户或标识符格式的复制值。总长度减少一个的原因是标记前的韩语组合。
len()在此Python示例中计算码点数。不应假定它与屏幕上可见的字符块数量或UTF-8字节数是相同的单位。外部客户端使用UTF-16位置的问题需要额外验证,但本次测试仅限于Python字符串内部的NFC·NFD差异。
2. 检测到的标记不变,但掩码位置发生变化
Presidio的分析结果包含entity_type、start、end等项目。Anonymizer同时接收要处理的text和分析结果。在这种结构中,位置属于哪个文本至关重要。Presidio Anonymizer官方示例
以下是在每个字符串中找到相同标记的实际结果。结束位置不包含在内,类似于Python切片。
| 输入表示 | 总长度 | 标记位置 [start:end] |
从该输入中截取的值 |
|---|---|---|---|
u1100u1161 DEMO-AB12! |
13 | [3:12] |
DEMO-AB12 |
用NFC创建的가 DEMO-AB12! |
12 | [2:11] |
DEMO-AB12 |
两次检测都正确。错误发生在将NFC结果[2:11]应用于第一个字符串时。在原文中,该区间是" DEMO-AB1"。它包含了前面的空格,并遗漏了标记的最后一个数字2。
wrong = original[:2] + "<DEMO>" + original[11:]实际结果是"u1100u1161。反之,如果将NFD中找到的[3:12]用于NFC字符串,则会选择"EMO-AB12!"。问题不仅在于长度缩短的方向,长度增加的方向也会产生相同类型的错误。
这是混合了不同文本坐标的应用程序集成错误。仅凭此结果不能断言Presidio本身存在Unicode错误。本次验证通过使用标准库正则表达式和Python切片查找固定标记,分离位置契约,从而重现了问题,而未运行已安装的Presidio或NLP模型。
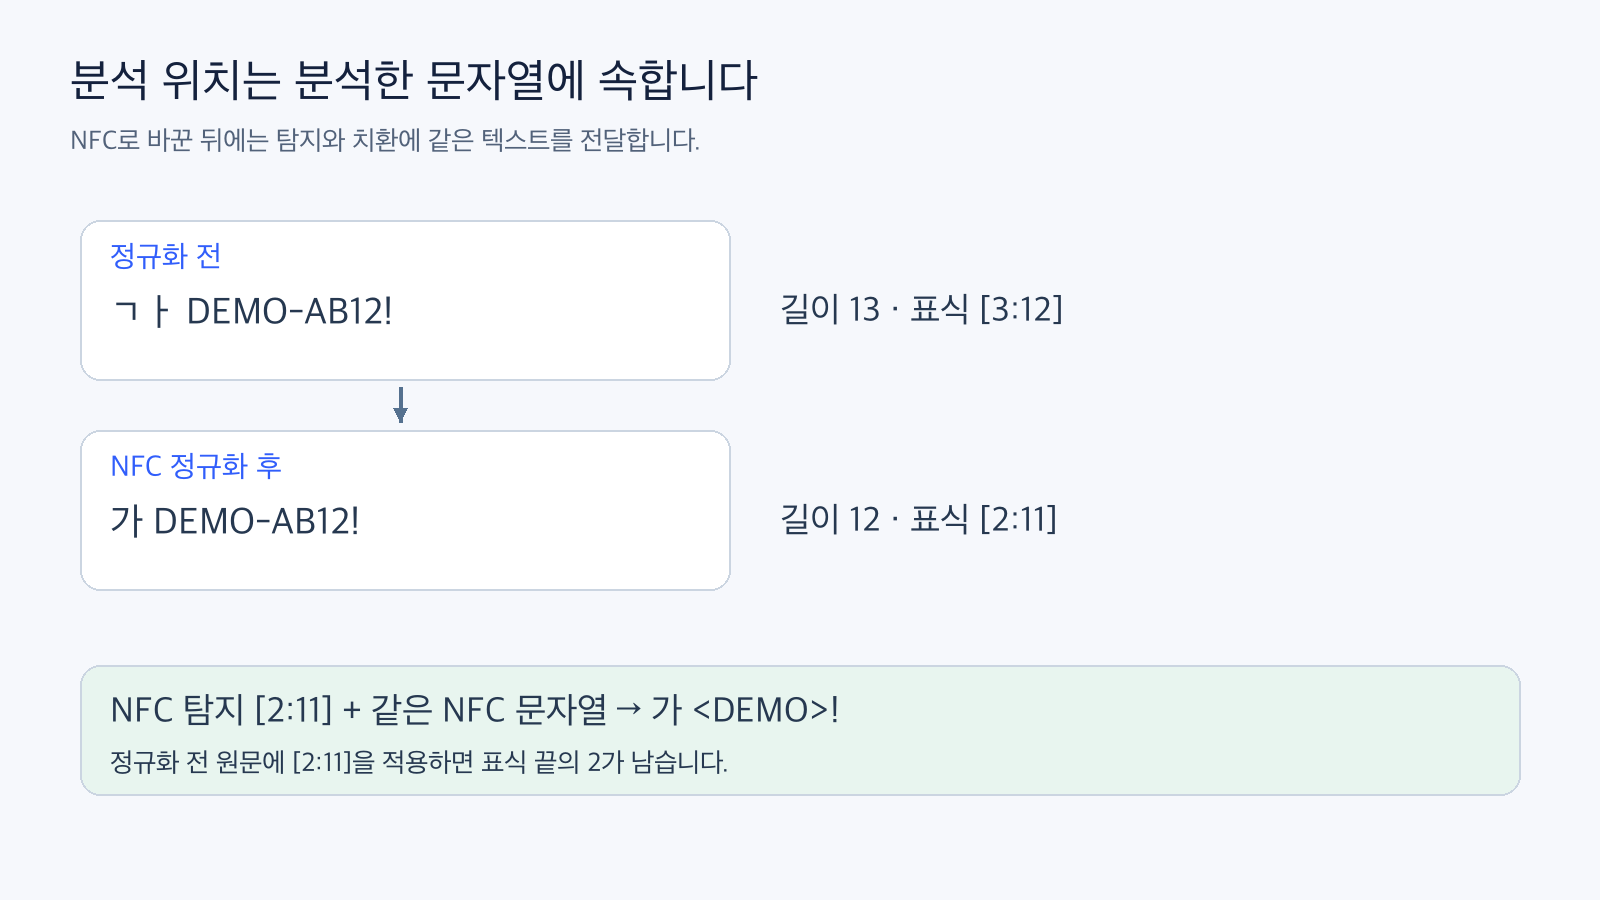
图:字符串和检测位置一同传递的契约。基于官方文档重构的合成示例。官方依据1 · 官方依据2
3. 如果使用标准化输入,则替换也应用于该输入
如果不需要保留原文表示,那么首先创建一个标准化字符串,并将其相同地传递给检测和替换,这种设计更简单。
원문 → NFC 문자열 생성 → 그 문자열에서 탐지 → 그 문자열에 치환本次合成代码的核心也是这个顺序。
text = unicodedata.normalize("NFC", original)
detected = detect_demo(text)
safe = apply_verified(text, detected)detect_demo()返回标记的位置和分析后的字符串。apply_verified()首先比较传入的字符串是否与分析后的字符串相同。
def apply_verified(text, detection):
    if text != detection.analyzed_text:
        raise ValueError("analyzed and replacement text differ")
return replace_spans(text, detection.spans)此路径的实际结果是가 ,而插入标准化前字符串的路径在替换前被拒绝。此比较是示例中创建的应用程序检查,并不意味着Presidio默认会执行相同的检查。
如果涉及多个进程或缓存,可以将分析输入的版本、标准化方式、索引单位与结果关联存储。在同一个请求中,始终使用分析后的文本对象可以减少错误。即使使用哈希作为连接标记,也不会不必要地将原文留在日志中。短敏感值的哈希也不会自动匿名化。
实际连接Presidio的顺序如下。以下代码描述了官方API的使用形式,并非本次标准库验证中执行的部分。
text = unicodedata.normalize("NFC", original)
found = analyzer.analyze(text=text, language="ko")
result = anonymizer.anonymize(text=text, analyzer_results=found)
替换顺序和位置单位也包含在契约中
即使传递相同的字符串,如果从前面开始替换多个区间,第一次替换可能会改变长度,从而导致后续区间的位置发生变化。这就是附件代码中replace_spans()从原始位置较大的区间开始处理的原因。对于示例中不重叠的区间,从后面开始替换可以保持前面区间的坐标。此顺序并不能解决重叠实体的优先级问题,重叠处理需要单独的策略。
如果在不同程序之间传递输入和结果,契约中至少应注明四点:标准化形式、分析文本的版本、位置的单位、结束位置是否包含。本文使用Python码点基准和不包含结束位置的区间。这并不意味着可以直接使用JavaScript等UTF-16位置。
验证案例也不应仅限于长度不同的字符串。可以添加检查,例如:码点数相同但内容不同的输入是否被拒绝,标记多次出现时是否全部消失,以及周围的空格和标点符号是否保留。这些是实际集成中要添加的回归案例,并不意味着最初的8个检查验证了所有情况。
4. 如果必须保留原文,则需要对应关系
如果必须保留原文表示,则选择会有所不同。如果可以直接分析原文并在原文中处理,则两个阶段的位置将一致。本次ASCII练习标记可以独立于前面的韩语表示找到,因此也验证了此路径。这并不意味着所有实际识别器都能以相同的质量处理NFD输入。
如果检测使用标准化版本,而替换使用原文,则必须单独管理标准化区间和原文区间之间的对应关系。在起始位置加一个数字进行校正并非通用解决方案。
원문:   가 DEMO-AB12 가 DEMO-AB12!
NFC: 가 DEMO-AB12 가 DEMO-AB12!实际标记位置在原文中是[3:12]、[16:25],在NFC中是[2:11]、[14:23]。第一个标记前减少了一个码点,第二个标记前减少了两个。两个起始位置的差异分别为1和2。如果所有结果都加上+1,第二个区间仍然是错误的。
作者的建议是首先确定是否必须保留原文,如果需要,则验证预处理结果与原文之间的区间对应关系。本次代码中未实现处理组合、分解和组合字符重新排序的通用对应算法。也不应假定将字符串中每个字符独立标准化后的结果拼接起来,总是与整个字符串的标准化结果相同。
5. 同时检查检测准确性和最终替换结果
附件的verify_unicode_offsets.py仅使用Python标准库。执行方法如下:
python3 verify_unicode_offsets.py --output results.json在Python 3.9.6、Unicode数据库13.0.0上执行,所有8个测试均通过。这里,重现错误替换的测试通过,意味着在错误路径中预期的残留字符确实出现了。这并不意味着该路径是安全的。
测试分别验证了长度差异、NFC坐标的正确性、应用于不同字符串的残留字符、反向错误、相同字符串的正常替换、不一致输入的拒绝、重复标记的累积位置差异以及原文表示的保留。详细的数值和字符串可以在随附的results.json中查看。
在实际集成回归测试中,最好不要只检查检测类型、起始和结束。还要检查从分析输入中截取每个区间时是否得到预期值,以及替换结果中合成标记是否完全消失,周围的非目标字符是否保留。由于可能会错误地传递码点数相同但内容不同的字符串,因此不能仅凭长度比较来替代输入同一性。
本次验证并非针对韩语个人信息检测率、Presidio引擎的整体运行情况或其他语言客户端的位置转换结果的测量。确认的范围更窄:位置值属于分析后的字符串,如果字符串因标准化而改变,则必须重新调整该关系。
发表回复