Unicode正規化とは、同じ文字として扱われる文字列の表現を一定の形式に合わせる処理です。ハングル가も、完成形の一文字と初声・中声の組み合わせで表現できます。画面上では似て見えても、Python文字列内で占める位置の数は異なる場合があります。
この違いは、個人情報処理において検出と置換を連携させる際に問題となります。正規化された文字列で見つかった開始・終了位置を、正規化前の原文にそのまま適用すると、正確に検出された標識の一部が残ってしまう可能性があります。まず確認すべきは、検出閾値よりも2つの段階が同じ文字列を使用しているかです。
Presidio韓国語回帰テストではエンティティの種類と正解区間を、個人情報処理の4段階構造では検出後のポリシーと処理を説明しました。本稿では、その間の文字列と位置を一緒に渡す契約を合成例で検証します。実際の個人情報や業務ログは使用していません。
AIで生成された概念イメージです。実際の画面や測定結果を示すものではありません。
1. 가の一文字が1つの位置を占める保証はない
コードポイントはUnicodeで文字を識別する番号です。以下の2つの文字列の最初の部分は、正規化すると同じ가になります。
composed = "uac00"          # ガ: U+AC00
decomposed = "u1100u1161" # ᄀ + ᅡ: U+1100, U+11611つ目はコードポイントが1つ、2つ目は2つです。ここでの分解された子音・母音は、ㄱ・ㅏという互換用子音・母音を任意に付けた例ではなく、Unicodeでハングル合成に使用されるᄀ・ᅡです。Unicode正規化標準のハングル例
NFCは正規分解後に可能な組み合わせを結合する形式であり、NFDは正規分解された形式です。この例では、NFCで가、NFDで가になります。Pythonのunicodedata.normalize()で両方の変換を実行できます。Python unicodedata
import unicodedata

original = "u1100u1161 DEMO-AB12!"
normalized = unicodedata.normalize("NFC", original)
print(len(original), len(normalized))実際の出力は13 12でした。DEMO-AB12は本稿で作成した練習用の標識であり、実際の口座や識別子の形式を複製した値ではありません。全体の長さが1つ減った原因は、標識の前のハングル結合です。
len()は、このPythonの例ではコードポイント数を数えます。画面に表示される文字の塊の数やUTF-8バイト数と同じ単位だと仮定すべきではありません。外部クライアントがUTF-16位置を使用する問題は追加で検証する必要がありますが、今回の試験はPython文字列内のNFC・NFDの違いに限定します。
2. 検出された標識は同じだが、マスキングする位置が変わる
Presidioの分析結果には、entity_type、start、endなどの項目が含まれます。Anonymizerは処理するtextと分析結果を一緒に受け取ります。この構造では、位置がどのテキストの位置であるかが重要です。Presidio Anonymizer公式例
以下は、同じ標識をそれぞれの文字列で検索した実際の結果です。終了位置はPythonのスライスと同様に含みません。
| 入力表現 | 全体の長さ | 標識位置 [start:end] |
その入力から切り出した値 |
|---|---|---|---|
u1100u1161 DEMO-AB12! |
13 | [3:12] |
DEMO-AB12 |
NFCで作成した가 DEMO-AB12! |
12 | [2:11] |
DEMO-AB12 |
どちらも検出は正しいです。エラーは、NFCの結果である[2:11]を最初の文字列に適用する際に発生します。原文ではその区間は" DEMO-AB1"です。前の空白まで含み、標識の最後の数字2を見落とします。
wrong = original[:2] + "<DEMO>" + original[11:]実際の結果は"u1100u1161でした。逆に、NFDで見つかった[3:12]をNFC文字列に使うと、"EMO-AB12!"が選択されます。長さが短くなる方向だけでなく、長くなる方向でも同じ種類のエラーが発生します。
これは異なるテキストの座標を混在させるアプリケーション統合エラーです。この結果だけでPresidio自体にUnicodeバグがあると主張することはできません。今回の検証は、インストールされたPresidioやNLPモデルを実行せず、固定標識を検索する標準ライブラリの正規表現とPythonスライスで位置契約を分離して再現しました。
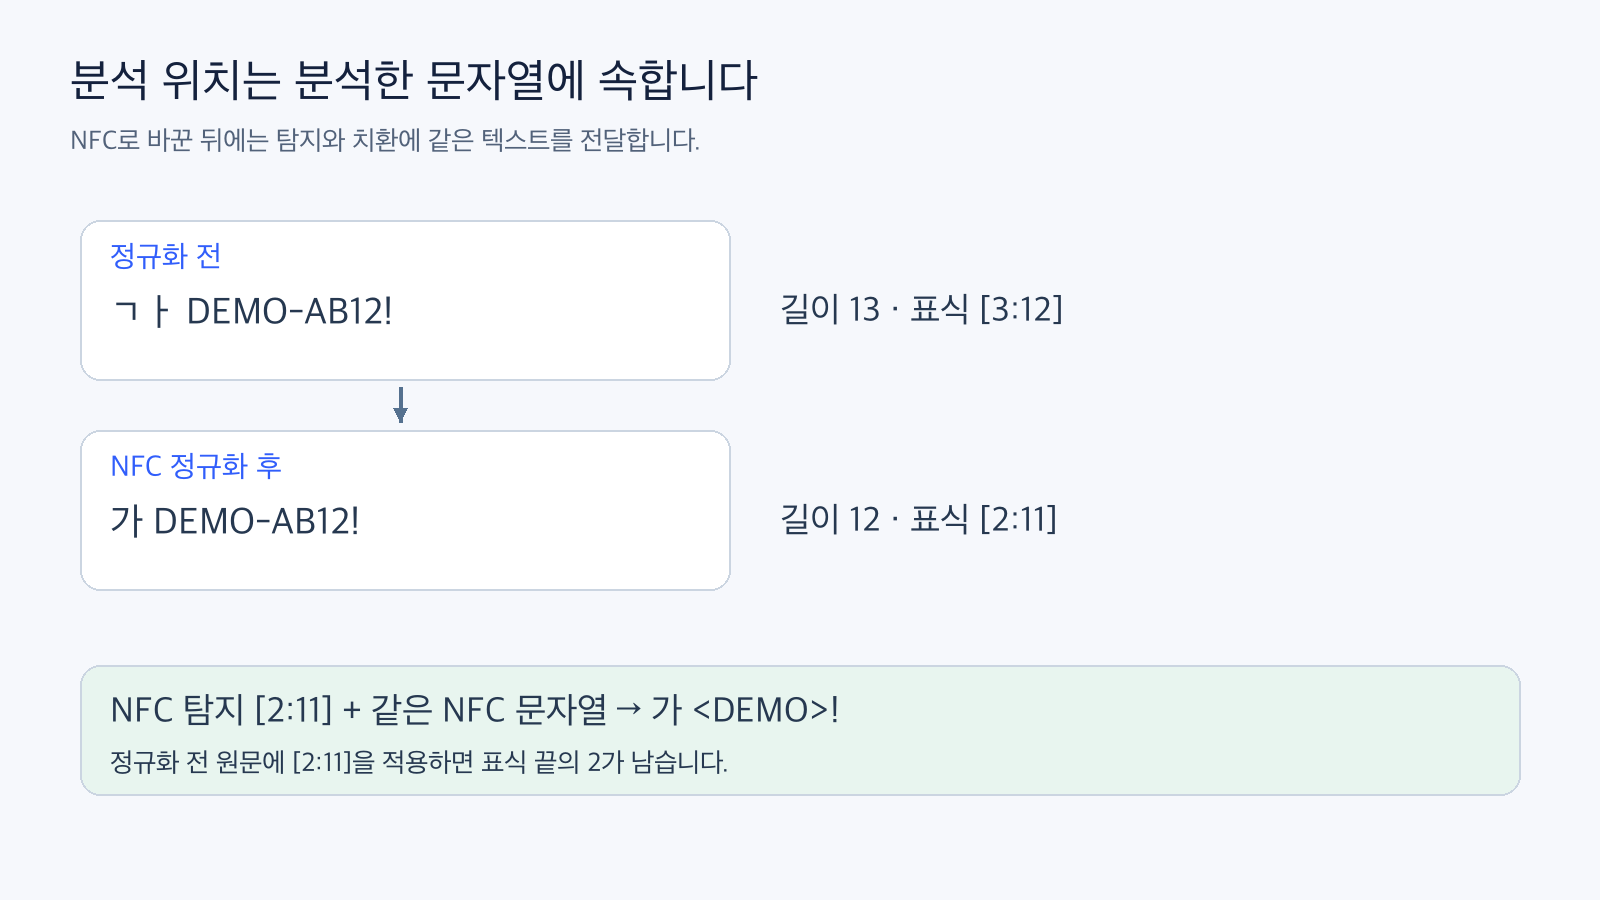
図:文字列と検出位置を一緒に渡す契約。公式文書に基づいて再構成した合成例です。公式根拠1 · 公式根拠2
3. 正規化された入力を使用する場合、置換もその入力に適用する
原文表現を維持する必要がない場合、まず正規化された文字列を1つ作成し、検出と置換に同じように渡す設計が単純です。
원문 → NFC 문자열 생성 → 그 문자열에서 탐지 → 그 문자열에 치환今回の合成コードの核心もその順序です。
text = unicodedata.normalize("NFC", original)
detected = detect_demo(text)
safe = apply_verified(text, detected)detect_demo()は標識の位置と分析された文字列を一緒に返します。apply_verified()は、渡された文字列が分析された文字列と同じであるかをまず比較します。
def apply_verified(text, detection):
    if text != detection.analyzed_text:
        raise ValueError("analyzed and replacement text differ")
return replace_spans(text, detection.spans)この経路の実際の結果は가 であり、正規化前の文字列を挿入する経路は置換前に拒否されました。この比較は例で作成されたアプリケーション検査であり、Presidioがデフォルトで同じ検査を行うという説明ではありません。
複数のプロセスやキャッシュを介する場合、分析入力のバージョン・正規化方式・インデックス単位を結果と連携させて保管できます。同じリクエスト内では、分析されたテキストオブジェクトを最後まで使用する方がエラーを減らします。ハッシュを連結用標識として使用しても、原文を不必要にログに残すことはありません。短い機密値のハッシュが自動的に匿名化されるわけでもありません。
Presidioを実際に接続する際の順序は以下の通りです。以下は公式APIの使用形態を説明するコードであり、今回の標準ライブラリ検証で実行した部分ではありません。
text = unicodedata.normalize("NFC", original)
found = analyzer.analyze(text=text, language="ko")
result = anonymizer.anonymize(text=text, analyzer_results=found)
置換順序と位置単位も契約に含める
同じ文字列を渡しても、複数の区間を前から置換すると、最初の置換で長さが変わり、後ろの区間の位置がずれる可能性があります。添付コードのreplace_spans()が、元の位置が大きい区間から処理する理由です。例のように互いに重ならない区間は、後ろから置換すると前の区間の座標が維持されます。この順序が重なったエンティティの優先順位まで解決するわけではなく、重なり処理には別途ポリシーが必要です。
入力と結果を異なるプログラム間で渡す場合、契約には少なくとも4つのことを記載します。正規化形式、分析されたテキストのバージョン、位置の単位、終了位置の包含有無です。本稿ではPythonコードポイント基準と終了を含まない区間を使用します。JavaScriptなどのUTF-16位置をそのまま持ってきても良いという結論ではありません。
確認用事例も長さが異なる文字列だけで終わらせません。コードポイント数は同じだが内容が異なる入力を渡しても拒否されるか、標識が複数回登場する際にすべて消えるか、周囲の空白と句読点が保存されるかを追加できます。これは実際の統合に追加する回帰事例であり、元の8つの検査がすべてのケースを検証したという意味ではありません。
4. 原文を保存する必要がある場合、対応関係が必要
原文表現を維持する必要がある場合は、選択肢が変わります。原文そのまま分析し、原文に処理できるのであれば、2つの段階の位置が一致します。今回のASCII練習標識は、前のハングル表現とは無関係に検索できるため、この経路も検証しました。すべての実際の認識器がNFD入力を同じ品質で処理するという意味ではありません。
検出は正規化版で行い、置換は原文で行う必要がある場合、正規化区間と原文区間の間の対応を別途管理する必要があります。開始位置に数字を1つ加える補正は一般的な解決策ではありません。
원문:   가 DEMO-AB12 가 DEMO-AB12!
NFC: 가 DEMO-AB12 가 DEMO-AB12!実際の標識位置は、原文で[3:12]、[16:25]、NFCで[2:11]、[14:23]でした。最初の標識の前では1つのコードポイントが減り、2番目の標識の前では2つ減りました。2つの開始位置の差はそれぞれ1と2です。すべての結果に+1を加えると、2番目の区間は依然として間違っています。
著者の推奨は、原文保存が必須であるかをまず決定し、必要であれば前処理結果と原文の間の区間対応を検証することです。結合・分解・結合符号再整列まで処理する汎用対応アルゴリズムは、今回のコードには実装していません。文字列の各文字を独立して正規化した結果を結合する方式が、全体正規化と常に同じであると仮定すべきではありません。
5. 検出精度と最終置換結果を一緒に検査する
添付のverify_unicode_offsets.pyはPython標準ライブラリのみを使用します。実行方法は以下の通りです。
python3 verify_unicode_offsets.py --output results.jsonPython 3.9.6、Unicodeデータベース13.0.0で実行し、8つの検査すべてが合格しました。ここで、誤った置換を再現した検査がPASSであるのは、エラー経路で予想された残余文字が実際に現れたことを意味します。その経路が安全であるという意味ではありません。
検査は、長さの違い、NFC座標の正常性、異なる文字列に適用された残余文字、逆方向エラー、同じ文字列の正常な置換、不一致入力の拒否、繰り返し標識の累積位置差、原文表現の保存をそれぞれ確認します。詳細な数値と文字列は、一緒に保存されたresults.jsonで確認できます。
実際の統合回帰テストでも、検出タイプ・開始・終了だけを確認して終わらせない方が良いです。各区間を分析入力から切り出したときに期待した値が出るか、置換結果で合成標識が完全に消え、周囲の非対象文字が維持されるかを一緒に検査します。コードポイント数が同じで内容が異なる文字列を誤って渡す場合もあるため、長さ比較だけで入力の同一性を代替すべきではありません。
この検証は、韓国語個人情報検出率、Presidioエンジンの全体動作、他の言語クライアントの位置変換を測定した結果ではありません。確認したのはより狭い範囲です。位置の値は分析された文字列に属し、正規化によって文字列が変わる場合、その関係を新たに合わせる必要があるという事実です。
コメントを残す