在设计生成式AI系统的网络时,人们常会想:“将模型服务器放入私有子网中就足够了吗?”然而,实际的LLM服务是一个由用户会话、提示编排器、模型推理服务器、RAG知识库、Vector DB、外部模型API、MCP工具和不可信文档解析器串联组成的系统。
在这种结构中,仅凭简单的互联网和内部网络二分法难以解释风险。用户上传的PDF中的恶意指令可能通过RAG导致工具调用,而发送到外部LLM API的HTTPS流量中也可能包含个人信息或商业秘密。即使模型服务器未暴露在外部,过度的工具权限或错误的VPC路由也可能导致重要数据泄露。
因此,生成式AI的网络隔离不应仅限于物理或逻辑网络分离。账户、VPC、子网、服务终端节点、应用程序策略、数据分类和管理员路径都必须设计为一个统一的信任边界。
本文以AWS环境为例,详细解释了账户→VPC→子网的三层隔离、Transit Gateway和中央防火墙、AWS PrivateLink、Model Gateway和PII DLP、N2SF的C/S/O数据分类以及管理员访问控制。
首先要区分:网络隔离与数据流控制
传统的网络隔离通过将重要系统与互联网隔离来减少攻击面,这非常有效。但在生成式AI中,除了“部署在哪里”之外,还需要关注“哪些数据可以向哪个方向移动”。
사용자 입력
→ AI Application
→ Model Gateway
→ 내부 모델 또는 외부 모델 API
→ RAG Knowledge API
→ MCP Tool Broker
→ 실제 업무 시스템
此流程中混合了不同的信任级别。
| 组件 | 主要风险 | 所需控制 |
| — | — | — |
| 用户输入 | 提示注入、个人信息输入 | 输入验证、数据分类、DLP |
| 不可信文档 | 间接提示注入、恶意文件 | 专用文档隔离环境、解析器隔离 |
| 模型服务器 | 模型权重泄露、推理API滥用 | 阻止外部直接访问、最小权限 |
| Vector DB | 个人信息·内部文档的过度搜索 | 租户分离、文档ACL、搜索后过滤 |
| 外部模型API | 提示和响应的外部传输 | Model Gateway、去标识化、审批策略 |
| MCP·工具执行 | 命令执行、数据修改、权限滥用 | Sandbox、Tool Broker、用户审批 |
核心在于,不能仅凭“是否有互联网连接”来判断网络隔离。即使在同一个内部网络中,如果模型、知识和工具执行环境的权限和数据不同,也应将其划分为独立的信任区域。
第一阶段:通过AWS账户分离管理权限和事故范围
AWS安全参考架构(AWS Security Reference Architecture)建议使用Network、Security Tooling、Log Archive等专用账户来分离网络运营、安全控制和日志存储的职责,从而构建多账户结构。
在生成式AI环境中,可以在此基本结构上添加反映AI工作负载信任边界的账户。
| 账户 | 角色 | 核心控制 |
| — | — | — |
| Network Account | Transit Gateway、中央防火墙、入口·出口 | 防止工作负载账户任意路由绕过 |
| Security Tooling Account | 检测·响应、安全集成管理 | GuardDuty、Security Hub、SIEM联动 |
| Log Archive Account | 审计日志和安全日志的长期存储 | 不可变存储、操作员删除权限分离 |
| AI Application Account | 用户会话、API、提示编排 | 会话隔离、API认证、请求策略 |
| Model Account | 内部模型、GPU、模型权重 | 阻止外部直接访问、仅公开推理API |
| Knowledge Account | RAG、Vector DB、文档元数据 | 应用数据分类·租户·文档ACL |
| Tool Sandbox Account | MCP工具、代码执行、浏览器自动化 | 短生命周期环境、受限IAM、阻止出口 |
其中,Network、Security Tooling、Log Archive账户是AWS SRA的基础账户。而Model、Knowledge、Tool Sandbox账户并非所有组织强制要求的AWS官方账户名称,而是根据生成式AI的风险和监管要求可以添加的扩展设计方案。
账户分离的最大目的并非成本划分。而是为了创建管理平面的边界,防止攻击者即使获得了AI Application Account的权限,也无法获取Model Account的模型权重或删除Log Archive的审计记录。
但是,过度细分账户会增加运营复杂度和成本。如果数据敏感度和用户群体相同,并且可以通过IAM角色充分控制,则可以合并部分账户。反之,如果开发、验证、运营环境的风险不同,或者不同用户群体的数据访问范围不同,则进一步划分账户会更安全。
第二阶段:通过VPC水平分离网络信任区域
如果说账户分离了管理权限和事故范围,那么VPC则分离了实际的网络通信范围。
Network Account
└─ Inspection VPC

AI Application Account
└─ Application VPC

Model Account
└─ Model VPC

Knowledge Account
├─ Knowledge VPC
└─ Document Inspection VPC

Tool Sandbox Account
└─ Tool Sandbox VPC
Application VPC中部署用户API和提示编排器。Model VPC包含内部推理API和GPU服务器,但阻止从互联网直接访问。Knowledge VPC中放置Vector DB和RAG API,并设计为对原始文档和搜索结果应用相同的访问策略。
Document Inspection VPC是用于解析用户上传的PDF、Office文档、压缩文件等不可信内容的区域。在此处执行文件格式验证、恶意代码扫描、宏删除、文本提取,并将通过隔离检查的结果传递给Knowledge VPC。
Tool Sandbox VPC是一个隔离环境,用于防止MCP服务器或代码执行器无限制地访问实际业务系统。每个工具应仅允许必要的目的地和端口,并且文件系统和凭证也应按任务单位保持短生命周期。
第三阶段:通过子网具体化角色和故障域
即使在VPC内部,将所有工作负载放在同一个子网中也会使安全组和路由策略变得复杂。根据角色划分子网可以更清晰地定义故障和访问控制的范围。
Application VPC
├─ Private App Subnet-A
├─ Private App Subnet-B
├─ Endpoint Subnet-A
└─ Endpoint Subnet-B

Knowledge VPC
├─ Knowledge API Subnet
├─ Vector DB Subnet
└─ Data Endpoint Subnet
按可用区划分的子网用于故障隔离,而App·DB·Endpoint子网的区分则用于角色隔离。这两个标准必须同时应用。
安全组不应“因为在同一个VPC中就允许”,而应表达服务间的契约。例如,Application编排器应只调用Knowledge API的443端口,而不能直接访问Vector DB端口。Vector DB的访问权限和文档ACL检查由Knowledge API强制执行。
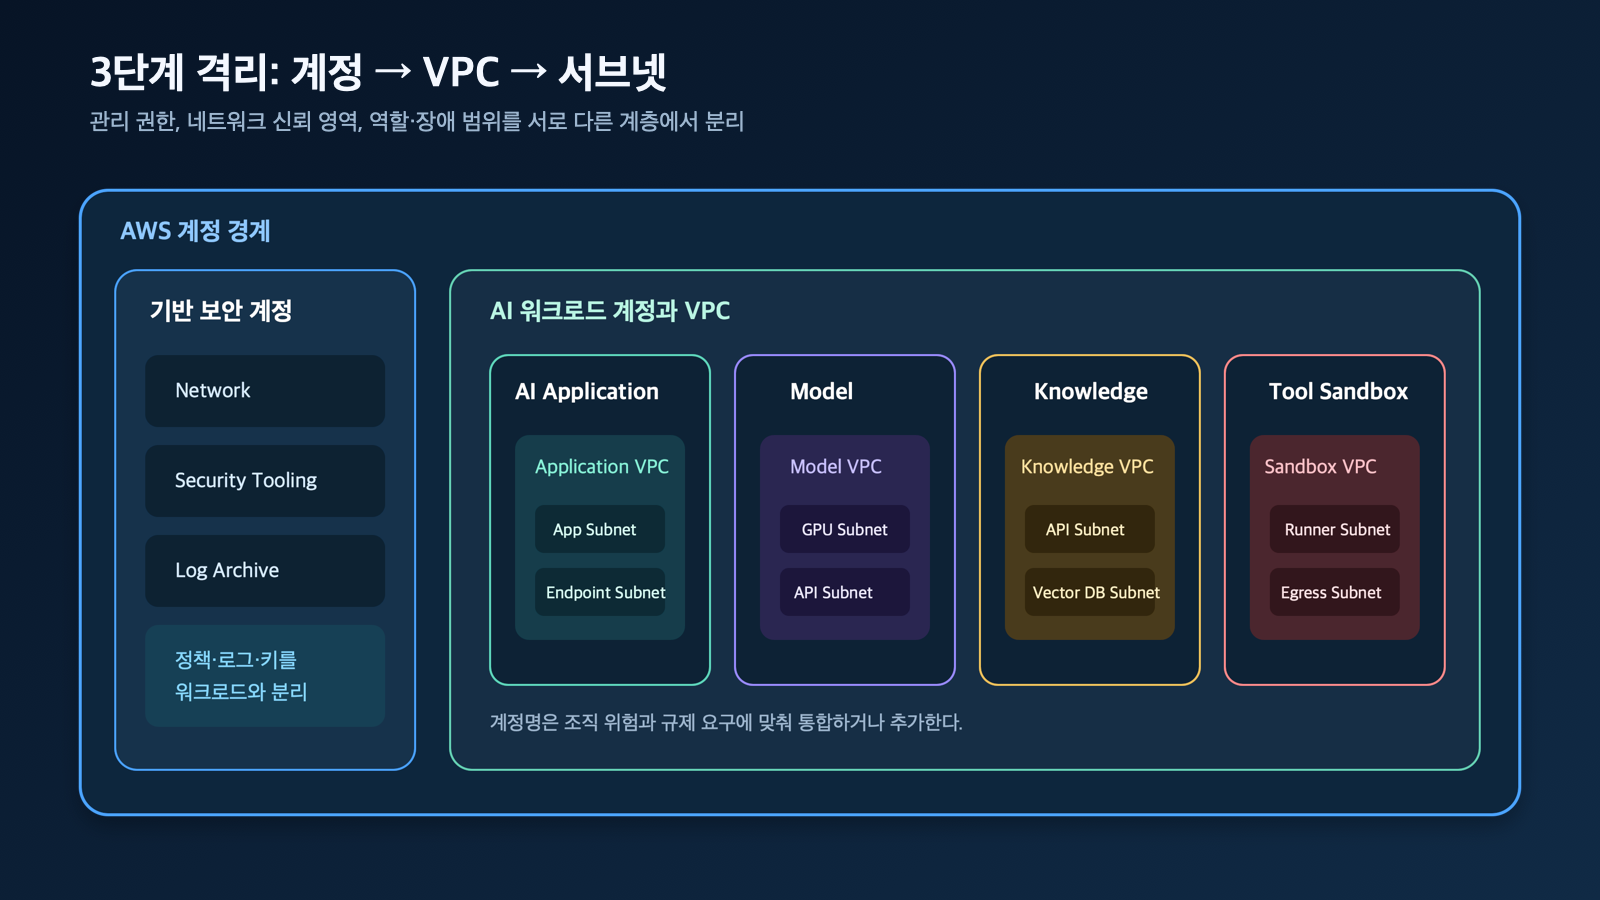
图:根据文章解释顺序重新配置AWS账户·VPC·子网的角色 · AWS Security Reference Architecture
Transit Gateway和中央防火墙控制一般通信
连接多个VPC和本地网络时,可以围绕Transit Gateway构建Hub-Spoke结构。在Network Account的Inspection VPC中部署AWS Network Firewall或经过验证的NGFW,并检查以下流量:
- 互联网入口和出口
- 一般的VPC间通信
- 本地与AWS之间的通信
- 管理网络与业务网络之间的通信
Application VPC ─┐
Model VPC ───────┼→ Transit Gateway → Inspection VPC → 허용된 목적지
Knowledge VPC ───┤
Tool Sandbox VPC ┘
这里重要的是,连接到Transit Gateway并不意味着所有流量都会自动通过中央防火墙。必须同时验证TGW路由表、VPC路由表、防火墙终端节点的可用区部署和对称路由。
可以使用Service Control Policy和AWS Config规则来防止工作负载账户创建绕过Inspection VPC的Internet Gateway、NAT Gateway或任意VPC Peering。Flow Logs、Network Firewall日志和DNS日志应发送到Log Archive Account,而不是运营账户。
PrivateLink仅单向暴露指定服务
当消费者VPC只需要调用提供者VPC中的特定服务(如Model Gateway、Knowledge API、Tool Broker)时,AWS PrivateLink可能比相互路由整个VPC更合适。
Application VPC
  └─ Interface VPC Endpoint
          ↓ 지정된 서비스만 호출
Model VPC
  └─ Model Gateway Endpoint Service
PrivateLink提供从消费者VPC到提供者服务的私有连接,而不会在两个VPC之间创建完整的IP路由权限。它的优点是即使在IP地址重叠的环境中也可以使用。
但是,PrivateLink不能替代应用程序权限。必须同时应用终端节点策略、服务认证、mTLS或签名请求以及租户验证。网络可达性与访问该数据的权限是两个独立的问题。
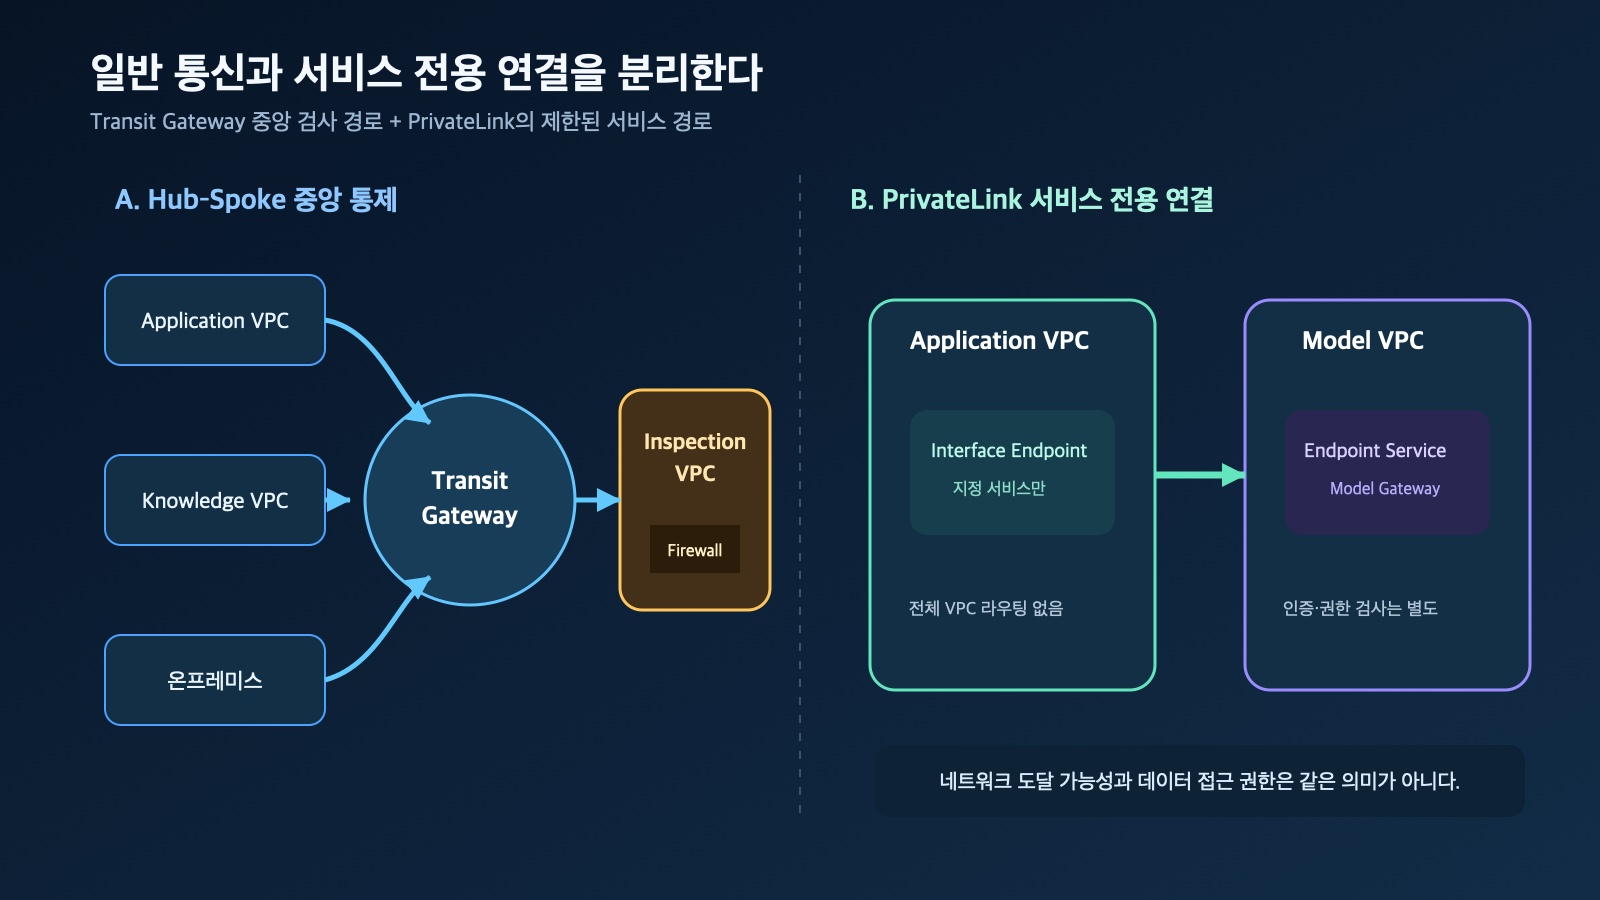
图:中央网络检查与服务级私有连接的比较重构 · AWS SRA Network Account
外部模型调用通过Model Gateway和Egress Proxy
对OpenAI或Anthropic等外部LLM API的调用通过TLS加密。一般的网络防火墙可以检查目标域名和连接信息,但难以直接判断HTTPS正文中包含的提示和个人信息。
因此,建议外部模型调用通过应用程序层的Model Gateway或受控的Egress Proxy。
AI Application
→ Model Gateway
   ├─ 사용자·테넌트 인증
   ├─ 데이터 등급 확인
   ├─ PII·기밀정보 탐지
   ├─ 마스킹·가명처리
   ├─ 모델·지역·계약 정책 확인
   ├─ Rate Limit·비용 한도
   └─ 감사 이벤트 생성
→ 내부 모델 또는 승인된 외부 Enterprise API
Model Gateway并非简单的HTTP正向代理。它是一个策略执行点,用于识别谁出于何种业务目的调用哪个模型,并根据数据分类和目的决定是否允许调用。
身份证号、银行账号、健康信息等明确的模式可以通过PII DLP检测到。然而,项目代号、未公开的合同条款、设计文档等组织特有的机密信息仅凭正则表达式难以发现。必须结合使用数据目录、文档标签、用户业务属性和分类模型。
审计日志应包含策略判断所需的信息,但无条件地存储整个原始提示会使日志存储成为另一个个人信息系统。原始文本的存储与否、掩码、保留期限和访问权限必须根据数据分类来决定。
将N2SF的C/S/O分类与AI使用策略关联
国家网络安全体系N2SF将国家·公共机构的信息和信息系统分为机密(Classified)、敏感(Sensitive)、公开(Open)等级,并要求选择符合等级的控制措施。
该体系不能被视为适用于所有民营企业的通用法律法规。民营企业应根据自身的信息保护、个人信息和行业监管体系定义内部数据分类。但是,C/S/O方法可以作为设计AI模型使用策略时的有用参考框架。
| 分类 | AI使用原则 | 推荐控制 |
| — | — | — |
| C: 机密 | 禁止外部模型传输 | 强隔离内部模型、受限用户、导出审批 |
| S: 敏感 | 内部模型优先 | 外部传输时去标识化、事前审批、DLP、访问记录 |
| O: 公开 | 允许使用经批准的外部企业API | 基本日志记录、恶意输入过滤、成本·速率限制 |
数据分类不应仅由文档的存储位置决定。必须将用户输入、检索到的RAG文档、工具查询结果和模型响应全部纳入,以计算最终请求的有效分类。
사용자 입력 등급: O
RAG 검색 문서 등급: S
도구 조회 결과 등급: S
────────────────────
최종 모델 요청 등급: S
即使始于公开问题,如果RAG检索到敏感的内部文档,外部模型调用策略也必须以S等级为基准重新评估。
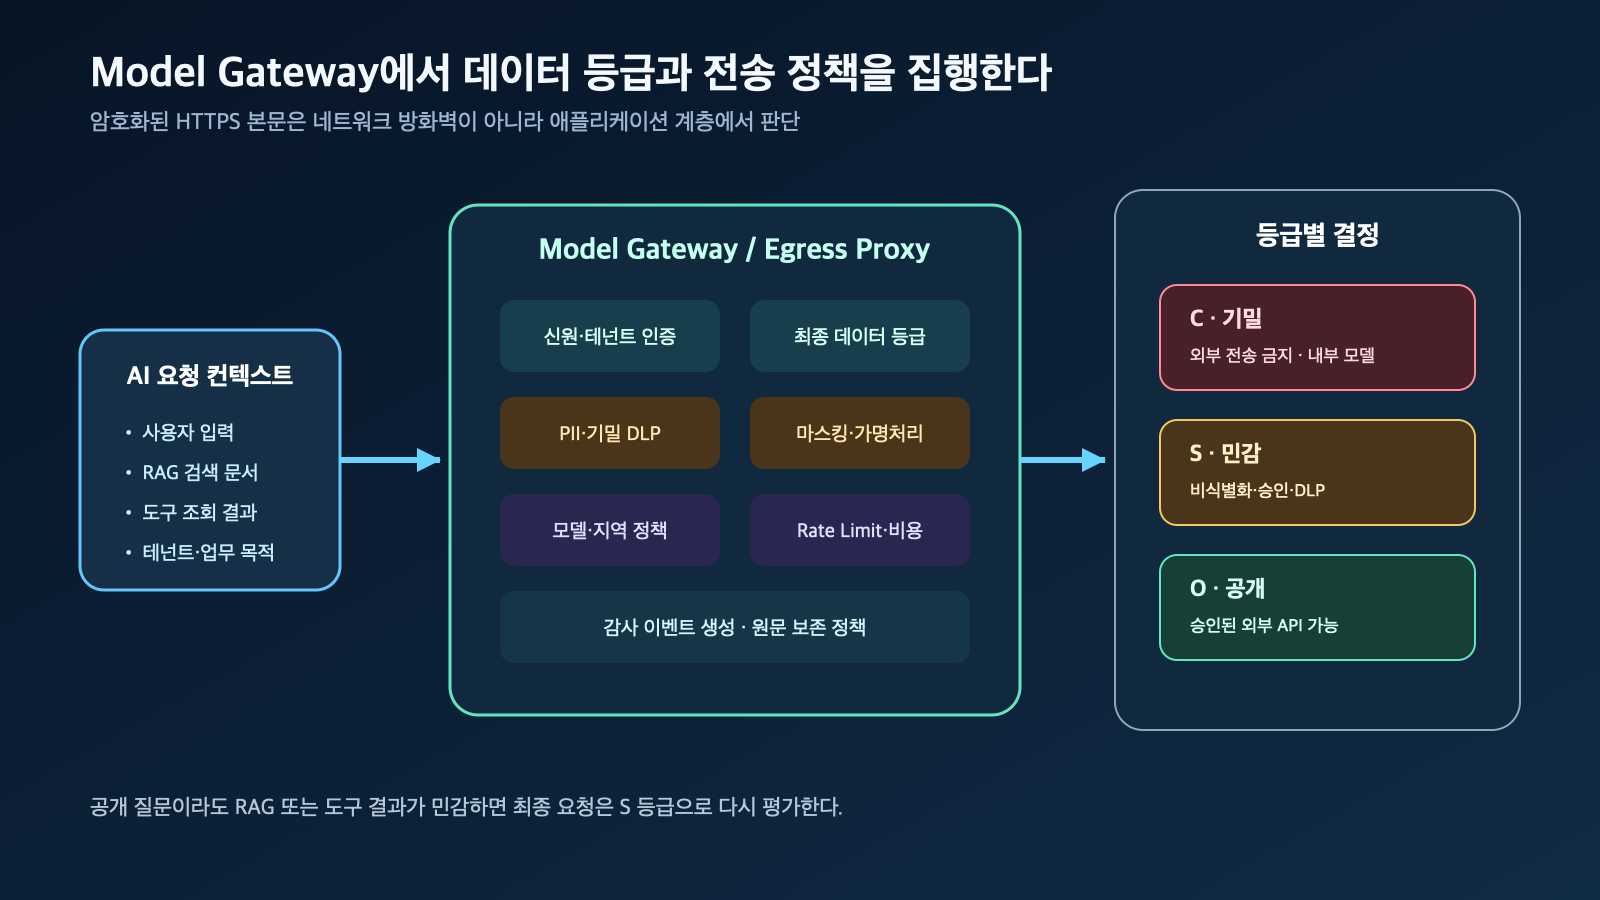
图:结合Model Gateway控制和C/S/O数据分类决策重新配置 · AWS SRA for AI — Secure AI Applications · N2SF安全指南 1.0
公共·企业环境的网络互联分为三种类型
内部网络专用AI
在阻止外部连接的内部网络中,仅使用内部模型和内部知识库。适用于处理C等级或受严格监管的数据,但模型更新、补丁和训练数据导入需要单独的验证程序。
内部业务AI的外部网络互联
内部用户需要利用外部最新信息或外部模型功能的情况。通过DMZ中继系统或经过验证的网络互联区域交换允许的请求,并让出站提示通过DLP和审批策略。
面向公众AI的内部数据互联
聊天机器人等面向公众的服务部署在外部区域,但当需要内部数据时,仅通过网络互联区域的Knowledge API传输受限数据。为防止用户输入的不可信内容直接进入内部网络,应应用恶意文件扫描、提示注入防御和模式验证。
无论哪种类型,都不应得出“有网络互联设备就安全”的结论。文件·API·消息级别的允许策略、内容检查、用户和服务认证、导出审批和审计必须协同工作。
加密和密钥管理与数据边界分离
原始文档、嵌入、Vector DB、训练数据、模型权重和审计日志在存储时必须加密。传输过程中应应用TLS,对于重要的服务间通信可以考虑mTLS。
加密密钥应由AWS KMS或CloudHSM等中央管理体系控制,并分离数据管理员和密钥管理员的权限。特别是,应防止工作负载操作员拥有Log Archive的加密密钥和删除权限,以增加在入侵后删除证据的难度。
仅凭加密并不能解决访问控制问题。如果应用程序拥有解密权限,攻击者可以通过应用程序读取明文。必须使用KMS Key Policy、IAM、Encryption Context和服务角色来限制哪些工作负载可以出于何种目的进行解密。
管理员访问不直接从互联网连接到目的地
在管理个人信息处理系统或模型权重的高风险环境中,最好不要允许从普通互联网直接通过SSH或RDP连接到服务器。
관리자 PC
→ MFA가 적용된 ZTNA 또는 Client VPN
→ 관리 전용 VDI 또는 Bastion
→ AWS Systems Manager Session Manager
→ 목적지 시스템
管理员身份应应用MFA和基于角色的访问控制,并考虑Just-in-Time方式,即仅在批准的时间段内授予权限,而非长期管理员权限。运营、安全、数据和密钥管理权限也应尽可能分离。
使用Session Manager可以在不打开入站SSH端口的情况下创建管理会话。但是,如果Session Manager自身的权限过高,可能会成为新的绕过路径,因此必须限制目标实例、可执行命令和会话记录的存储位置。
CloudTrail、Session Manager会话日志、操作系统审计日志和数据库访问日志应发送到SIEM或Security Tooling Account。需要一个管理员无法随意删除自己操作记录的结构。
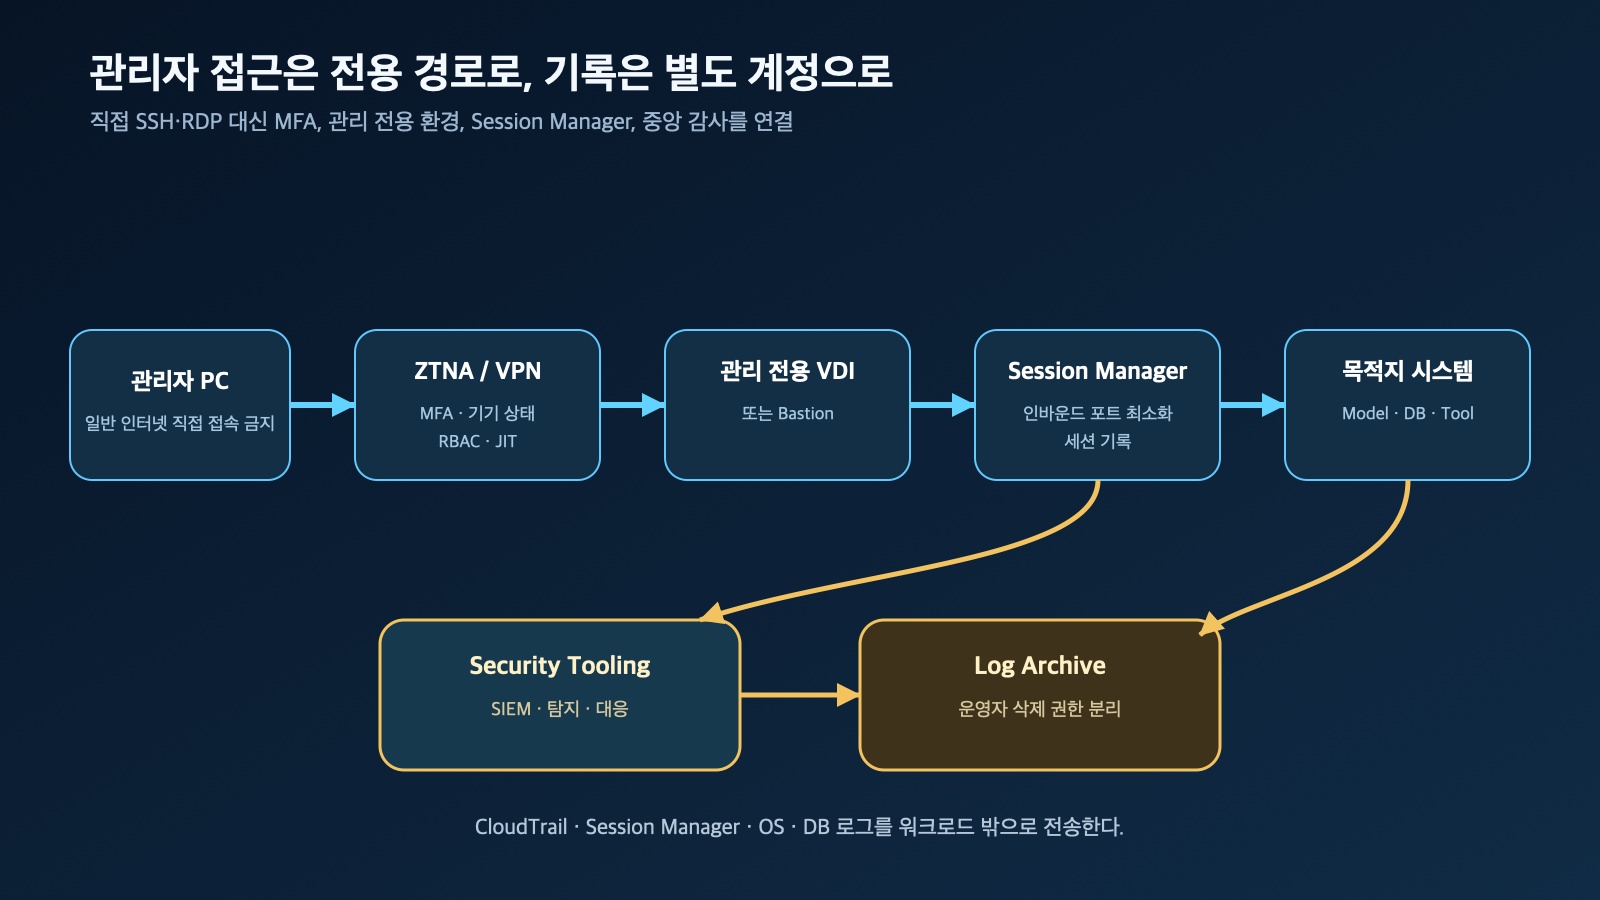
图:重新配置的管理员专用访问路径和中央审计结构 · AWS SRA for AI
实际构建顺序
与其一开始就一次性创建所有账户和VPC,不如按以下顺序进行更为实际。
1. 首先分类数据和流
绘制用户输入、RAG文档、模型响应和工具结果的生成位置和移动路径。为每项数据分配C/S/O或内部等级。
2. 将信任边界映射到账户和VPC
分离具有不同运营权限、数据敏感度、用户群体和事故影响的组件。同时判断是否需要账户分离,或者VPC和IAM角色是否足够。
3. 首先定义允许的流
制作一个表格,说明“谁可以调用哪个服务的哪个API”,而不是“要阻止什么”。区分需要一般VPC路由的流和适合PrivateLink的流。
4. 将Model Gateway和Tool Broker作为策略执行点
创建单一控制路径,以防止外部模型调用和MCP工具调用被绕过。不仅网络路径,SDK和凭证分发也必须通过此控制点。
5. 将日志和密钥与工作负载分离
将Log Archive和KMS权限与运营账户分离,并验证日志完整性和保留策略。
6. 测试绕过和故障
测试任意NAT Gateway创建、VPC Peering绕过、直接外部API调用、敏感信息提示输入、恶意PDF上传、MCP工具的过度权限以及管理员账户被盗用等场景。
构建检查表
- Network、Security Tooling、Log Archive的管理职责是否已分离?
- 模型、知识库、工具执行环境的信任边界是否已区分?
- 工作负载账户是否无法绕过中央出口和Inspection VPC?
- 通过PrivateLink暴露的服务是否也具有应用程序认证和权限检查?
- 应用程序是否不直接持有外部模型API凭证?
- 提示和响应是否应用了数据分类和DLP策略?
- RAG搜索结果的分类是否反映在最终模型调用策略中?
- 不可信文档是否在单独的隔离环境中解析?
- MCP工具和代码执行环境是否在短生命周期的Sandbox中运行?
- HTTP成功、模型策略阻止、工具业务错误是否作为单独的指标进行查看?
- 存储原始日志是否会产生新的个人信息风险?
- 管理员访问是否应用了MFA、专用管理路径和会话记录?
- 加密密钥和日志删除权限是否未集中在工作负载操作员手中?
总结
生成式AI系统的网络隔离并非仅仅将模型服务器放入私有子网那么简单。
계정 격리
→ 관리 권한과 사고 범위 분리

VPC·서브넷 격리
→ 네트워크 신뢰 경계와 역할 분리

Transit Gateway·Inspection VPC
→ 일반 통신의 중앙 통제

PrivateLink
→ 지정된 서비스만 제한적으로 노출

Model Gateway·DLP
→ HTTPS 안의 프롬프트와 데이터 정책 통제

C/S/O 또는 사내 데이터 등급
→ 모델과 망 연계 방식 결정

ZTNA·VDI·Session Manager
→ 관리자 우회 경로 차단과 감사最重要的原则是不将网络位置作为信任的依据。内部网络的DLP用户输入也可能是恶意的,通过PrivateLink连接的服务也可能拥有错误的权限,加密的HTTPS请求中也可能包含不应泄露的数据。
因此,生成式AI的安全网络隔离并非是划分账户和VPC的工作,而是在数据生成、检索、传递给模型和工具的整个路径上,应用相同的分类、权限、验证和审计策略的工作。
发表回复