アクセスパターンが分からなくてもコストを削減するS3の自動最適化戦略
AWSでS3を初めて学ぶ際、通常はS3 Standardから始めます。最も一般的で、パフォーマンスも良く、可用性も高く、何よりも理解しやすいためです。しかし、実際の運用環境に入ると話は少し変わってきます。最初は頻繁にアクセスされると思われたデータが数週間後にはほとんど読み込まれなくなったり、逆にほとんど保管するだけだと思われたデータが、分析作業や顧客からのリクエストのために突然頻繁に読み込まれるようになったりします。
この時、悩みが始まります。
「このデータをStandardに置き続けるべきか?」
「30日後にStandard-IAに移動しても良いか?」
「Glacierに送ればコストは削減できるが、後ですぐに読み込む必要があったらどうしよう?」
「ライフサイクルポリシーをフォルダ単位で設定すると、すべてのオブジェクトに同じように適用されるが、オブジェクトごとにアクセスパターンが異なる場合はどうすればよいか?」
このような悩みを軽減してくれるストレージクラスがS3 Intelligent-Tieringです。名前の通り、S3がオブジェクトのアクセスパターンを監視し、アクセス頻度に応じて適切な内部ティアに自動的に移動させる方式です。ユーザーがオブジェクトごとに「これは頻繁にアクセスするデータ」「これは30日後からあまり見ないデータ」「これは90日後にはほとんど保管用データ」と直接判断する必要はありません。
一文でまとめるとこうなります。
S3 Intelligent-Tieringは、アクセスパターンを予測しにくいデータのために、S3がオブジェクト単位で利用頻度を監視し、自動的にコストを最適化するストレージクラスです。
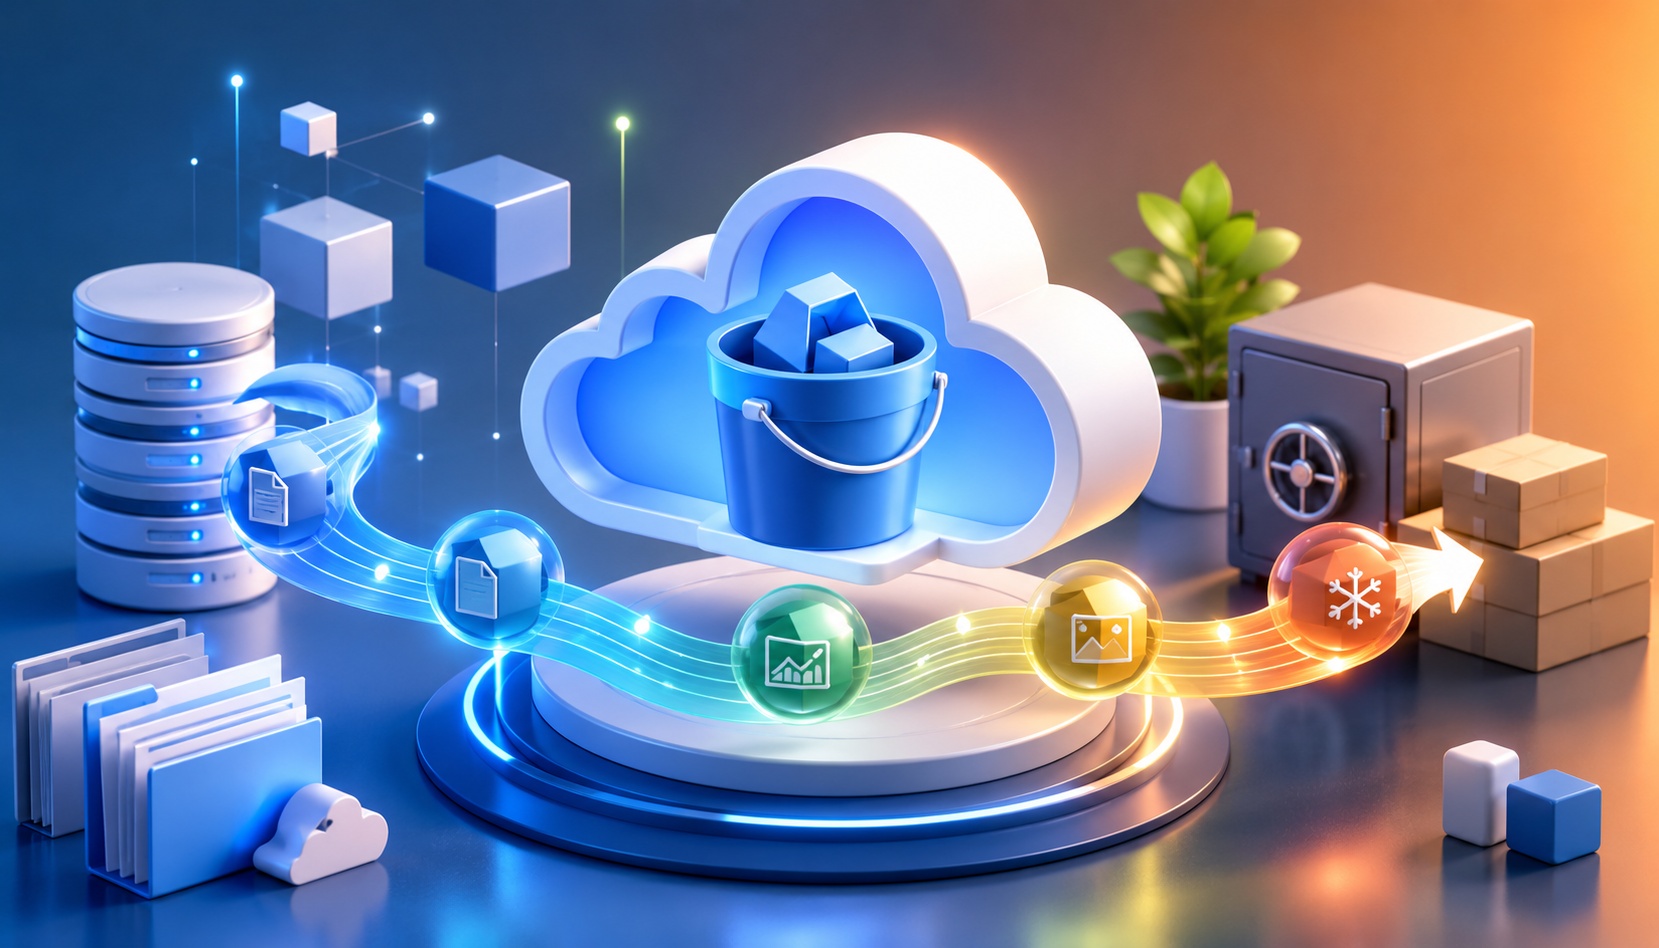
S3 Standardは「常に机の上に置いてある書類」のようなものです。いつでもすぐに確認できますが、すべての書類を机の上に置くとスペースコストが高くつきます。
Standard-IAは「机の横のキャビネットに入れた書類」に似ています。保管コストは少し削減されますが、取り出す際にコストが発生する可能性があります。
Glacier Flexible RetrievalやDeep Archiveは「倉庫に送った書類」に近いものです。保管コストは非常に低いですが、取り出すには時間がかかります。
Intelligent-Tieringは「書類の使用頻度を見て、自動的に机、キャビネット、近い保管場所に移動させてくれる管理者」と見なすことができます。よく見る書類は机の上に置き、しばらく見ていない書類はキャビネットに移動させ、長く見ていない書類はより安価な保管場所に移動させます。しかし、突然再び必要になった場合は、再び机の上に戻してくれます。
S3ストレージクラスの選択が難しい理由
S3には複数のストレージクラスがあります。頻繁にアクセスするデータにはS3 Standardが適しており、頻繁にはアクセスしないが必要な時に素早く読み込む必要があるデータにはStandard-IAやOne Zone-IAを検討できます。アーカイブの性質が強い場合は、Glacier Instant Retrieval、Glacier Flexible Retrieval、Glacier Deep Archiveのような選択肢もあります。
問題は、データの将来のアクセスパターンを人間が正確に予測するのが難しいという点です。
例えば、ウェブサービスの画像ファイルを考えてみましょう。アップロード直後はユーザーが頻繁に閲覧します。しかし、時間が経つとほとんどの画像はほとんどアクセスされなくなります。ところが、一部の画像は検索結果に表示されたり、イベントページで再利用されたり、顧客からの問い合わせのために再び読み込まれたりすることがあります。すべての画像をStandardに置くとコストが高くなり、すべての画像をIAやGlacierに早く移動させると、後で読み込む際に検索コストや復元遅延が問題になる可能性があります。
ログデータも同様です。アプリケーションログ、セキュリティログ、分析ログは、最初の数日または数週間は頻繁に照会されることがあります。障害分析やセキュリティ事故調査が完了すると、アクセス頻度は急激に低下します。しかし、監査、フォレンジック、規制遵守、顧客課題対応のために数ヶ月後に再び照会される可能性もあります。
データレイクも似ています。あるパーティションは毎日分析クエリに使用されますが、あるパーティションはほとんど読み込まれません。同じバケット、同じプレフィックス内にあっても、オブジェクトごとに使用頻度が異なる場合があります。
このような環境で、ライフサイクルポリシーだけで完璧な最適化を行うのは容易ではありません。ライフサイクルは強力ですが、基本的にはルールベースです。「作成後30日が経過したらStandard-IAに移動」「90日が経過したらGlacierに移動」といった形で設定します。データの実際のアクセス有無よりも、オブジェクトの経過日数やプレフィックス、タグなどの条件を基準に動作します。
一方、Intelligent-Tieringは「時間が経過したか?」よりも「実際にアクセスされたか?」を基準に判断します。この違いが重要です。
Intelligent-Tieringが選ばれる理由
1. アクセスパターンが分からなくても始められる
S3 Intelligent-Tieringの最大の利点は、アクセスパターンを知らなくても良いという点です。運用者がすべてのオブジェクトの使用パターンを予測する必要はありません。新規サービス、データレイク、ユーザーアップロードコンテンツ、バックアップデータ、分析データのようにアクセスパターンが変化したり予測しにくいデータに特に有用です。
S3 Standardは安全な選択ですが、長期的には高価になる可能性があります。Standard-IAは保存コストは低いですが、読み込む際に検索料金がかかります。Glacier系はより安価ですが、復元時間や最小保管期間を考慮する必要があります。Intelligent-Tieringはこのような選択の負担を軽減します。
最初はFrequent Accessティアに保存し、一定期間アクセスがないと自動的に安価な内部ティアに移動します。後で再びアクセスされると、再びFrequent Accessティアに戻ってきます。運用者は「いつ移動するか」を細かく判断する必要がありません。
2. オブジェクト単位で判断する
Intelligent-Tieringの核心はオブジェクト単位の最適化です。
ライフサイクルポリシーをプレフィックス単位で設定すると、同じフォルダ内のオブジェクトが同様に移動します。しかし実際には、同じパスにあっても、あるオブジェクトは頻繁に読み込まれ、あるオブジェクトはほとんど読み込まれません。Intelligent-Tieringは各オブジェクトのアクセスパターンを個別に監視します。
例えば、次のようなデータがあるとしましょう。
- images/2026/01/a.jpgは毎日アクセスされる
- images/2026/01/b.jpgは40日間アクセスなし
- images/2026/01/c.jpgは100日間アクセスなし
これら3つのオブジェクトが同じプレフィックスにあっても、Intelligent-Tieringは同じように処理しません。頻繁にアクセスされるオブジェクトはFrequent Accessティアに残り、30日以上アクセスされていないオブジェクトはInfrequent Accessティアに移動し、90日以上アクセスされていないオブジェクトはArchive Instant Accessティアに移動します。
この構造はコスト最適化の側面で非常に有利です。人間がフォルダ単位で大まかに判断するのではなく、S3がオブジェクトごとにアクセス有無を基準に判断するためです。
3. Frequent, Infrequent, Archive Instantは性能低下なしで利用できる
Intelligent-Tieringの自動ティアは大きく3つに理解できます。
- Frequent Access tier
- Infrequent Access tier
- Archive Instant Access tier
これら3つのティアは自動的に管理され、低い遅延時間と高いスループットを提供します。つまり、Infrequent AccessティアやArchive Instant Accessティアに移動したからといって、アプリケーションが復元リクエストを先に行う必要はありません。一般的なGETリクエストで直接読み込むことができます。
この点がGlacier Flexible RetrievalやGlacier Deep Archiveとの大きな違いです。Glacier Flexible RetrievalやDeep Archiveはコストは低いですが、即時読み込み用途ではありません。オブジェクトをまず復元する必要があり、復元時間も考慮しなければなりません。一方、Intelligent-TieringのArchive Instant Accessティアは、その名の通り即時アクセス可能なアーカイブ性質の階層です。
そのため、「コストは削減したいが、突然読み込む必要が生じるかもしれないデータ」にIntelligent-Tieringがよく合います。
4. 検索料金がかからない
Standard-IA、One Zone-IA、Glacier Instant Retrievalのようなストレージクラスは、保存コストは低いですが、データを読み込む際に検索料金が発生する可能性があります。したがって、アクセス頻度が予想よりも高くなると、保存コスト削減分よりも検索コストが負担になることがあります。
Intelligent-Tieringは内部ティア間の移動後も検索料金がかかりません。Infrequent AccessティアやArchive Instant Accessティアにあったオブジェクトを読み込んでも、一般的な検索料金は課金されません。また、Intelligent-Tiering内部でティアが移動する際に別途のティアリング料金もありません。
もちろん、S3リクエスト費用、データ転送費用、PUT/COPY/ライフサイクル移行費用のような一般的な費用要素は別途考慮する必要があります。しかし、「IAに移動したら読み込むたびに検索費用がかかる」という負担がない点は、Intelligent-Tieringの大きな利点です。
5. 最小保管期間の負担が小さい
Standard-IAやOne Zone-IAは最小保管期間を考慮する必要があります。Glacier系も最小保管期間があります。あまりにも早く削除したり、他のストレージクラスに移動させたりすると、残りの期間に対する費用が発生する可能性があります。
Intelligent-Tieringは一般的な自動ティア運用において最小保管期間の負担がありません。この点は、データ寿命が不確実なサービスで特に有用です。ユーザーアップロードファイルのようにいつ削除されるか分からない場合や、分析データのようにプロジェクト状況によって保管期間が異なる場合には、最小保管期間がない構造が運用上便利です。
Intelligent-Tieringはどのように監視し、決定するのか?
Intelligent-Tieringの動作を理解するには、「ストレージクラス」と「内部アクセスティア」を区別する必要があります。
オブジェクトのストレージクラスはS3 Intelligent-Tieringです。オブジェクトが30日後にInfrequent Accessティアに移動したり、90日後にArchive Instant Accessティアに移動したりしても、ユーザーが見るストレージクラス自体がStandard-IAやGlacier Instant Retrievalに変わるわけではありません。
つまり、オブジェクトは引き続きIntelligent-Tieringストレージクラスに属しており、その中で内部アクセスティアのみが変更されます。
基本フロー
オブジェクトがS3 Intelligent-Tieringに保存されると、最初はFrequent Accessティアから始まります。その後、S3がオブジェクトのアクセスパターンを監視します。
一定期間アクセスがないと、次のように移動します。
| 条件 | 移動結果 |
| オブジェクトのアップロードまたは移行直後 | Frequent Access tier |
| 30日間連続アクセスなし | Infrequent Access tier |
| 90日間連続アクセスなし | Archive Instant Access tier |
| InfrequentまたはArchive Instant状態から再度アクセス | Frequent Access tierに自動復帰 |
このフローを擬似コードで表現すると次のようになります。
객체가 S3 Intelligent-Tiering에 저장됨
  → Frequent Access tier에서 시작

객체 크기가 128KB 미만이면
  → 자동 티어링 대상 아님
  → 감시하지 않음
  → 감시 및 자동화 요금 없음
  → Frequent Access tier 요금으로 유지

객체 크기가 128KB 이상이면
  → S3가 객체 단위 접근 패턴 감시

30일 연속 접근 없음
  → Infrequent Access tier로 이동

90일 연속 접근 없음
  → Archive Instant Access tier로 이동

Infrequent Access 또는 Archive Instant Access 상태에서 객체 접근 발생
  → Frequent Access tier로 자동 이동
ここで重要な基準は「連続未アクセス期間」です。単にオブジェクトが作成されてから30日が経過したからといって無条件に移動するのではなく、アクセスされていない期間を基準に判断します。
どのような行為がアクセスと認められるか?
S3がIntelligent-Tieringのティア移動を判断する際、すべてのAPI呼び出しを同じようにアクセスと見なすわけではありません。実際のオブジェクトデータを読み書きする性質の作業がアクセスと認められます。
例えば、一般的に次のような作業はオブジェクトがアクセスされたと見なされます。
- コンソールからオブジェクトをダウンロード
- コンソールからオブジェクトをコピー
- GetObject
- PutObject
- CopyObject
- UploadPartCopy
- RestoreObject
- CompleteMultipartUpload
- S3 Batch Replicationによる複製
一方、次のような作業はオブジェクトをFrequent Accessティアに上げるアクセスとは見なされません。
- HeadObject
- GetObjectTagging
- PutObjectTagging
- ListObjects
- ListObjectsV2
- ListObjectVersions
- UpdateObjectEncryption
この違いは実務で重要です。例えば、単にリストを照会したりメタデータを確認しただけで、すべてのオブジェクトが再びFrequent Accessティアに戻ってくると、コスト最適化が難しくなります。そのため、S3は実際のデータアクセスと管理性作業を区別します。
ファイルの内容を実際に読み書きする行動はアクセスと見なし、
単純なリスト照会やタグ照会のような管理性作業はアクセスと見なさない。
選択型アーカイブティアまで有効にするとどうなるか?
Intelligent-Tieringは基本的に3つの自動ティアを提供します。
- Frequent Access tier
- Infrequent Access tier
- Archive Instant Access tier
ここまでは即時アクセス可能な階層です。しかし、より低いコストを望み、データを即時読み込む必要がない場合は、選択型アーカイブティアを追加で有効にすることができます。
選択型アーカイブティアは次の通りです。
- Archive Access tier
- Deep Archive Access tier
Archive Accessティアは、最低90日以上アクセスがないオブジェクトを対象に利用でき、Deep Archive Accessティアは、最低180日以上アクセスがないオブジェクトを対象に利用できます。設定によっては、この期間をさらに長く調整することも可能です。
ただし、これら2つのティアは即時アクセス用ではありません。オブジェクトがArchive AccessまたはDeep Archive Accessティアに入ると、読み込む前にRestoreObjectを介して復元する必要があります。したがって、アプリケーションが即座にファイルを読み込む必要がある構造であれば、慎重に使用する必要があります。
まとめると次のようになります。
| 区分 | 即時アクセス可能か | 説明 |
| Frequent Access | 可能 | 基本ティア |
| Infrequent Access | 可能 | 30日未アクセス後に自動移動 |
| Archive Instant Access | 可能 | 90日未アクセス後に自動移動 |
| Archive Access | 復元が必要 | 選択して有効化、分〜時間単位で復元 |
| Deep Archive Access | 復元が必要 | 選択して有効化、長期保管用 |
運用環境では、Archive AccessとDeep Archive Accessを無条件に有効にするよりも、データの利用方法に応じて決定する必要があります。特にユーザーダウンロード、ウェブサービス画像、分析クエリ対象データのように即時アクセスが必要なデータであれば、基本の3つのティアのみを使用する方がより安全です。
監視料はどのように計算されるか?
Intelligent-Tieringはオブジェクトのアクセスパターンを監視し、自動移動を実行するため、月額の監視および自動化料金が発生します。米国東部(バージニア北部)を基準に、監視および自動化料金はオブジェクト1,000個あたり月額0.0025ドルです。
オブジェクト数に換算すると次のようになります。
| オブジェクト数 | 月額監視および自動化料金 |
| 1,000個 | 0.0025ドル |
| 100,000個 | 0.25ドル |
| 1,000,000個 | 2.50ドル |
| 10,000,000個 | 25.00ドル |
| 100,000,000個 | 250.00ドル |
この費用だけを見ると非常に小さく見えます。しかし、オブジェクト数が数億個以上に増えると、無視できない費用になる可能性があります。特に小さなログファイル、サムネイル、IoTイベントの断片のようにオブジェクト数が非常に多い構造では、必ず計算する必要があります。
ただし、128KB未満のオブジェクトは自動ティアリングの対象外であり、監視および自動化料金も課金されません。これらの小さなオブジェクトはIntelligent-Tieringに保存することはできますが、常にFrequent Accessティアの料金で維持されます。
そのため、費用を見る際には「全体の容量」だけでなく「オブジェクト数」も一緒に見る必要があります。S3のコスト最適化でよく間違いを犯すのがこの点です。10TBを保存する場合でも、オブジェクトが10万個の場合と10億個の場合では、監視料の観点から全く異なります。
ライフサイクルとIntelligent-Tieringは競合関係か?
ライフサイクルポリシーとIntelligent-Tieringは、互いに競合する機能というよりも目的が異なります。
ライフサイクルはポリシーベースの自動化です。例えば、「logs/プレフィックス以下のオブジェクトは30日後にStandard-IA、90日後にGlacier Deep Archiveに移動」のように明確なルールを適用します。データの寿命とアクセスパターンをすでに知っている場合は、ライフサイクルの方がより単純で安価になる可能性があります。
一方、Intelligent-Tieringは観察ベースの自動化です。S3がオブジェクトごとのアクセスパターンを監視し、アクセスがない場合は自動的に安価なティアに移動させます。アクセスパターンが不確実な場合や、オブジェクトごとに異なる場合に有利です。
両者を比較すると次のようになります。
| 区分 | ライフサイクル | Intelligent-Tiering |
| 基準 | 作成後の経過日数、プレフィックス、タグなど | オブジェクトごとのアクセスパターン |
| 利点 | 予測可能なデータに強い | 予測が難しいデータに強い |
| 欠点 | 実際のアクセス有無に関わらず移動可能 | 監視および自動化料金が存在 |
| 適切な例 | ログ、バックアップ、規制上の長期保管データ | データレイク、ユーザーアップロード、新規サービスデータ |
| 運用方式 | 人間がルールを設計 | S3がオブジェクトごとに自動判断 |
アクセスパターンが明確ならライフサイクルを設計、
アクセスパターンが不確実ならIntelligent-Tieringを検討。
どのような状況でIntelligent-Tieringを選択すれば良いか?
新規サービスのユーザーアップロードデータ
新規サービスでは、どのようなデータがどれくらいの頻度で読み込まれるか予測が難しいです。ユーザーがアップロードした画像、文書、動画、添付ファイルは、初期には頻繁にアクセスされますが、時間が経つにつれてアクセス頻度が減少するケースが多いです。しかし、一部のコンテンツは後で再び人気が出たり、顧客からの問い合わせで照会されたりすることがあります。
このような場合、最初からStandard-IAやGlacierに送るのは負担が大きいです。Intelligent-Tieringを使用すれば、初期にはStandardのように素早くアクセスし、アクセスが減少したオブジェクトのみが自動的に安価なティアに移動できます。
データレイクと分析データ
データレイクには多様なデータが混在します。あるデータは毎日分析クエリに使用されますが、あるデータは過去の履歴としてのみ残ります。パーティション、日付、顧客、サービス別にアクセス頻度が異なる場合があります。
ライフサイクルだけで全てのデータを正確に分類しようとすると、ルールが複雑になります。Intelligent-Tieringはオブジェクト単位でアクセスパターンを監視するため、データレイクのようにアクセス頻度が多様な環境によく合います。
セキュリティログと監査データ
セキュリティログは、事故直後には頻繁に照会されますが、時間が経つとほとんど照会されなくなります。しかし、規制遵守や侵害事故調査のために後で再び必要になることがあります。つまり、「普段はあまり見ないが、必要な時にはすぐにアクセスしなければならないデータ」に近いものです。
このような場合、Archive Instant Accessまで自動的に移動しても即時アクセス可能なIntelligent-Tieringが有用である可能性があります。ただし、選択型Archive AccessやDeep Archive Accessを有効にする場合は復元時間が必要となるため、セキュリティ監視や事故対応の要件をまず確認する必要があります。
アクセスパターンがまだ不明な移行データ
オンプレミスからS3へデータを大量に移行する際にも、Intelligent-Tieringは良い出発点となり得ます。既存のファイルサーバーやNASのアクセスパターンを正確に知らないケースが多いためです。
無闇にStandardに置くとコストが高くなり、無闇にGlacierに送ると後で業務中断が生じる可能性があります。Intelligent-Tieringをデフォルト値として設定すれば、実際のアクセスパターンを見ながら自動的にコストを削減できます。
Intelligent-Tieringを避けるべき状況とは?
Intelligent-Tieringが常に正解とは限りません。
データが常に頻繁に読み込まれる場合
すべてのオブジェクトが常に頻繁に読み込まれる場合、Intelligent-Tieringの利点は大きくありません。オブジェクトがFrequent Accessティアに残り続ける可能性が高いためです。この場合、S3 Standardと同様の保存コストを支払いながら、監視料だけが追加される可能性があります。
ウェブサービスの主要な静的アセット、毎回読み込まれるモデルファイル、頻繁に参照される設定ファイルのように常にホットなデータであれば、Standardの方がより単純である可能性があります。
アクセスパターンが明確な場合
例えば、「このログは7日間だけ頻繁に見て、30日後にはほとんど見なくなり、1年後には削除する」のようにライフサイクルが明確なデータは、ライフサイクルの方がより適している可能性があります。
定められたルールに従って移動すれば良いのに、わざわざ監視料を払ってIntelligent-Tieringを使用する必要はないかもしれません。
非常に小さなオブジェクトが多すぎる場合
128KB未満のオブジェクトはIntelligent-Tieringに保存できますが、自動ティアリングの対象ではありません。監視料も課金されませんが、常にFrequent Accessティアの料金で維持されます。つまり、小さなオブジェクトが多いからといって、Intelligent-Tieringが自動的にコストを大幅に削減するわけではありません。
非常に小さなオブジェクトが多数存在する環境では、オブジェクトの結合、圧縮、パーティショニング、ログフォーマットの改善といったデータ構造の改善の方がより重要である可能性があります。
即時アクセスが必要なのに選択型Deep Archiveを有効にする場合
Intelligent-Tieringの基本自動ティアであるArchive Instant Accessは即時アクセス可能です。しかし、選択型Archive AccessとDeep Archive Accessは復元プロセスが必要です。アプリケーションがオブジェクトをすぐに読み込む必要がある構造なのにDeep Archive Accessを有効にすると、障害のように見える状況が発生する可能性があります。
したがって、選択型アーカイブティアは「本当に復元遅延を受け入れられるデータ」にのみ適用するのが安全です。
実務適用例
新しくアップロードするオブジェクトをIntelligent-Tieringで保存するには、PUTリクエスト時にストレージクラスを指定できます。
aws s3api put-object
  --bucket my-bucket-name
  --key uploads/sample.jpg
  --body ./sample.jpg
  --storage-class INTELLIGENT_TIERING
既存のオブジェクトをIntelligent-Tieringにコピーしながらストレージクラスを変更することもできます。
aws s3api copy-object
  --bucket my-bucket-name
  --copy-source my-bucket-name/uploads/sample.jpg
  --key uploads/sample.jpg
  --storage-class INTELLIGENT_TIERING
  --metadata-directive COPY
バケットの特定のプレフィックスに対して、ライフサイクルポリシーでIntelligent-Tieringへの移行を適用することもできます。例えば、uploads/以下のオブジェクトを作成後0日後にIntelligent-Tieringに移行するには、次のようなポリシーを使用できます。
{
  "Rules": [
    {
      "ID": "transition-to-intelligent-tiering",
      "Status": "Enabled",
      "Filter": {
        "Prefix": "uploads/"
      },
      "Transitions": [
        {
          "Days": 0,
          "StorageClass": "INTELLIGENT_TIERING"
        }
      ]
    }
  ]
}
適用は次のように行えます。
aws s3api put-bucket-lifecycle-configuration
  --bucket my-bucket-name
  --lifecycle-configuration file://lifecycle.json
実務では、バケット全体に無条件に適用するよりも、プレフィックスやタグを基準に分けるのが良いでしょう。例えば、ユーザーアップロードファイルはIntelligent-Tiering、静的ウェブリソースはStandard、明確な長期保管ログはライフサイクルを通じてGlacier Deep Archiveに送る、といった具合です。
コスト判断のための簡単なチェックリスト
Intelligent-Tieringを適用する前に、次の質問をしてみると良いでしょう。
- このデータのアクセスパターンを正確に予測できますか?
- オブジェクトごとにアクセス頻度が大きく異なりますか?
- 後で突然再び読み込む可能性がありますか?
- 検索料金が予測できないことが負担になりますか?
- オブジェクト数が過度に多く、監視料が大きくなりませんか?
- 128KB未満の小さなオブジェクトがほとんどではありませんか?
- 選択型Archive AccessやDeep Archive Accessを有効にしても復元遅延を許容できますか?
- ライフサイクルでより単純かつ安価に解決できるデータではありませんか?
これらの質問に対して「アクセスパターンがよく分からない」「オブジェクトごとに使用頻度が異なる」「再び読み込む可能性がある」「運用者が毎回ポリシーを調整するのは難しい」という回答が多い場合、Intelligent-Tieringが良い選択肢となる可能性が高いです。
逆に「常に頻繁に読み込む」「正確に90日後からは絶対に読み込まない」「1年間保管後に削除する」のようにパターンが明確な場合は、Standardやライフサイクルベースの移行の方がより適している可能性があります。
結論:Intelligent-Tieringは「分からない」ことを認める設計である
クラウドのコスト最適化において最も危険なのは、誤った確信です。「このデータは今後見ないだろう」と思っていても実際には頻繁に読み込まれることがあり、「このデータは常に必要だろう」と思っていても数ヶ月間誰も見ないことがあります。
S3 Intelligent-Tieringは、このような不確実性を前提に設計されたストレージクラスです。人間がすべてのアクセスパターンを予測するのではなく、S3がオブジェクト単位でアクセス有無を監視し、自動的に適切なティアに移動させます。
そのため、Intelligent-Tieringは単に「安価なストレージクラス」ではありません。より正確に言えば、「予測が難しいデータのための自動コスト最適化戦略」です。
このようにまとめると良いでしょう。
- アクセスパターンが明確ならライフサイクルを設計する。
- アクセスパターンが不確実ならIntelligent-Tieringを検討する。
- 即時アクセスが必要なら基本自動ティアまでのみ使用する。
- 長期保管で復元遅延を許容できるなら選択型Archive / Deep Archiveまで考慮する。
- オブジェクト数と128KB未満オブジェクトの割合は必ず確認する。
S3のコスト最適化の核心は、無条件に最も安いストレージクラスを選ぶことではありません。データのアクセス方法、復元要件、リクエスト費用、運用複雑度まで含めて全体コストを削減することです。その観点から、S3 Intelligent-Tieringは「運用者が未来を正確に予測しなくても良い」非常に実用的な選択肢です。
コメントを残す