こんにちは!データが流れるパイプラインの世界を探求する皆さんを歓迎します。😄
データを処理していると、一つのパイプラインで完結するのではなく、複数のパイプラインを連結する必要がある場合がよく発生します。まるでレゴブロックを組み立てるように、それぞれの機能を持つパイプラインを有機的に連結して、より大きく複雑なシステムを構築しなければなりません。
この時、パイプラインAの終わりとパイプラインBの始まりをスムーズにつなぐ役割が必要になりますが、その主役こそがコネクター(Connector)です!🚀
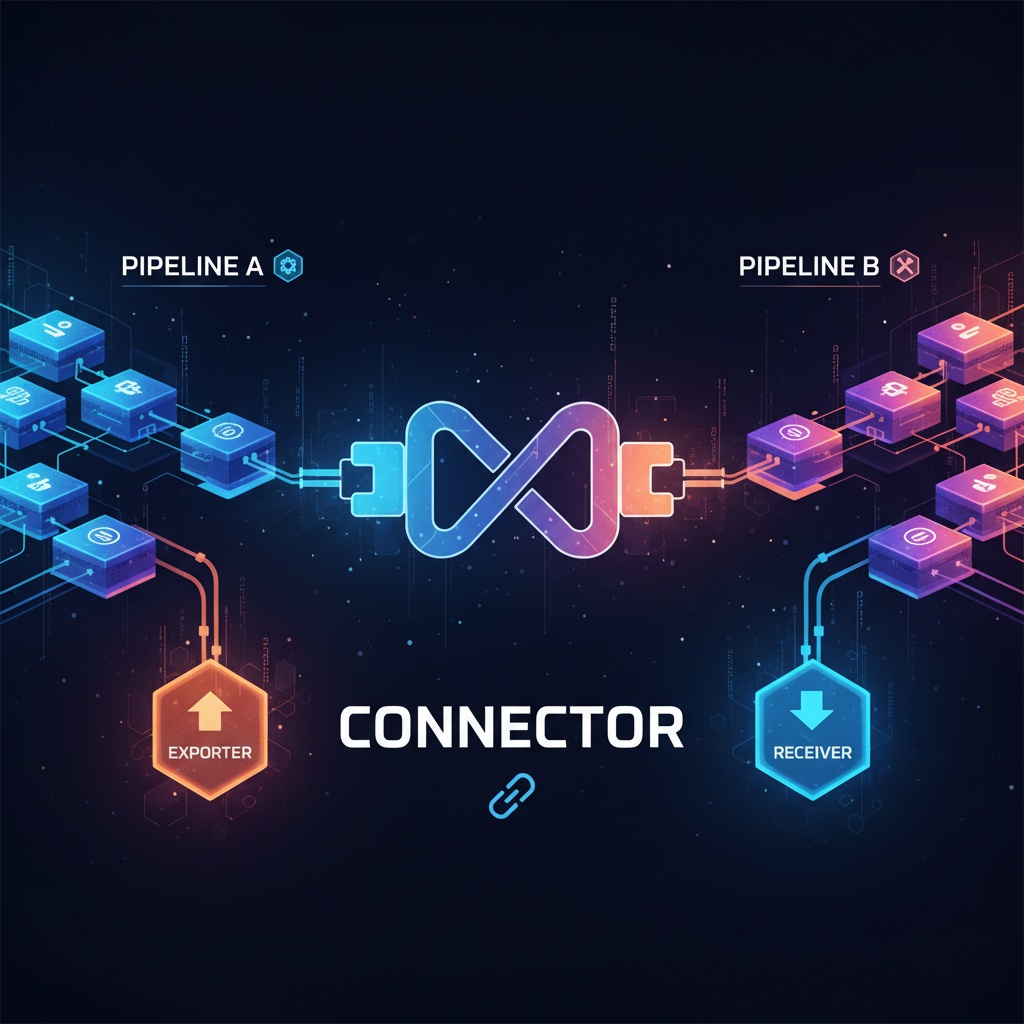
🔌 コネクター(Connector)とは何でしょうか?
非常に簡単に定義してみましょう。
コネクター(Connector)は、一つのパイプラインの終わり(Exporter)と別のパイプラインの始まり(Receiver)を接続する構成要素です。
つまり、一つのパイプラインで処理され、エクスポートされたデータを消費し、次のパイプラインが受け取れるように伝達する重要な橋渡し役を果たすわけです。🌉
🤔 コネクターはどのように動作しますか?
コネクターの動作方式を段階別に見ていくと、はるかに理解しやすくなります。
- データ処理 (パイプライン A) ⚙️
- 最初のパイプライン(A)でデータが収集され、加工され、分析されるなど一連の処理が行われます。
- データのエクスポート (Exporter) 📤
- パイプラインAは、処理された最終データを外部にエクスポートする準備をします。この段階を「Exporter」と呼びます。Exporterは「さあ、データ処理が終わったよ!誰か持っていく人?」と叫ぶようなものです。
- データの接続と伝達 (Connector) 🔗
- まさにこの時、コネクターが登場します!✨
- コネクターは、パイプラインAのExporterがエクスポートしたデータをがっちり受け取ります(消費します)。
- そして、そのデータを次のパイプライン(B)が受け取れる形に変換したり、そのまま伝達する準備をします。
- データの受信 (Receiver) 📥
- 二番目のパイプライン(B)の入り口、つまり「Receiver」は、コネクターが伝達するデータを受け取ります。「データはちゃんと受け取ったよ!これで私たちのパイプラインで処理を始めるよ!」というわけです。
- 新しい処理の開始 (パイプライン B) 🛠️
- パイプラインBは、受け取ったデータを使って独自の新しい処理過程を開始します。
この過程を図で表現すると次のようになります。
[パイプライン A ⚙️] -> [Exporter 📤] -> [🔌 コネクター 🔗] -> [Receiver 📥] -> [パイプライン B 🛠️]
💡 なぜコネクターが重要なのでしょうか?
コネクターを使用すると、いくつかの利点があります。
- モジュール性の向上: 各パイプラインを独立した機能単位として作成できます。パイプラインAはデータ収集、パイプラインBはデータ分析、パイプラインCは視覚化のように役割を分離することで、管理が容易になります。
- 柔軟なアーキテクチャ: 必要に応じてパイプラインを簡単に接続したり切り離したりできます。途中に新しいパイプラインを挿入したり、特定のパイプラインだけを交換したりすることが自由になります。
- 再利用性の向上: よく構築されたパイプラインは、コネクターを介して様々なシステムで簡単に再利用できます。
複雑なデータフローを設計する際、パイプラインの終わりと始まりを接続する「コネクター」の概念をよく理解し活用することで、はるかに効率的で拡張可能なシステムを構築できるでしょう!💪
コメントを残す