こんにちは!今日は、システム監視とデバッグの効率を一段と向上させるOpenTelemetryの強力な機能、Exemplarについてお話ししたいと思います。
📊 「なぜ?」が分からなかったメトリクスの限界
システムを運用していると、このような経験は誰しも一度はあるのではないでしょうか。
「あれ?急にAPIの応答時間がこんなに跳ね上がったのはなぜだろう?」📈 「エラー率が急増したけど、一体どのリクエストで問題が起きたんだろう?」🤔
私たちは通常、ダッシュボードで上記のようなメトリクス(Metric)グラフを見て問題を認識します。レイテンシー、エラー率、CPU使用率のような集計データは、システム全体の状態を把握するのに非常に役立ちます。
しかし、メトリクスは「何が(What)」起こったかは教えてくれますが、「なぜ(Why)」起こったかまでは教えてくれないことが多いです。急増したレイテンシースパイクを見ても、その原因となった特定のリクエストを見つけるために、膨大なログやトレースを漁らなければならないという途方に暮れる状況に陥りがちです。😵
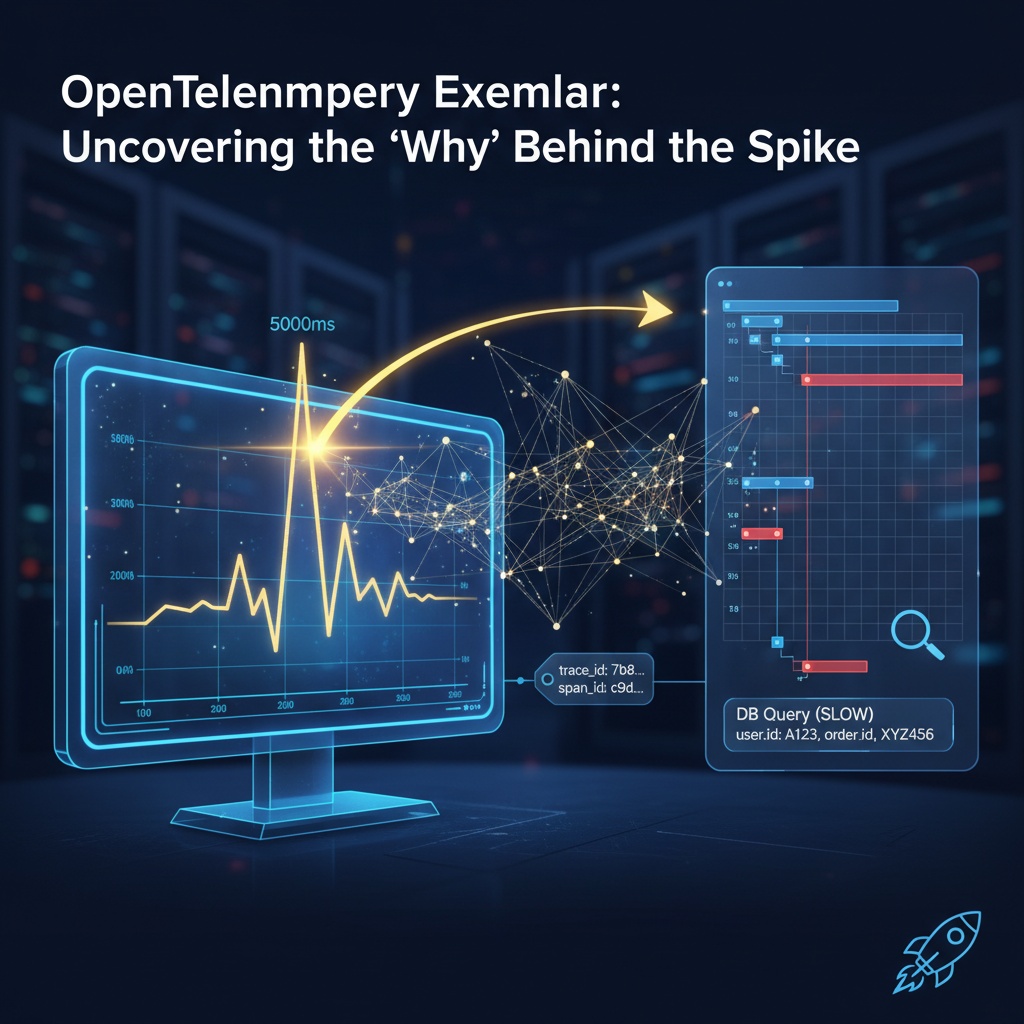
🔗 メトリクスとトレースをつなぐ橋、Exemplar!
まさにこんな時、Exemplarが救世主のように登場します!
Exemplarの核となる機能はこれです:
特定のメトリクス値を、それを引き起こした具体的なトレース(Trace)サンプルと直接リンクさせること!
簡単に言えば、「問題を引き起こしたまさにそのやつ」の情報をメトリクスデータにピンポイントで一緒に記録してくれる機能です。
例を見てみましょう。
- レイテンシースパイク発生:P99レイテンシーが200msから突然5000msに跳ね上がるのをメトリクスグラフで発見します。
- Exemplar確認:この5000msというメトリクスデータポイントを確認すると、Exemplarが一緒に記録されています。このExemplarには、当時最も遅かったリクエストのtrace_idとspan_idが含まれています。
- 原因追跡:私たちはこのtrace_idを利用して、オブザーバビリティプラットフォーム(Jaeger、Grafanaなど)で、該当リクエストの分散トレース(Distributed Trace)情報をワンクリックで探し出すことができます。🖱️
- 問題解決:トレースを分析すると、特定の外部API呼び出しでタイムアウトが発生したか、特定のデータベースクエリが異常に遅かったという事実をすぐに確認できます。
Exemplarがなければ、私たちはスパイクが発生した時間帯を基準に、膨大なログやトレースの山の中から原因となりそうなリクエストを「推測」しながら探し回っていたことでしょう。しかし、Exemplarのおかげで、推測の領域が確認の領域へと変わります。
✨ Exemplarが提供する驚くべき価値
Exemplarを使用すると、以下の利点が得られます。
- 豊富なコンテキスト提供:単純な数字(メトリクス)に「物語(トレース)」を加えてくれます。「レイテンシーが5秒」という事実を超えて、「ユーザーAの注文リクエストがデータベースBの遅いクエリのために5秒かかった」という具体的なコンテキストを得られます。📜
- 画期的に速いデバッグ:問題の原因となったリクエストの例を直接確認できるため、根本原因を特定し解決にかかる時間が劇的に短縮されます。🎯
- 集計データの落とし穴からの脱却:平均値やパーセンタイルなどの集計データは、個別の異常値(outlier)を隠してしまうことがあります。Exemplarは、このような隠れた異常値を表面化させます。
📊 Prometheus Exemplar Pythonの例
最も一般的な使用例であるPrometheusのPythonクライアントライブラリ(prometheus_client)を使用した例です。
1. カウンター(Counter)メトリクスにExemplarを追加する
リクエストが来るたびに数を数えるカウンターに、どのリクエストだったかのTrace IDを一緒に記録する例です。
from prometheus_client import Counter
import time
import random
import string

# 'my_requests_total'という名前のカウンターメトリクスを作成します。
c = Counter('my_requests_total', 'Total number of HTTP requests')

def generate_trace_id(length=10):
    """간단한 랜덤 Trace ID 생성 함수"""
    return ''.join(random.choice(string.ascii_lowercase + string.digits) for _ in range(length))

# リクエストをシミュレートし、Exemplarを追加
for _ in range(5):
    # 各リクエストごとに一意のTrace IDを生成します。
    trace_id = generate_trace_id()

    # .inc()メソッドを呼び出す際にexemplar辞書を渡します。
    # このTrace IDがメトリクスデータにタグのように付与されます。
    c.inc(exemplar={'trace_id': trace_id})

    print(f"Request handled with trace_id: {trace_id}")
    time.sleep(1)
コード説明:
- Counterを使用して、`my_requests_total`という名前のメトリクスを作成します。
- リクエストが処理されるたびに`c.inc()`を呼び出して、カウンターを1ずつ増加させます。
- このとき、`exemplar`引数として`{‘trace_id’: ‘…’}`のような辞書を渡すと、その時点のメトリクスデータにこの情報がリンクされます。
2. ヒストグラム(Histogram)メトリクスにExemplarを追加する
リクエストの遅延時間(latency)分布を追跡するヒストグラムに、特定のリクエストのTrace IDを記録する例です。
from prometheus_client import Histogram
import time
import random
import string

# 'request_latency_seconds'という名前のヒストグラムメトリクスを作成します。
h = Histogram('request_latency_seconds', 'Request latency')

def generate_trace_id(length=10):
    """간단한 랜덤 Trace ID 생성 함수"""
    return ''.join(random.choice(string.ascii_lowercase + string.digits) for _ in range(length))

# リクエスト遅延時間をシミュレートし、Exemplarを追加
for _ in range(5):
    latency = random.uniform(0.1, 1.5)  # 0.1秒から1.5秒の間のランダムな遅延時間
    trace_id = generate_trace_id()

    # .observe()メソッドで遅延時間を記録する際にexemplar辞書を渡します。
    h.observe(latency, exemplar={'trace_id': trace_id})

    print(f"Observed latency {latency:.2f}s with trace_id: {trace_id}")
    time.sleep(1)
コード説明:
- Histogramを使用して、`request_latency_seconds`という名前のメトリクスを作成します。
- リクエストが完了すると、`h.observe(latency)`を呼び出して測定された遅延時間を記録します。
- 同様に、`exemplar`引数に`trace_id`を含めて渡すと、特定の遅延時間値と該当リクエストのTraceがリンクされます。
🧐 Exemplarはどのように表示されますか?
上記のコードを実行し、Prometheusが収集するデータ(OpenMetrics形式)を見ると、以下のようにメトリクスの末尾に# {trace_id=”…”} 値 タイムスタンプ形式のExemplar情報が追加されていることがわかります。
# TYPE my_requests_total counter
my_requests_total_total 5.0 # {trace_id="a1b2c3d4e5"} 5.0 1665789605.123
この情報をGrafanaのような可視化ツールで見ると、グラフの特定のデータポイント上に点として表示され、クリックするとリンクされたTrace IDを通じて、その時点の詳細なログやトレースデータに直接移動できます。
終わりに
OpenTelemetryのExemplarは、単なるもう一つの機能ではありません。メトリクスとトレースという2つの重要なデータを有機的に連携させ、私たちがシステムを理解し、問題を解決する方法を根本的に変える強力なツールです。🛠️
もし、あなたの監視システムで「なぜ?」という問いに答えを見つけるのが難しかったなら、ぜひExemplarを通じて、データに基づいた迅速かつ正確なデバッグを体験してみてください!💪
コメントを残す