こんにちは!開発者の皆さん、システムを運用していると、こんな瞬間ってありますよね?
“あれ?急にAPIの応答時間が遅くなったぞ?” 😱 “エラー率が急増しました!一体どこが問題でしょうか?” 😭
こんな時、私たちは通常ダッシュボードを開いて様々な指標を確認します。しかし、グラフだけでは問題の「本当の」原因を把握するのが難しいことがよくあります。今日は、なぜメトリクスとトレースを「接続」して見るべきなのか、その強力な相乗効果について詳しく見ていきましょう。
1. メトリクス: 私たちのシステムの健康指標 🩺
メトリクス(Metric)は、システムの状況を数値で表したデータです。まるで私たちが健康診断を受ける時に血圧、体温、心拍数を測るのと同じです。
- CPU使用率 💻
- メモリ占有率 🧠
- 1秒あたりのリクエスト数 (RPS) 📊
- エラー発生率 📈
- 応答時間 (Latency) ⏱️
メトリクスは、システムの全体的な状態を一目で把握し、「正常」範囲を逸脱した時に警告(Alert)🚨を受け取るのに非常に役立ちます。
✅ 長所: システムのマクロなトレンドと異常兆候を素早く検知できる。
❌ 短所: 「何が(What)」問題なのかは教えてくれるが、「なぜ(Why)」そうなったのかは教えてくれない。
“応答時間が2秒を超えた!”という事実は分かりますが、「どのリクエスト」が、「どの区間」で時間を食ったのかは分からないのです。
2. トレース: 問題の根源を探しに行く旅 🗺️
トレース(Trace)は、ユーザーからの1つのリクエストが私たちのシステムに入ってから出るまでの全行程を記録したデータです。まるで宅配便の追跡番号で自分の荷物がどこにあるか追跡するのと似ています。
リクエストがAサービスからBサービスを呼び出し、Bサービスがデータベースにクエリを投げる全ての過程と、各段階でかかった時間が詳細に記録されます。 🕵️♂️
✅ 長所: 特定のリクエストのボトルネックとエラーの根本原因を正確に特定できる。
❌ 短所: 数多くの正常なリクエストの中から、問題の原因となった「特定の」トレースを見つけ出すのが難しい。(まるで砂漠で針を探すようなもの!)
3. 魔法の連結環: メトリクスとトレースを組み合わせると起こること ✨
さて、ここが核心です。この二つをなぜ接続する必要があるのでしょうか?
“特定のメトリクス測定値に具体的なコンテキスト(文脈)を提供するため” です。
言葉だけでは難しいので、実際の状況を例に挙げてみましょう。
状況: 決済APIの応答時間が突然3秒まで跳ね上がったという通知を受け取りました!
😭 メトリクスだけを見る場合
- ダッシュボードで「決済API応答時間」グラフを確認する。
- “午後3時5分にスパイクがあったな。今は大丈夫になったかな?”と考える。
- ログファイルを漁り、午後3時5分頃にエラーログがあったかどうか推測しながら探す。(時間の無駄…)
😍 メトリクスとトレースを接続して見る場合
- ダッシュボードで「決済API応答時間」グラフを確認する。
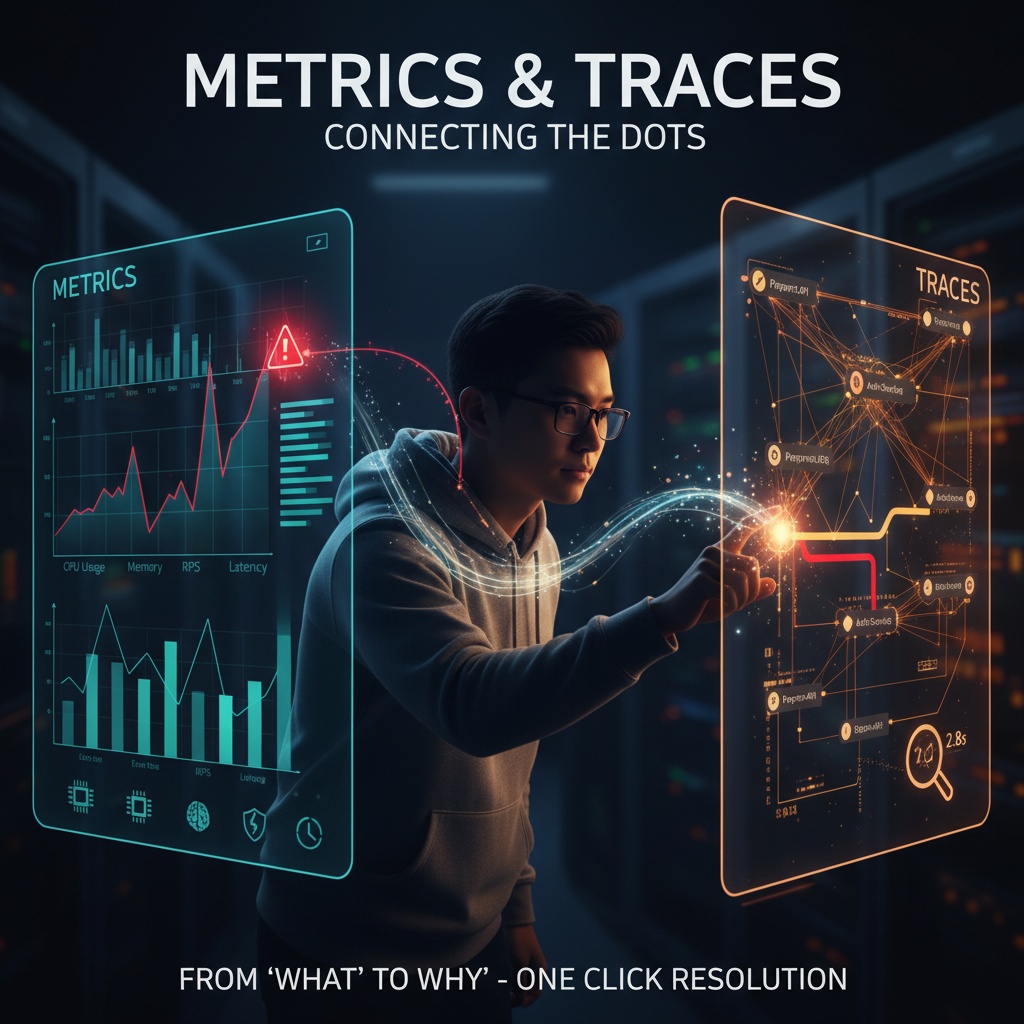
- 問題が発生した午後3時5分のスパイク地点をクリックする。 🖱️
- ワンクリックで、その時間帯に応答時間が3秒以上かかったリクエストのトレースリストがすぐに表示される! 🎯
- 最も遅かったトレースを開いてみると、「外部PG社連携」区間で2.8秒かかっていたことを即座に発見する。
- “ああ!PG社側で一時的な遅延があったのか!”とわずか数分で根本原因を把握する。 💡
このようにメトリクスとトレースを接続すると、私たちはもはや推測に頼る必要がありません。数値で示された現象(メトリクス)の裏に隠された本当の物語(トレース)を発見し、問題解決時間を劇的に短縮することができます。
結論: 「何が」から「なぜ」まで、たった一度のクリックで
これで、メトリクスとトレースはそれぞれがバラバラのデータではなく、互いを補完する最高のパートナーであることがお分かりいただけたでしょう。
- メトリクスでシステムの異常兆候である「何が」を発見し、
- 接続されたトレースを通じて根本原因である「なぜ」を掘り下げること。
これがまさに強力なオブザーバビリティ(Observability)システムの核心です。皆さんのシステムにもこの魔法のような連結環を作り、より迅速で効率的な障害対応を体験してみてください!
コメントを残す