大家好!在处理大规模数据时,您可能遇到过因意外的内存不足(Out of Memory, OOM)问题导致系统不稳定的情况。😟 今天,我们将详细了解一个非常重要的处理器——memory_limiter,它能有效预防这些令人头疼的问题。
特别是在使用memory_limiter时,有一条必须遵守的黄金法则,这条规则直接决定了系统的稳定性。
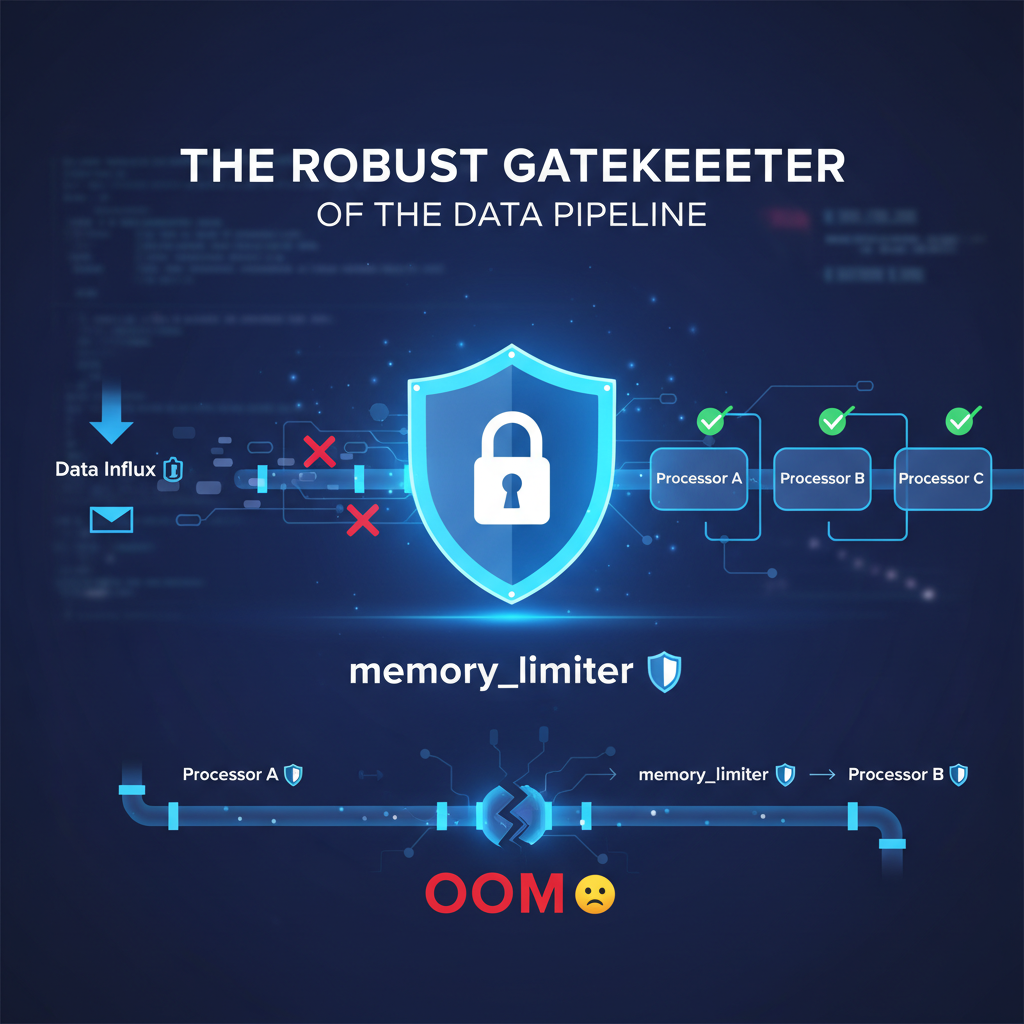
🤔 memory_limiter是什么?
将memory_limiter视为数据处理管道的“内存守卫”,这样更容易理解。
它的职责非常明确:
- 监控数据流入 📥:捕获新数据进入管道的瞬间。
- 检查内存使用量 🧐:实时查看系统当前的内存使用情况。
- 与阈值比较 ⚖️:比较是否超过了预设的内存限制(阈值)。
- 安全时 (Below Limit) ✅:安全地将数据传递给下一个处理器。
- 危险时 (Over Limit) ❌:为了保护系统,果断地删除(drop)该数据。
通过这个过程,可以防止内存过度使用,从而避免整个应用程序停止运行的可怕OOM情况。
✨ 最重要的黄金法则:“务必放在最前面!”
在memory_limiter的配置中,有一条最最最重要的规则。
memory_limiter必须被定义为所有管道中的第一个处理器。
为什么它必须是“第一个”呢?考虑其作用和操作顺序,原因就一目了然了。
✅ 正确的顺序 (The Right Way)
这是它在管道最前端充当守门员的情况。
数据流入 ➡️ [🛡️ memory_limiter] ➡️ [⚙️ 其他处理器 A] ➡️ [⚙️ 其他处理器 B]
- 数据一进入,守门员(memory_limiter)立即检查内存状态。
- 如果内存充足,它就允许数据通过,然后其他处理器(A、B)才接收数据并开始使用内存进行工作。
- 如果内存不足,数据从一开始就被阻止进入管道内部。
结果是,在其他处理器处理数据并使用内存“之前”就检测并阻止了风险,因此内存保护功能可以100%发挥作用。👍
❌ 错误的顺序 (The Wrong Way)
如果memory_limiter位于其他处理器之后会怎样呢?
数据流入 ➡️ [⚙️ 其他处理器 A] ➡️ [🛡️ memory_limiter] ➡️ [⚙️ 其他处理器 B]
- 数据进入管道后,处理器 A首先接收数据。
- 处理器 A为了处理数据,已经将数据加载到内存并使用了资源。💥
- 之后,守门员(memory_limiter)才迟迟地检查内存状态。
此时,处理器 A已经使用了内存,所以即使memory_limiter检测到内存超限,也可能为时已晚。这就像亡羊补牢一样。🤦♂️
结论
memory_limiter是维护数据管道稳定性的一个非常强大且必不可少的工具。但它的力量只有在‘正确的位置’才能发挥出来。
如果您想保护您宝贵的系统免受OOM的影响,那么在配置管道时,请务必先问自己这个问题:
“我的memory_limiter是否在最前面坚实地守护着管道?”
祝您成功构建稳定的数据管道!💪
发表回复