こんにちは!大規模なデータを処理していると、予期せぬメモリ不足(Out of Memory, OOM)問題でシステムが不安定になる経験、一度はありますよね。😟 今日は、このような厄介な問題を事前に防いでくれる非常に重要なプロセッサ、memory_limiterについて詳しく見ていきましょう。
特にmemory_limiterを使用する際には、必ず守るべき黄金律があり、このルールがシステムの安定性を左右します。
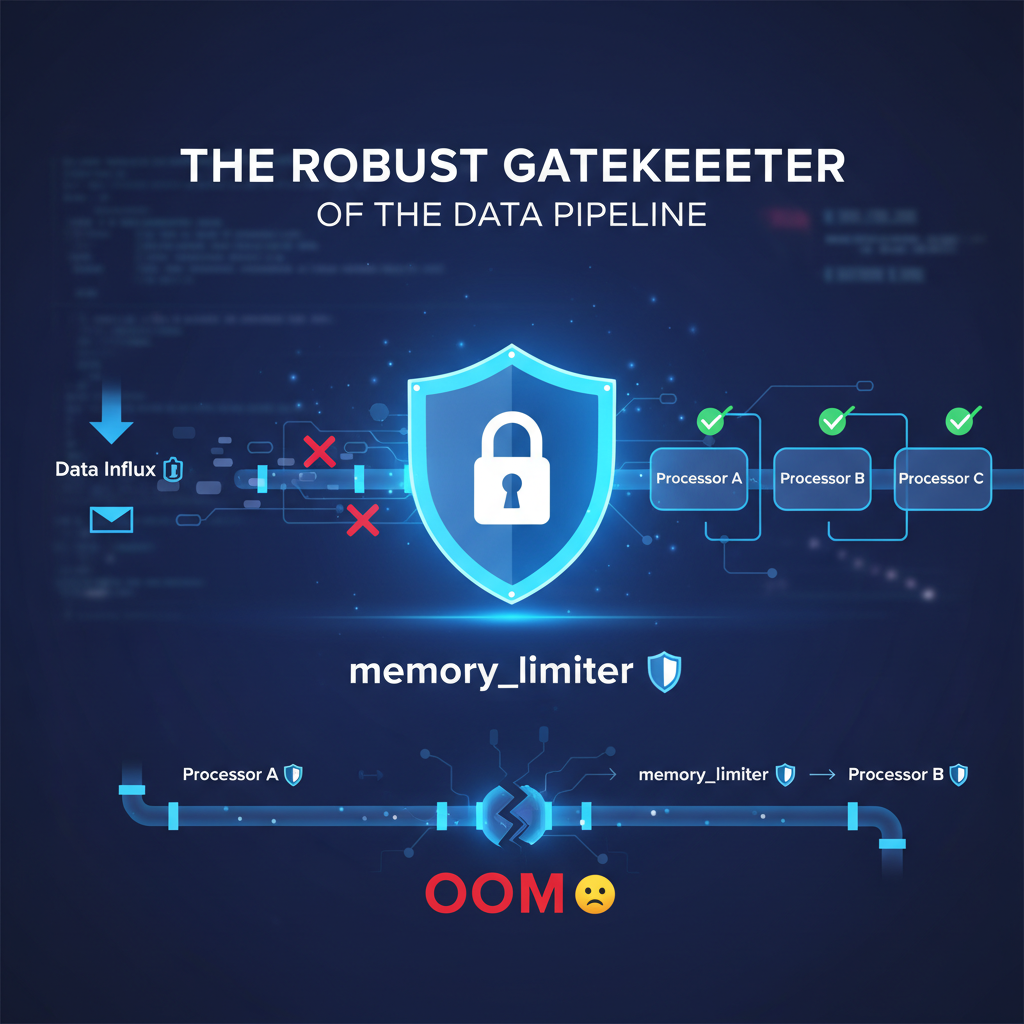
🤔 memory_limiterとは何でしょうか?
memory_limiterは、データ処理パイプラインの「メモリ警備員」だと考えると理解しやすいでしょう。
この役割は非常に明確です。
- データ流入監視 📥: 新しいデータがパイプラインに入ってくる瞬間を捉えます。
- メモリ使用量チェック 🧐: 現在のシステムのメモリ使用量をリアルタイムで確認します。
- 閾値と比較 ⚖️: 事前に設定しておいたメモリの限界(閾値)を超えているか比較します。
- 安全な場合 (Below Limit) ✅: データを次のプロセッサへ安全に通過させます。
- 危険な場合 (Over Limit) ❌: システム保護のため、該当データを果敢に削除(drop)します。
この過程を通じて、メモリが過度に使用されるのを防ぎ、アプリケーション全体が停止する恐ろしいOOM状況を予防することができます。
✨ 最も重要な黄金律: 「必ず一番前に!」
memory_limiterの設定において、最も、最も、最も重要なルールがあります。
memory_limiterは、必ずすべてのパイプラインの最初のプロセッサとして定義されなければなりません。
なぜ必ず「最初」でなければならないのでしょうか?その理由は、役割と動作順序を考えると明確になります。
✅ 正しい順序 (The Right Way)
パイプラインの先頭で門番の役割をする場合です。
データ流入 ➡️ [🛡️ memory_limiter] ➡️ [⚙️ 他のプロセッサ A] ➡️ [⚙️ 他のプロセッサ B]
- データが入ってくるとすぐに門番(memory_limiter)がメモリ状態を確認します。
- メモリが十分であればデータを通過させ、その後に他のプロセッサ(A, B)がデータを受け取り、メモリを使用して作業を開始します。
- もしメモリが不足していれば、データはそもそもパイプライン内部に入ることなく遮断されます。
結果として、他のプロセッサがデータを処理しメモリを使用する「前」に危険を感知し遮断するため、メモリ保護機能が100%効果を発揮します。👍
❌ 間違った順序 (The Wrong Way)
もしmemory_limiterが他のプロセッサの後ろに位置するとどうなるでしょうか?
データ流入 ➡️ [⚙️ 他のプロセッサ A] ➡️ [🛡️ memory_limiter] ➡️ [⚙️ 他のプロセッサ B]
- データがパイプラインに入ると、プロセッサ Aが最初にデータを受け取ります。
- プロセッサ Aはデータを処理するためにすでにメモリにデータをロードし、リソースを使用します。💥
- その後に門番(memory_limiter)が遅れてメモリ状態を確認します。
この時点ではすでにプロセッサ Aがメモリを使用してしまっているため、memory_limiterがメモリ超過を発見しても、すでに手遅れである可能性があります。牛を失ってから牛舎を直すようなものです。🤦♂️
結論
memory_limiterは、データパイプラインの安定性を守る非常に強力で不可欠なツールです。しかし、その力は‘正しい位置’にあるときにのみ発揮されます。
皆さんの大切なシステムをOOMから保護したいなら、パイプラインを設定する際に常にこの質問を最初に投げかけてみてください。
「私のmemory_limiterは、一番前でしっかりとパイプラインを守っているか?」
安定したデータパイプラインの構築を応援しています!💪
コメントを残す