我们的服务发生了故障!😱 API响应延迟,并间歇性出现500错误。
- A团队打开Grafana仪表盘,检查CPU和内存指标。
- B团队连接到Kibana,搜索是否记录了错误日志。
- C团队在Jaeger UI中查看特定请求的分布式追踪(Trace)数据。
每个团队只能在各自的工具中看到碎片化的信息。“CPU短暂飙升了,但这会是直接原因吗?”“看到了错误日志,但这是由哪个请求引起的?”“这个追踪变慢的时间点和CPU峰值时间点有关系吗?”
最终,为了找到原因,多个团队聚集在一起,共享各自的屏幕,艰难地对齐时间线。故障持续时间延长,客户的不满也随之增加。
所有这些问题的核心是“工具蔓延(Tool Sprawl)”。
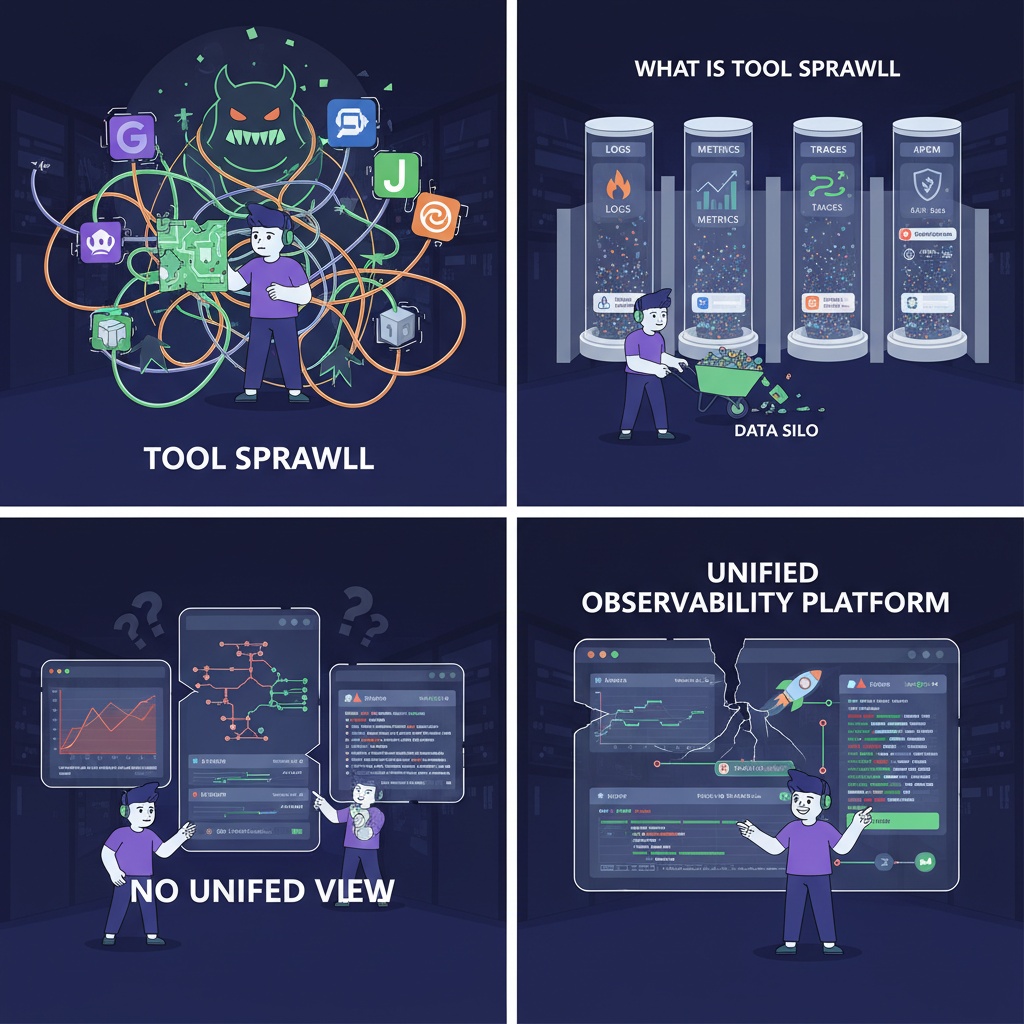
🧩 什么是工具蔓延?
工具蔓延(Tool Sprawl)顾名思义,是指“工具(Tool)无序扩散(Sprawl)”的状态。特别是在最新的MSA(微服务架构)环境中,通常会根据不同的功能和目的引入各种技术栈、开源和SaaS解决方案。
- 日志收集: ELK Stack (Elasticsearch, Logstash, Kibana)
- 指标收集/监控: Prometheus, Grafana
- 分布式追踪: Jaeger, Zipkin
- APM: Datadog, New Relic
每个工具在特定领域表现出色,但如果组织整体缺乏整合策略而引入,就会导致数据被困在各个工具中的“数据孤岛(Data Silo)”现象。
这正是工具蔓延所引发的最致命问题。
🔗 最大的问题:缺乏“统一视图(Unified View)”
尽管工具蔓延有许多缺点(成本增加、学习曲线等),但在运营环境中,最令人痛苦的是无法一目了然地看到系统整体状态的“统一视图”。
当数据分散在多个工具中时,你可以看到单个数据片段,但很难将这些片段连接起来,形成整体图景(Big Picture)。
😠 实际故障情况下的困难
例如,让我们来看看解决“API变慢”问题的过程。
1. 检查指标 (Prometheus/Grafana) 首先,通过指标发现“api-gateway”服务的http_requests_latency_seconds急剧增加。
# Prometheus 告警规则
- alert: HighApiLatency
  expr: histogram_quantile(0.99, sum(rate(http_requests_latency_seconds_bucket{service="api-gateway"}[5m])) by (le)) > 2
  for: 1m
  labels:
    severity: critical
  annotations:
    summary: "High API Latency on api-gateway"
    description: "The 99th percentile latency for api-gateway is over 2s."
2. 检查分布式追踪 (Jaeger) 接下来,为了查明变慢的原因,我们转到Jaeger。搜索该时间段的追踪,找到了一个异常缓慢的请求。
Trace ID: a1b2c3d4e5f6
// 原始追踪数据(简化版)
{
  "traceID": "a1b2c3d4e5f6",
  "spans": [
    {
      "spanID": "span1",
      "operationName": "HTTP GET /api/user",
      "startTime": 1767282061000,
      "duration": 2150, // 2.15秒,非常慢!
      "tags": [{"key": "http.status_code", "value": 200}]
    },
    {
      "spanID": "span2",
      "parentSpanID": "span1",
      "operationName": "Call to user-service",
      "startTime": 1767282061100,
      "duration": 2000 // 此内部调用占据了大部分时间
    },
    {
      "spanID": "span3",
      "parentSpanID": "span2",
      "operationName": "DB Query: SELECT * FROM users",
      "startTime": 1767282061500,
      "duration": 1500 // 数据库查询似乎是问题的原因
    }
  ]
}
3. 检查日志 (Kibana) 查看追踪,发现user-service的数据库查询似乎很慢。为了查明确切原因,我们手动复制Trace ID并粘贴到Kibana搜索框中。
// 原始日志数据(在Elasticsearch中)
{
  "@timestamp": "2025-11-04T08:41:02.550Z",
  "log.level": "ERROR",
  "service.name": "user-service",
  "message": "DB Connection Pool exhausted. Waited 1200ms for connection.",
  "trace.id": "a1b2c3d4e5f6", // 通过此ID才找到关联
  "transaction.id": "t9y8x7w6"
}
终于找到了原因。是数据库连接池耗尽问题。
然而,在此过程中,工程师必须在三个不同的工具(Grafana、Jaeger、Kibana)之间来回切换,适应不同的UI和查询语言,并切换上下文。这正是缺乏统一视图所造成的低效率。在故障情况下,时间紧迫,但大部分时间都浪费在数据探索以查明原因上。
🤔 其他问题不重要吗?
当然,工具蔓延也会引发其他问题。但为什么“缺乏统一视图”是最核心的问题呢?
- “多个工具的许可和维护成本是最大的问题”(❌)
- 当然,成本💰是一个重要因素。但由于故障导致的服务中断给业务带来的损失(客户流失、信任度下降、收入减少)往往远远超过许可成本。从技术角度来看,阻碍问题解决能力才是更本质的问题。
- “工程师需要学习多种工具的学习曲线是最大的问题”(❌)
- 这无疑也是一个缺点📚。但是,即使假设所有工程师都精通所有工具,只要数据是分散的,“在工具之间来回切换的低效工作流程”本身就无法解决。问题的本质不在于个人熟练度,而在于系统化的低效率。
✨ 结论:应着眼于整体而非碎片
随着服务变得越来越复杂,我们不能再仅仅依靠单独的日志、指标和追踪数据来理解整个系统的运行情况。工具蔓延将这些数据碎片化,使得难以发现相关性,并导致我们错过解决问题的黄金时间。
为了成功的系统运营和稳定的服务,我们必须致力于构建一个集成可观测性(Observability)平台,该平台能够自动连接分散的数据碎片,并在一个屏幕上理解有机流程(日志 ↔ 指标 ↔ 追踪)。这是摆脱工具蔓延陷阱的第一步。🚀
发表回复