私たちのサービスで障害が発生しました!😱 API応答が遅延し、断続的に500エラーが発生しています。
- AチームはGrafanaダッシュボードを開き、CPUとメモリのメトリックを確認します。
- BチームはKibanaに接続し、エラーログが記録されているか検索します。
- CチームはJaeger UIで特定の要求の分散トレーシング(Trace)データを調べます。
各チームはそれぞれのツールで断片的な情報しか見ることができません。「CPUが一時的に跳ね上がったけど、これが直接の原因だろうか?」「エラーログは見えるけど、どのリクエストが原因で発生したんだろう?」「このトレースが遅くなった時点とCPUスパイクの時点に関連性はあるのか?」
結局、原因を特定するために複数のチームが集まり、それぞれが見ている画面を共有しながらタイムラインを合わせるという困難なプロセスを経ます。障害は長引き、顧客の不満は募るばかりです。
これらすべての問題の中心には、「ツールスプロール(Tool Sprawl)」があります。
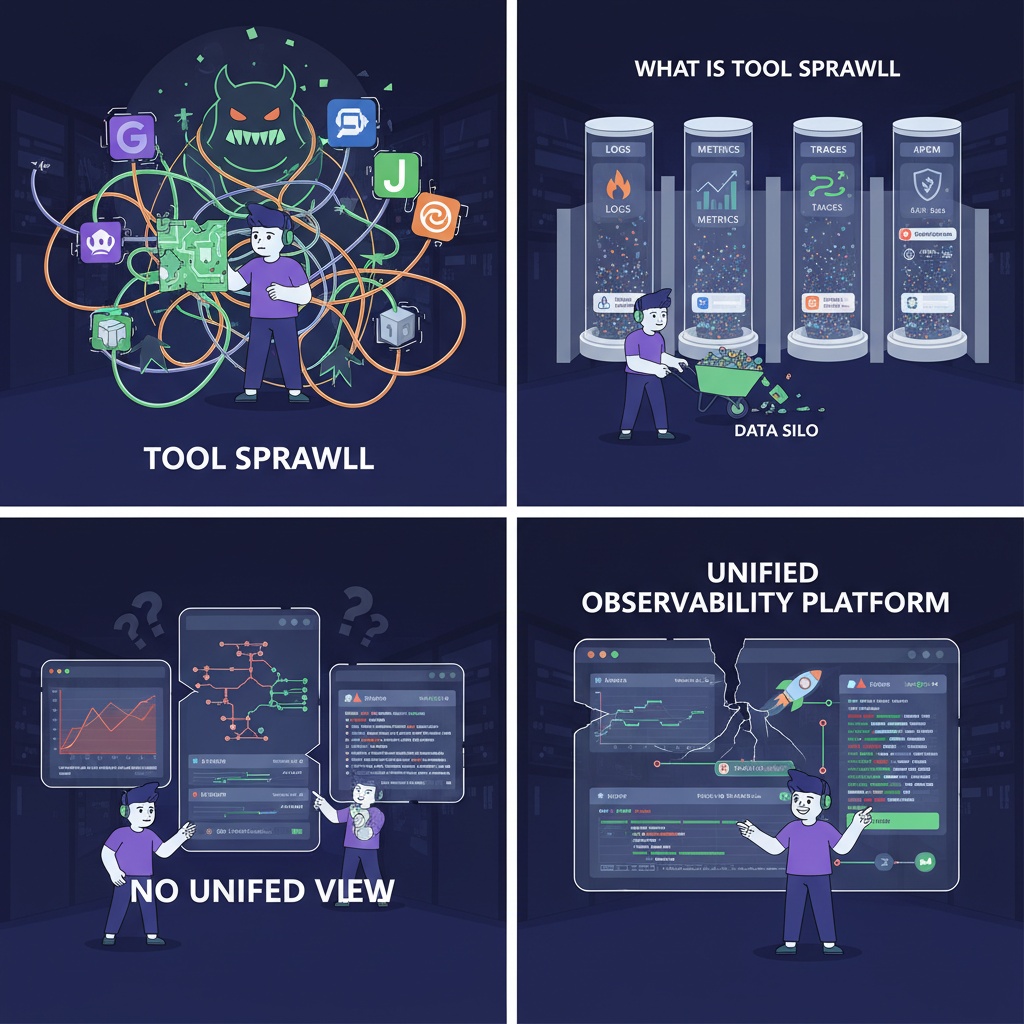
🧩 ツールスプロールとは何でしょうか?
ツールスプロール(Tool Sprawl)は、文字通り「ツール(Tool)が無秩序に拡散(Sprawl)した」状態を意味します。特に最新のMSA(Microservice Architecture)環境では、各機能と目的に応じて多様な技術スタックやオープンソース、SaaSソリューションを導入するケースが多く見られます。
- ログ収集: ELK Stack (Elasticsearch, Logstash, Kibana)
- メトリック収集/監視: Prometheus, Grafana
- 分散トレーシング: Jaeger, Zipkin
- APM: Datadog, New Relic
それぞれのツールは特定の領域で優れた性能を発揮しますが、組織全体で統合戦略なしに導入されると、データが各ツールに閉じ込められる「データサイロ(Data Silo)」現象を引き起こします。
これがツールスプロールが引き起こす最も致命的な問題です。
🔗 最大の問題:「統合されたビュー(Unified View)」の欠如
ツールスプロールにはいくつかの欠点(コスト増加、学習曲線など)がありますが、運用環境で最も苦痛なのは、システムの全体的な状態を一目で把握できる「統合されたビュー」がないことです。
データが複数のツールに分散していると、個々のデータ断片は見ることができますが、それらの断片を接続して全体像(Big Picture)を描くことは非常に困難です。
😠 実際の障害状況での困難
例えば、「遅延したAPI」の問題を解決するプロセスを追ってみましょう。
1. メトリックの確認 (Prometheus/Grafana) まず、メトリックを通じて「api-gateway」サービスのhttp_requests_latency_secondsが急増していることを発見します。
# Prometheus アラートルール
- alert: HighApiLatency
  expr: histogram_quantile(0.99, sum(rate(http_requests_latency_seconds_bucket{service="api-gateway"}[5m])) by (le)) > 2
  for: 1m
  labels:
    severity: critical
  annotations:
    summary: "High API Latency on api-gateway"
    description: "The 99th percentile latency for api-gateway is over 2s."
2. 分散トレーシングの確認 (Jaeger) 次に、なぜ遅くなったのかを確認するためにJaegerに移動します。該当時間帯のトレースを検索し、特に遅いリクエストを見つけました。
Trace ID: a1b2c3d4e5f6
// 生のトレースデータ(簡易版)
{
  "traceID": "a1b2c3d4e5f6",
  "spans": [
    {
      "spanID": "span1",
      "operationName": "HTTP GET /api/user",
      "startTime": 1767282061000,
      "duration": 2150, // 2.15秒、非常に遅い!
      "tags": [{"key": "http.status_code", "value": 200}]
    },
    {
      "spanID": "span2",
      "parentSpanID": "span1",
      "operationName": "Call to user-service",
      "startTime": 1767282061100,
      "duration": 2000 // この内部呼び出しがほとんどの時間を占めている
    },
    {
      "spanID": "span3",
      "parentSpanID": "span2",
      "operationName": "DB Query: SELECT * FROM users",
      "startTime": 1767282061500,
      "duration": 1500 // DBクエリが問題の原因と思われる
    }
  ]
}
3. ログの確認 (Kibana) トレースを見ると、user-serviceのDBクエリが遅いようです。正確な原因を特定するために、手動でTrace IDをコピーし、Kibanaの検索バーに貼り付けます。
// 生のログデータ(Elasticsearch内)
{
  "@timestamp": "2025-11-04T08:41:02.550Z",
  "log.level": "ERROR",
  "service.name": "user-service",
  "message": "DB Connection Pool exhausted. Waited 1200ms for connection.",
  "trace.id": "a1b2c3d4e5f6", // このIDを通じてようやく関連性を見つけた
  "transaction.id": "t9y8x7w6"
}
ついに原因が判明しました。DBコネクションプールの枯渇問題でした。
しかし、このプロセスでエンジニアは3つの異なるツール(Grafana、Jaeger、Kibana)を行き来し、それぞれ異なるUIとクエリ言語に合わせてコンテキストを切り替える必要がありました。これこそが統合されたビューの欠如が生み出す非効率性です。障害状況では一刻を争うのに、原因究明のためのデータ探索にほとんどの時間を費やしてしまいます。
🤔 他の問題は重要ではないのでしょうか?
もちろん、ツールスプロールは他の問題も引き起こします。しかし、なぜ「統合されたビューの欠如」が最も核心的なのでしょうか?
- 「複数のツールのライセンスおよび保守費用が最大の問題だ」(❌)
- もちろん、コスト💰は重要な要素です。しかし、障害によるサービス停止がビジネスに与える損失(顧客離れ、信頼度低下、売上減少)は、ライセンス費用をはるかに上回ることが多いです。技術的な観点から、問題解決能力を阻害することの方がより本質的な問題です。
- 「エンジニアが複数のツールを学ぶ学習曲線が最大の問題だ」(❌)
- これも確かに欠点です📚。しかし、すべてのエンジニアがすべてのツールに習熟していると仮定しても、データが分散している限り、「ツール間を行き来する非効率なワークフロー」自体は解決されません。問題の本質は個人の熟練度ではなく、システム化された非効率性にあります。
✨ 結論:断片ではなく全体を見るべきです
サービスが複雑になるにつれて、私たちはもはや個別のログ、メトリック、トレースデータだけではシステム全体の動作を理解することはできません。ツールスプロールはこれらのデータを断片化し、相関関係の把握を困難にし、問題解決のゴールデンタイムを逃させてしまいます。
成功的なシステム運用と安定したサービスのためには、散らばったデータ断片を自動的に接続し、一つの画面で有機的な流れ(ログ ↔ メトリック ↔ トレース)を把握できる統合されたオブザーバビリティ(Observability)プラットフォームを目指すべきです。これこそがツールスプロールという罠から抜け出す第一歩です。🚀
コメントを残す